
Slik installerer du Hadoop på UbuntuNedlastings- og oppsetttrinn
 Prafulla Ranadive
⚡ Smart oppsummering
Installere Apache Hadoop på Ubuntu tar to omganger: pakk ut utgivelsen under en dedikert systemkonto med passordløs SSH, rediger deretter fire XML-filer før du formaterer HDFS og starter enkeltnodeklyngen.
I denne veiledningen vil vi ta deg gjennom den trinnvise prosessen for å installere Apache Hadoop på en Linux-maskin (Ubuntu). Dette er en todelt prosess: først last ned og installer utgivelsen, deretter konfigurer den.
Det er to forutsetninger:
- Du må ha Ubuntu installerte og løping.
- Du må ha Java installerte.
Hadoop 3.x-versjonsnotater for dette oppsettet
Skjermbildene i denne gjennomgangen ble tatt med Hadoop 2.2.0. Trinnrekkefølgen er uendret i nåværende versjoner, men en håndfull navn og standardinnstillinger har blitt flyttet. Sjekk tabellen nedenfor før du kopierer noen kommando ordrett.
| Innstilling eller trinn | I denne veiledningen (Hadoop 2.x) | Nåværende Hadoop 3.x |
|---|---|---|
| Utgivelsesarkiv | hadoop-2.2.0.tar.gz |
hadoop-3.5.0.tar.gz, den første stabile 3.5-utgivelsen, publisert 2. april 2026 |
| Standard filsystemegenskap | fs.default.name i prosaen, fs.defaultFS i XML-filen |
fs.defaultFS bare; fs.default.name er utdatert |
| MapReduce-egenskapen | mapreduce.jobtracker.address |
mapreduce.framework.name satt til yarn; jobbenTracker eksisterer ikke lenger når YARN planlegger arbeidet |
| mapred-site.xml | Kopiert fra mapred-site.xml.template |
Sender inn etc/hadoop allerede, så kopieringstrinnet er unødvendig |
| NameNode web UI-port | 50070 | 9870 |
| Java | Java 6 eller Java 7 | Java 8 eller Java 11 |
Alt annet i denne veiledningen oppfører seg på samme måte på Hadoop 3: den dedikerte kontoen, SSH-nøkkelen, de fire konfigurasjonsfilene og start- og stoppskriptene.
Del 1) Last ned og installer Hadoop
Trinn 1) Legg til en Hadoop-systembruker
Legg til en Hadoop-systembruker ved å bruke kommandoen nedenfor.
sudo addgroup hadoop_

sudo adduser --ingroup hadoop_ hduser_
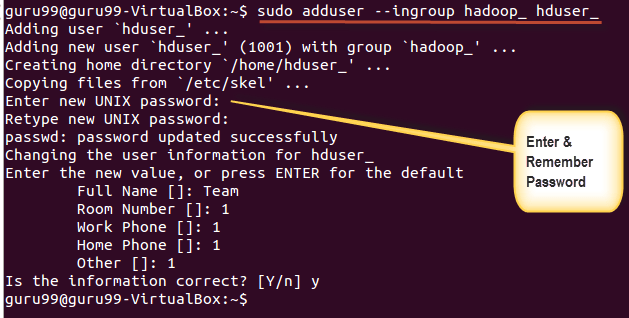
Skriv inn passord, navn og andre detaljer.
NOTAT: Det er en mulighet for feilen nevnt nedenfor i denne oppsetts- og installasjonsprosessen.
"hduser er ikke i sudoers-filen. Denne hendelsen vil bli rapportert."

Denne feilen kan løses ved å logge inn som root-bruker.
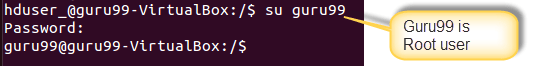
Utfør kommandoen
sudo adduser hduser_ sudo

Re-login as hduser_

Trinn 2) Konfigurer SSH
For å administrere noder i en klynge krever Hadoop SSH-tilgang.
Bytt bruker først, skriv inn følgende kommando
su - hduser_

Denne kommandoen vil opprette en ny nøkkel.
ssh-keygen -t rsa -P ""

Aktiver SSH-tilgang til den lokale maskinen med denne nøkkelen.
cat $HOME/.ssh/id_rsa.pub >> $HOME/.ssh/authorized_keys

Test nå SSH-oppsettet ved å koble til localhost som 'hduser_'-brukeren.
ssh localhost

OBS: Hvis du ser feilen nedenfor som svar på «ssh localhost», er det mulig at SSH ikke er tilgjengelig på dette systemet.

For å løse dette –
Tøm SSH ved å bruke,
sudo apt-get purge openssh-server
Det er god praksis å rense før installasjonen starter.

Installer SSH ved å bruke kommandoen-
sudo apt-get install openssh-server

Trinn 3) Last ned Hadoop
Neste steg er å laste ned Hadoop fra Apache Hadoop-utgivelsesside.

Velg Stabil

Velg tar.gz-filen (ikke filen som slutter på src).

Når nedlastingen er fullført, naviger til mappen som inneholder tar-filen.

Enter,
sudo tar xzf hadoop-2.2.0.tar.gz

Gi nå hadoop-2.2.0 nytt navn til hadoop.
sudo mv hadoop-2.2.0 hadoop

Til slutt, overlat mappen til den nye kontoen.
sudo chown -R hduser_:hadoop_ hadoop

Erstatt versjonen du faktisk lastet ned med hadoop-2.2.0 i de tre kommandoene ovenfor.
Del 2) Konfigurer Hadoop
Trinn 1) Endre ~/.bashrc-filen
Legg til følgende linjer på slutten av filen ~/.bashrc.
#Set HADOOP_HOME
export HADOOP_HOME=<Installation Directory of Hadoop>
#Set JAVA_HOME
export JAVA_HOME=<Installation Directory of Java>
# Add bin/ directory of Hadoop to PATH
export PATH=$PATH:$HADOOP_HOME/bin
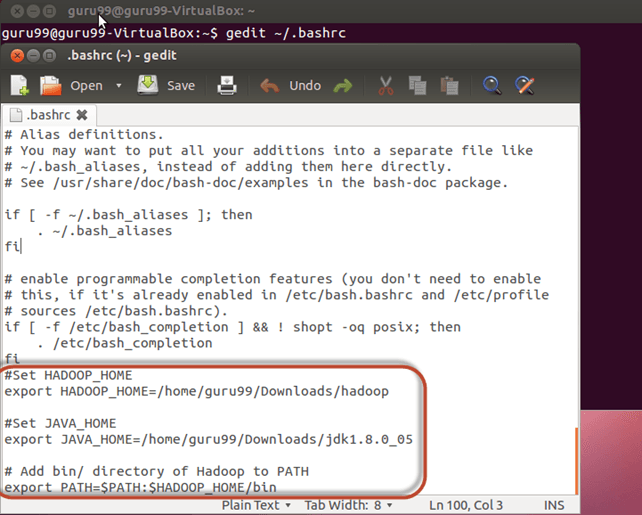
Nå, bruk kommandoen nedenfor til å opprette kildekode for denne miljøkonfigurasjonen.
. ~/.bashrc

Trinn 2) Konfigurasjoner relatert til HDFS
Sett JAVA_HOME i filen $HADOOP_HOME/etc/hadoop/hadoop-env.sh, som vist nedenfor.


Med

Det er to parametere i $HADOOP_HOME/etc/hadoop/core-site.xml som må settes-
1. 'hadoop.tmp.dir' – Brukes til å angi en katalog som skal brukes av Hadoop til å lagre datafilene.
2. 'fs.defaultFS' – Dette angir standard filsystem. Det eldre navnet for den samme egenskapen, 'fs.default.name', er utdatert.
For å angi disse parameterne, åpne core-site.xml
sudo gedit $HADOOP_HOME/etc/hadoop/core-site.xml

Kopier linjene nedenfor mellom tagger.
<property>
<name>hadoop.tmp.dir</name>
<value>/app/hadoop/tmp</value>
<description>Parent directory for other temporary directories.</description>
</property>
<property>
<name>fs.defaultFS </name>
<value>hdfs://localhost:54310</value>
<description>The name of the default file system. </description>
</property>

Naviger til katalogen $HADOOP_HOME/etc/hadoop.

Opprett nå mappen som er nevnt i core-site.xml.
sudo mkdir -p <Path of Directory used in above setting>

Gi tillatelser til katalogen.
sudo chown -R hduser_:Hadoop_ <Path of Directory created in above step>

sudo chmod 750 <Path of Directory created in above step>

Trinn 3) MapReduce-konfigurasjon
Før du begynner med disse konfigurasjonene, la oss angi HADOOP_HOME-banen.
sudo gedit /etc/profile.d/hadoop.sh
Og Enter
export HADOOP_HOME=/home/guru99/Downloads/Hadoop

Neste inn
sudo chmod +x /etc/profile.d/hadoop.sh

Gå ut av terminalen og start den på nytt.
Skriv inn echo $HADOOP_HOME for å bekrefte banen.

Kopier nå filer
sudo cp $HADOOP_HOME/etc/hadoop/mapred-site.xml.template $HADOOP_HOME/etc/hadoop/mapred-site.xml

Åpne mapred-site.xml-filen
sudo gedit $HADOOP_HOME/etc/hadoop/mapred-site.xml

Legg til innstillingene nedenfor mellom og tagger.
<property>
<name>mapreduce.jobtracker.address</name>
<value>localhost:54311</value>
<description>MapReduce job tracker runs at this host and port.
</description>
</property>

Åpne $HADOOP_HOME/etc/hadoop/hdfs-site.xml som vist nedenfor,
sudo gedit $HADOOP_HOME/etc/hadoop/hdfs-site.xml

Legg til innstillingene nedenfor mellom og tagger.
<property>
<name>dfs.replication</name>
<value>1</value>
<description>Default block replication.</description>
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>/home/hduser_/hdfs</value>
</property>

Opprett mappen som er angitt i innstillingen ovenfor.
sudo mkdir -p <Path of Directory used in above setting>
sudo mkdir -p /home/hduser_/hdfs

Gi deretter eierskap og tillatelser til den.
sudo chown -R hduser_:hadoop_ <Path of Directory created in above step>
sudo chown -R hduser_:hadoop_ /home/hduser_/hdfs

sudo chmod 750 <Path of Directory created in above step>
sudo chmod 750 /home/hduser_/hdfs

Trinn 4) Formater HDFS
Før vi starter Hadoop for første gang, formaterer du HDFS ved hjelp av kommandoen nedenfor.
$HADOOP_HOME/bin/hdfs namenode -format

Trinn 5) Start Hadoop-klyngen med én node
Start Hadoop-klyngen for én node ved hjelp av kommandoen nedenfor.
$HADOOP_HOME/sbin/start-dfs.sh
Resultatet av kommandoen ovenfor vises nedenfor.

Start deretter YARN-daemonene.
$HADOOP_HOME/sbin/start-yarn.sh

Bruk verktøyet «jps» til å bekrefte om alle Hadoop-relaterte prosesser kjører.
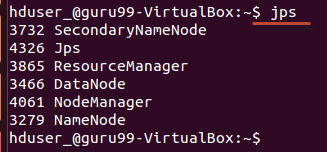
Hvis Hadoop har startet uten problemer, skal jps-utdataene vise NameNode, NodeManager, ResourceManager, SecondaryNameNode og DataNode.
Trinn 6) Stoppping Hadoop
Slå av klyngen i motsatt rekkefølge.
$HADOOP_HOME/sbin/stop-dfs.sh

$HADOOP_HOME/sbin/stop-yarn.sh

Slik bekrefter du at Hadoop kjører og retter vanlige feil
jps-utdataene bekrefter at prosesser har startet, men ikke at klyngen er brukbar. Fire ekstra kontroller avgjør det spørsmålet.
- Åpne NameNode-nettgrensesnittet på
http://localhost:9870(port 50070 på Hadoop 2.x) og bekreft sammendragsrapportene for én aktiv node. - Åpne ResourceManager-grensesnittet på
http://localhost:8088for å bekrefte at YARN aksepterte NodeManager. - Kjør
hdfs dfsadmin -reportfor kapasitet, levende DataNodes og eventuelle underreplikerte blokker. - Skriv noe:
hdfs dfs -mkdir /testetterfulgt avhdfs dfs -ls /beviser at navnerommet aksepterer endringer.
De fleste førstegangsfeil faller inn under en av fem kategorier.
| Symptom | Årsak | Fix |
|---|---|---|
| JAVA_HOME er ikke satt og ble ikke funnet | Variabelen eksporteres i .bashrc, men ikke i hadoop-env.sh | Angi også den absolutte JDK-banen i hadoop-env.sh |
| Tillatelse nektet (offentlig nøkkel, passord) på ssh localhost | authorized_keys mangler eller er for permissiv | Legg til id_rsa.pub på nytt, og kjør deretter chmod 600 på ~/.ssh/authorized_keys |
| Tilkobling avvist på port 22 | openssh-serveren er ikke installert eller kjører ikke | Installer openssh-server og start ssh-tjenesten |
| DataNode mangler fra jps etter en omformatering | Cluster ID-avvik mellom den formaterte NameNode og den gamle DataNode-katalogen | Tøm mappen dfs.datanode.data.dir, og formater deretter på nytt |
| start-dfs.sh: kommandoen ble ikke funnet | HADOOP_HOME og PATH ble aldri hentet fra kildekoden i det nåværende skallet | Kjør .~/.bashrc eller åpne en ny terminal |
