
Apache Oozie-opplæring: Arbeidsflytdiagram, planlegger
 Prafulla Ranadive
⚡ Smart oppsummering
Apache Oozie er arbeidsflytplanleggeren for Hadoop som kjører avhengige jobber som rettede asykliske grafer, og kombinerer en arbeidsflytmotor for MapReduce-, Pig- og Hive-handlinger med en koordinatormotor drevet av tid og datatilgjengelighet.
Hva er Apache Oozie?
Apache Oozie er en arbeidsflytplanlegger for HadoopDet er et system som kjører arbeidsflyten til avhengige jobber. Her kan brukere lage rettede asykliske grafer av arbeidsflyter, som kan kjøres parallelt og sekvensielt i Hadoop.
Den består av to deler:
- Arbeidsflytmotor: Ansvaret til en arbeidsflytmotor er å lagre og kjøre arbeidsflyter som består av Hadoop-jobber, f.eks. MapReduce, Pig, Hive.
- Koordinatormotor: Den kjører arbeidsflytjobber basert på forhåndsdefinerte tidsplaner og tilgjengelighet av data.
Oozie er skalerbar og kan håndtere rettidig utførelse av tusenvis av arbeidsflyter (hver bestående av dusinvis av jobber) i en Hadoop-klynge. Diagrammet nedenfor viser hvor planleggeren befinner seg i forhold til klyngen og jobbene den driver.

Oozie er også veldig fleksibel. Man kan enkelt starte, stoppe, suspendere og kjøre jobber på nytt. Oozie gjør det veldig enkelt å kjøre mislykkede arbeidsflyter på nytt. Man kan lett forstå hvor vanskelig det kan være å ta igjen tapte eller mislykkede jobber på grunn av nedetid eller feil. Det er til og med mulig å hoppe over en spesifikk mislykket node.
Prosjektstatus: Apache Oozie ble pensjonert av Apache Software Foundation i februar 2025 og flyttingen til Apache-loftet fullført i april 2025. Den endelige utgivelsen er fortsatt 5.2.1 fra februar 2021, og kildekode-arkivet er nå skrivebeskyttet. Eksisterende klynger kjører det fortsatt, og det er derfor mekanikken nedenfor er verdt å kjenne til, men nye pipelines bygges vanligvis på Apache Airflow.
Hvordan fungerer Oozie?
Oozie kjører som en tjeneste i klyngen, og klienter sender inn arbeidsflytdefinisjoner for umiddelbar eller senere behandling.
En Oozie-arbeidsflyt består av handlingsnoder og kontrollflytnoder.
En handlingsnode representerer en arbeidsflytoppgave, f.eks. å flytte filer til HDFS, kjører en MapReduce-, Pig- eller Hive-jobb, importerer data ved hjelp av Sqoop, eller kjøre et skallskript eller et program skrevet i Java.
En kontrollflytnode styrer arbeidsflytutførelsen mellom handlinger ved å tillate konstruksjoner som betinget logikk, der forskjellige grener kan følges avhengig av resultatet av en tidligere handlingsnode.
Startnode, sluttnode og feilnode faller inn under denne kategorien av noder.
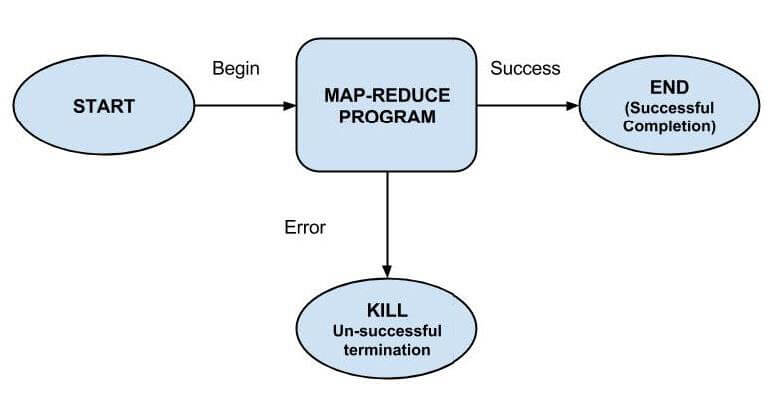
- Start node angir starten på arbeidsflytjobben.
- Slutt node signaliserer slutten på jobben.
- Feil node angir forekomsten av en feil og den tilhørende feilmeldingen som skal skrives ut.
På slutten av utførelsen av en arbeidsflyt bruker Oozie en HTTP-tilbakekall for å oppdatere klienten med arbeidsflytstatusen. Å gå inn i eller ut av en handlingsnode kan også utløse tilbakekallingen.
Oozie-kontrollnoder og handlingstyper
Utover start, slutt og feil, støtter arbeidsflyt-XML et lite vokabular med kontrollnoder som former grafen.
- beslutning: Evaluerer et uttrykk og sender arbeidsflyten nedover en av flere grener, tilsvarende en switch-setning.
- gaffel: Deler banen slik at to eller flere handlinger kjører parallelt.
- bli med: Venter til hver gren av en matchende gaffel er ferdig før den fortsetter.
- drepe: Avslutter arbeidsflyten umiddelbart og registrerer feilmeldingen.
Handlingsnoder dekker selve arbeidet, og hver har sitt eget XML-element:
- kart-reduksjon, gris, hive og sqoop handlingene starter den tilsvarende Hadoop-jobben.
- Java kjører en hovedklasse på klyngen; shell og ssh kjøre skript.
- fs utfører HDFS-hushjelpping som for eksempel flytt, slett, mkdir og chmod.
- emalje varsler mottakerne, og delarbeidsflyt kaller et annet arbeidsflytprogram.
Eksempel på arbeidsflytdiagram
Diagrammet nedenfor tracoppretter en liten arbeidsflyt fra startnoden, gjennom en MapReduce-handling, til enten sluttnoden eller feilbanen når handlingen mislykkes.
Typer Oozie-jobber
Oozie beskriver arbeid på tre nivåer. Hvert lag omslutter det underliggende, slik at en pakke til syvende og sist styrer mange individuelle arbeidsflyter.
| Jobb type | Hva det definerer | Utløst av |
|---|---|---|
| Arbeidsflyt | En rettet asyklisk graf over handlings- og kontrollnoder, skrevet i workflow.xml | Manuell innsending, eller en koordinator |
| Koordinator | En gjentakende tidsplan for én arbeidsflyt, med starttid, sluttid og frekvens | Klokketid og tilgjengelighet av inndata |
| XNUMX bunk | En samling av koordinatorapplikasjoner som administreres sammen som én dataledning | Et oppstartstidspunkt ble brukt for alle koordinatorene |
Skillet er viktig i praksis: en arbeidsflyt svarer på «hva som kjører», en koordinator svarer på «når det kjører», og en pakke svarer på «hva som starter og stopper sammen».
Pakking og distribusjon av et Oozie Workflow-program
En arbeidsflytapplikasjon består av arbeidsflytdefinisjonen og alle tilhørende ressurser, som MapReduce Jar-filer, Pig-skript osv. Applikasjoner må følge en enkel katalogstruktur og distribueres til HDFS slik at Oozie kan få tilgang til dem.
Et eksempel på en katalogstruktur vises nedenfor:
<name of workflow>/
├── lib/
│   └── hadoop-examples.jar
└── workflow.xml
Det er nødvendig å oppbevare workflow.xml (en definisjonsfil for arbeidsflyt) i toppnivåkatalogen (den overordnede katalogen som inneholder arbeidsflytnavnet). Lib-katalogen inneholder Jar-filer som inneholder MapReduce-klasser. En arbeidsflytapplikasjon som samsvarer med denne layouten kan bygges med et hvilket som helst byggeverktøy, f.eks. Ant eller Maven.
En slik bygging må kopieres til HDFS ved hjelp av en kommando, for eksempel:
% hadoop fs -put hadoop-examples/target/<name of workflow dir> name of workflow
Fremgangsmåte for å kjøre en Oozie-arbeidsflytjobb
I denne delen vil vi se hvordan du kjører en arbeidsflytjobb. For å kjøre dette bruker vi Oozie-kommandolinjeverktøyet (et klientprogram som kommuniserer med Oozie-serveren).
1. Eksporter OOZIE_URL miljøvariabel, som forteller oozie-kommandoen hvilken Oozie-server den skal bruke (her bruker vi en som kjører lokalt):
% export OOZIE_URL="http://localhost:11000/oozie"
2. Kjør arbeidsflytjobben ved å bruke:
% oozie job -config ch05/src/main/resources/max-temp-workflow.properties -run
Alternativet -config refererer til en lokal Java egenskapsfil som inneholder definisjoner for parameterne i arbeidsflytens XML-fil, samt oozie.wf.application.path, som forteller Oozie plasseringen av arbeidsflytapplikasjonen i HDFS.
Eksempelinnhold i egenskapsfilen:
nameNode=hdfs://localhost:8020
jobTracker=localhost:8021
oozie.wf.application.path=${nameNode}/user/${user.name}/<name of workflow>
3. Få statusen til arbeidsflytjobben.
Statusen til en arbeidsflytjobb kan sees ved å bruke underkommandoen 'job' med alternativet '-info', der jobb-ID-en angis etter '-info'.
e.g., % oozie job -info <job id>
Utdataene viser en status som er en av KJØRER, DØDT eller LYKKES.
4. Resultater av vellykket arbeidsflytutførelse kan sees ved hjelp av en Hadoop-kommando som:
% hadoop fs -cat <location of result>
Hvorfor bruke Oozie?
Hovedformålet med å bruke Oozie er å administrere ulike typer jobber som behandles i et Hadoop-system.
Avhengigheter mellom jobber spesifiseres av en bruker i form av rettede asykliske grafer. Oozie bruker denne informasjonen og sørger for at de utføres i riktig rekkefølge som spesifisert i en arbeidsflyt. På den måten sparer brukeren tid til å administrere en komplett arbeidsflyt. I tillegg har Oozie en funksjon for å spesifisere utførelsesfrekvensen for en bestemt jobb.
Funksjoner av Oozie
- Oozie har et klient-API og et kommandolinjegrensesnitt som kan brukes til å starte, kontrollere og overvåke jobber fra en Java søknad.
- Ved å bruke webtjeneste-API-ene kan man kontrollere jobber hvor som helst.
- Oozie har en bestemmelse om å utføre jobber som er planlagt å kjøre med jevne mellomrom.
- Oozie har en bestemmelse om å sende e-postvarsler når jobber er fullført.
Oozie vs. Apache Airflow
Fordi Oozie er pensjonert, sammenligner de fleste team som evaluerer en planlegger i dag det de allerede kjører med Apache Airflow. De to verktøyene løser det samme problemet fra motsatte retninger.
| Aspekt | Apache Oozie | Apache luftstrøm |
|---|---|---|
| Definisjonsspråk | Arbeidsflyter skrevet som XML | DAG-er skrevet som Python kode |
| Omfang | Bygget rundt Hadoop-handlinger som MapReduce, Pig, Hive og Sqoop | Generelt formål, med operatører for skytjenester, databaser og containere |
| Planlegging | Koordinatorjobber drevet av tid og datatilgjengelighet | Planlegg intervaller pluss sensorer som venter på eksterne forhold |
| Prosjekt status | Pensjonert til Apache Attic i 2025; endelig utgivelse 5.2.1 | Aktivt utviklet Apache toppnivåprosjekt |
Oozie er fortsatt det enklere alternativet på en klynge som allerede kjører det, fordi handlingene kartlegges én-til-én på Hadoop-komponenter. Luftstrøm er det praktiske valget for alt nytt, spesielt der en pipeline går utover Hadoop.
