
MongoDB 샤딩: 예제가 포함된 단계별 튜토리얼
 편집 팀
⚡ 스마트 요약
MongoDB 샤딩은 대규모 데이터 세트를 여러 서버에 분산된 더 작은 하위 집합으로 분할합니다. MongoDB 인스턴스를 분할하여 단일 서버의 CPU 부하를 줄입니다. 샤드 클러스터는 샤드, 구성 서버 및 라우터를 결합하여 스토리지 및 쿼리 처리량을 수평적으로 확장합니다.
샤딩이란? MongoDB?
샤딩은 개념이다. MongoDB, 대규모 데이터 세트를 여러 개의 작은 데이터 세트로 분할합니다. MongoDB 인스턴스.
때로는 내부 데이터 MongoDB 데이터 세트의 규모가 매우 커서 이러한 대규모 데이터 세트에 대한 쿼리는 서버의 CPU 사용률을 크게 높일 수 있습니다. 이러한 상황을 해결하기 위해, MongoDB 기본적으로 여러 데이터 세트를 분할하는 샤딩(Sharding)이라는 개념이 있습니다. MongoDB 인스턴스.
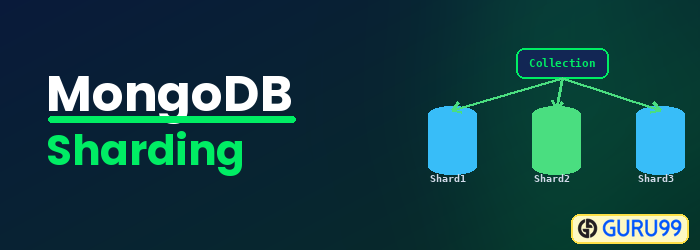
규모가 클 수 있는 컬렉션은 실제로 여러 컬렉션, 또는 샤드라고 불리는 것들로 분할됩니다. 논리적으로 모든 샤드는 하나의 컬렉션처럼 작동합니다.
샤딩의 장점 MongoDB
샤딩 클러스터를 구현하기 전에 팀이 샤딩을 도입하는 이유를 이해하는 것이 도움이 됩니다. 주요 이점은 다음과 같습니다.
- 수평적 확장성: 데이터는 단일 머신의 용량을 계속해서 늘리는 대신 여러 범용 서버에 분산됩니다.
- 더 높은 처리량: 읽기 및 쓰기 작업은 샤드 전체에서 병렬로 실행되므로 클러스터는 초당 더 많은 요청을 처리할 수 있습니다.
- 저장 용량 증가: 모든 샤드의 디스크를 합치면 단일 서버가 저장할 수 있는 것보다 훨씬 큰 데이터 세트를 저장할 수 있습니다.
- 고가용성: 각 샤드가 복제 세트로 배포될 경우, 단일 노드의 장애가 클러스터 전체에 영향을 미치지 않습니다.
- 균형 부하: The MongoDB 로드 밸런서는 특정 샤드가 핫스팟이 되는 것을 방지하기 위해 데이터 청크를 자동으로 재분배합니다.
이러한 장점들을 종합해 볼 때, 샤딩은 확장성을 확보하는 표준적인 접근 방식이 되었습니다. MongoDB 단일 서버의 한계를 넘어섭니다.
샤딩을 구현하는 방법
샤드는 클러스터를 사용하여 구현되는데, 클러스터는 샤드들의 그룹에 불과합니다. MongoDB 인스턴스.
샤드의 구성 요소는 다음과 같습니다.
- 파편 – 이게 기본이고, 이건 별거 아니다. MongoDB 데이터의 하위 집합을 보유하는 인스턴스입니다. 프로덕션 환경에서는 모든 샤드가 복제본 세트의 일부여야 합니다.
- 구성 서버 - 이것은 MongoDB 클러스터에 대한 메타데이터, 즉 다양한 정보에 대한 내용을 담고 있는 인스턴스입니다. MongoDB 샤드 데이터를 저장할 인스턴스입니다.
- 라우터 - 이것은 MongoDB 이 인스턴스는 기본적으로 클라이언트가 보낸 명령을 올바른 서버로 전달하는 역할을 합니다.
단계별 샤딩 Cluster 예시
단계 1) 구성 서버에 대해 별도의 데이터베이스를 만듭니다.
mkdir /data/configdb
단계 2) 시작 MongoDB 구성 모드의 인스턴스입니다. 예를 들어, 구성 서버로 사용할 Server D라는 서버가 있다고 가정해 보겠습니다. 이 서버를 구성 서버로 구성하려면 아래 명령을 실행해야 합니다.
mongod --configdb ServerD:27019
단계 3) 구성 서버를 지정하여 MongoDB 인스턴스를 시작합니다.
mongos --configdb ServerD:27019
단계 4) mongo 셸에서 mongos 인스턴스에 연결합니다.
mongo --host ServerD --port 27017
단계 5) 클러스터에 추가해야 할 서버 A와 서버 B가 있는 경우 아래 명령을 실행하십시오.
sh.addShard("ServerA:27017")
sh.addShard("ServerB:27017")
단계 6) 데이터베이스에 샤딩을 활성화합니다. 예를 들어 Employeedb 데이터베이스를 샤딩해야 하는 경우 아래 명령어를 실행합니다.
sh.enableSharding("Employeedb")
단계 7) 컬렉션에 샤딩을 활성화합니다. 예를 들어 Employee 컬렉션을 샤딩해야 하는 경우 아래 명령을 실행합니다.
sh.shardCollection("Employeedb.Employee", { "Employeeid": 1, "EmployeeName": 1 })
샤드 키를 선택하는 방법 MongoDB
샤드 키는 인덱싱된 필드 또는 필드 집합입니다. MongoDB 키는 각 문서를 어느 샤드에 저장할지 결정하는 데 사용됩니다. 키가 데이터 분산을 좌우하기 때문에, 샤딩 환경에서 키를 잘 선택하는 것은 가장 중요한 결정입니다. 잘못된 키를 사용하면 데이터와 트래픽이 하나의 샤드에 집중되어 샤딩의 이점이 상쇄됩니다.
강력한 샤드 키는 일반적으로 다음과 같은 특징을 가지고 있습니다.
- 높은 카디널리티: 해당 필드는 다양한 값을 가질 수 있어야 데이터를 여러 개의 세분화된 덩어리로 나눌 수 있습니다.
- 저주파: 어떤 단일 값도 지배적이어서는 안 됩니다. 그렇지 않으면 해당 값을 공유하는 문서들이 하나의 샤드에 몰리게 됩니다.
- 비단조적 변화: 타임스탬프처럼 항상 증가하는 키는 모든 새로운 쓰기 작업을 동일한 샤드로 전송하여 핫스팟을 생성합니다.
MongoDB 이 시스템은 키를 기반으로 두 가지 샤딩 전략을 지원합니다. 범위 샤딩은 데이터를 연속적인 범위로 나누어 범위 쿼리에 적합하며, 해시 샤딩은 해시 함수를 적용하여 쓰기 작업을 샤드 전체에 고르게 분산합니다. 일반적으로 쓰기 작업이 많을 때는 해시 샤딩으로 시작하고, 범위 기반 읽기 작업이 많아지면 범위 샤딩으로 전환합니다. 어떤 전략을 선택하든, 데이터가 로드된 후에는 샤드 키를 쉽게 변경할 수 없으므로 적용하기 전에 실제 쿼리 패턴을 사용하여 키를 테스트해야 합니다.
샤딩과 복제의 차이점 MongoDB
샤딩과 복제는 상호 보완적이지만 서로 다른 기능입니다. 아래 표는 두 기능의 차이점을 명확히 보여주므로, 이를 통해 각 기능을 올바르게 적용할 수 있습니다. 실제 운영 환경에서는 프로덕션 클러스터에서 샤딩과 복제를 함께 사용합니다.
| 아래 | 샤딩 | 복제 |
|---|---|---|
| 목적 | 데이터를 분할하여 수평적으로 확장합니다. | 데이터를 보호하고 언제든지 사용할 수 있도록 유지하세요. |
| 각 노드의 데이터 | 데이터의 부분집합(하나의 샤드) | 데이터의 전체 사본 |
| 주요 이점 | 더 많은 저장 용량 및 처리량 | 내결함성 및 읽기 확장 |
| 주요 구성 요소 | 샤드, 설정 서버, 몽고메리 라우터 | 주요 및 보조 구성원 |
요약하자면, 샤딩은 확장성에 대한 요구를 충족하고, 복제는 가용성에 대한 요구를 충족하며, 안정적인 배포는 이 둘을 모두 결합한 것입니다.
