
INDEX 생성 및 삭제 Cassandra
 편집 팀
⚡ 스마트 요약
인덱스를 생성하고 삭제합니다. Cassandra 기본 키에 포함되지 않은 열을 기준으로 필터링할 수 있습니다. 이 페이지에서는 CREATE INDEX 및 DROP INDEX 명령, 명명 규칙, 사용 가능한 인덱스 유형, 그리고 인덱스가 적합하지 않은 경우에 대해 설명합니다.
Cassandra 인덱스 생성
인덱스 생성' 명령어는 사용자가 지정한 컬럼에 인덱스를 생성한다. 인덱싱하려는 열에 대한 데이터가 이미 존재하는 경우 Cassandra 'create index' 문 실행 중에 데이터에 대한 인덱스를 생성합니다.
- 인덱스를 생성한 후, Cassandra 데이터가 삽입되면 자동으로 새 데이터를 인덱싱합니다.
- 기본 키가 이미 인덱싱되어 있으므로 기본 키에 대한 인덱스를 생성할 수 없습니다.
- 컬렉션 열에 대한 인덱스는 검색 대상에 따라 KEYS, VALUES 또는 ENTRIES 형식을 사용하여 지원됩니다.
- 열에 대한 인덱싱을 하지 않고, Cassandra 해당 열이 기본 키가 아닌 경우 필터링할 수 없습니다.
그래서 열을 필터링하려면 다음과 같이 합니다. Cassandra인덱스를 생성해야 합니다.
통사론
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
예시
다음은 인덱스를 생성하지 않고 "dept" 열을 필터링하려고 시도한 스냅샷입니다. 이에 대한 응답으로 오류가 반환되었습니다.

다음은 dept 열에 인덱스가 생성된 스냅샷입니다.

CREATE INDEX DeptIndex ON University.Student (dept);
다음은 'dept' 열을 성공적으로 필터링한 스냅샷입니다.

SELECT * FROM University.Student WHERE dept = 'CS';
인덱스 이름은 선택 사항입니다. 생략하면 Cassandra 인덱스를 자동으로 생성하는데, 이는 나중에 인덱스를 삭제해야 할 때 중요합니다.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra 하락 지수
'Drop index' 명령은 지정된 인덱스를 삭제합니다. 인덱스 생성 중에 인덱스 이름이 지정되지 않은 경우 인덱스 이름은 TableName_ColumnName_idx입니다.
- 인덱스가 존재하지 않는 경우 no-op를 반환하는 IF EXISTS를 사용하지 않으면 오류가 반환됩니다.
- 인덱스 이름과 함께 키스페이스 이름을 지정해야 합니다. 그렇지 않으면 현재 키스페이스에서 인덱스를 찾습니다.
통사론
DROP INDEX IF EXISTS KeyspaceName.IndexName;
예시
다음은 DeptIndex 인덱스를 삭제하는 실행된 명령 'Drop index'의 스냅샷입니다.
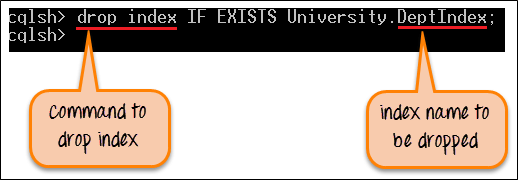
DROP INDEX IF EXISTS University.DeptIndex;
명령이 성공적으로 실행되면 DeptIndex가 키스페이스에서 삭제됩니다. 이제 부서 열을 기준으로 데이터를 필터링할 수 없습니다.
삭제하기 전에 어떤 인덱스가 존재하는지 확인하려면ping 첫째, 표를 설명하고 출력 하단에 있는 인덱스 정의를 읽으십시오.
DESCRIBE TABLE University.Student;
인덱스의 종류 Cassandra
위 명령어는 표준 보조 인덱스를 생성하지만, 세 가지 별개의 메커니즘이 존재하며 각각 매우 다르게 작동합니다.
| 타입 | 전달 방법 | 가장 좋은 |
|---|---|---|
| 보조 색인 | 각 노드는 자체 로컬 데이터만 인덱싱하므로 파티션 키가 없는 쿼리는 모든 노드에 연결해야 합니다. | 파티션 키와 함께 쿼리되는 중간 정도의 카디널리티를 가진 컬럼들. |
| SASI 지수 | LIKE 접두사 및 접미사 일치와 숫자 범위 검색을 지원하는 첨부된 인덱스입니다. | 텍스트 검색 패턴. 아직 실험 단계이므로 실제 사용 전에 테스트하십시오. |
| 스토리지 연결 인덱스(SAI) | 에서 소개 된 Cassandra 5.0 버전에서는 쓰기 오버헤드를 낮추면서 여러 열에 걸쳐 하나의 인덱스 구조를 공유합니다. | 위의 두 가지를 대체하는 현대적인 것은 다음과 같습니다. Cassandra 5개의 클러스터. |
컬렉션 열에 인덱싱하려면 인덱싱할 부분을 지정하는 수정자를 사용합니다.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES는 집합 또는 목록의 요소를 검색하고, KEYS는 맵 키를 검색하며, ENTRIES는 키와 값 쌍을 일치시킵니다. 컬렉션 인덱싱에 대한 자세한 내용은 다음에서 다룹니다. Cassandra 컬렉션 튜토리얼.
인덱스를 사용하지 않는 경우 Cassandra
보조 인덱스는 편리하지만 관계형 인덱스는 아니며, 잘못된 위치에 사용하면 클러스터링 속도가 느려지는 일반적인 원인이 됩니다. 네 가지 상황에서는 다른 접근 방식이 필요합니다.
- 매우 높은 카디널리티. 이메일 주소처럼 거의 고유한 항목을 인덱싱하면 거의 모든 파티션에 일치하는 행이 하나씩 존재하게 되므로 쿼리가 전체 클러스터에 걸쳐 검색하여 단일 레코드를 반환합니다.
- 카디널리티가 매우 낮습니다. 활성 또는 비활성과 같은 두 값 플래그를 인덱싱하면 엄청나게 큰 인덱스 파티션이 생성되고, 그중 하나를 읽으면 테이블의 절반이 반환됩니다.
- 자주 업데이트되는 칼럼입니다. 모든 변경 사항은 인덱스 항목과 이전 항목에 대한 툼스톤을 생성하므로 툼스톤이 누적되면 시간이 지남에 따라 읽기 성능이 저하됩니다.
- 파티션 키가 없는 쿼리입니다. 이 기능이 없으면 코디네이터는 모든 노드에 연락하여 결과를 병합해야 하는데, 노드가 추가될수록 확장성이 떨어집니다.
더 안정적인 대안은 검색이 필요한 열을 키로 하는 두 번째 테이블을 첫 번째 테이블과 동시에 작성하는 것입니다. 이는 앞서 설명한 쿼리 우선 원칙을 따릅니다. Cassandra 데이터 모델 규칙또한 모든 읽기 작업을 단일 노드의 단일 파티션에 저장합니다.
일반적으로 인덱스는 알려진 파티션 키와 함께 쿼리되는 적당한 카디널리티의 열에 적합합니다. 이러한 조건을 벗어나는 경우에는 전용 테이블을 사용하는 것이 더 효과적입니다.
