
Cassandra 컬렉션: CQL의 설정, 목록 및 매핑(예제 포함)
 데이비드 카터
⚡ 스마트 요약
Cassandra 컬렉션은 set, list, map 타입을 사용하여 단일 열에 여러 값을 저장합니다. 이 페이지에서는 각 타입, 컬렉션 생성 및 데이터 입력에 사용되는 CQL 구문, 요소 업데이트 방법, 그리고 컬렉션 사용이 적합하지 않은 경우를 결정하는 크기 제한에 대해 설명합니다.
무엇인가 Cassandra 컬렉션?
Cassandra 컬렉션은 작업을 처리하는 좋은 방법입니다. 여러 요소를 컬렉션에 저장할 수 있습니다. 에는 제한이 있습니다. Cassandra 컬렉션.
- 컬렉션 열에는 단일 값으로 64KB를 초과하는 데이터를 저장할 수 없습니다.
- 컬렉션 쿼리 시 발생하는 오버헤드를 방지하려면 컬렉션 크기를 작게 유지하세요. 필요한 요소가 하나뿐인 경우에도 전체 컬렉션을 읽어야 하기 때문입니다.
- 64KB 이상을 저장하면 처음 64KB만 조회할 수 있으므로 데이터 손실이 발생합니다.
- 동결 해제된 컬렉션은 약 65,535개의 요소로 제한되며, 모든 요소는 하나의 단위로 함께 읽힙니다.
이러한 제한 사항은 한 가지 규칙을 시사합니다. 컬렉션은 행에 연결된 몇 가지 속성에 적합하며, 사용량에 따라 계속해서 늘어나는 무한한 목록에는 적합하지 않습니다. 계속해서 증가하는 모든 항목은 별도의 테이블에서 열을 묶어 관리해야 합니다.
유형 Cassandra Collections
컬렉션에는 주로 세 가지 유형이 있습니다. Cassandra 지원 :
- 세트
- 명부
- 지도
Cassandra 세트 컬렉션
Set은 쿼리할 때 정렬된 요소를 반환하는 요소 그룹을 저장합니다.
통사론
다음은 교사의 여러 이메일 주소를 저장하는 Set 컬렉션의 구문입니다.
CREATE TABLE University.Teacher (
    id int,
    Name text,
    Email set<text>,
    PRIMARY KEY (id)
);
예시
다음은 "이메일" 열을 컬렉션으로 사용하여 "선생님" 테이블을 만든 스냅샷입니다.

다음은 컬렉션에 데이터가 삽입되는 스냅샷입니다.

INSERT INTO University.Teacher (id, Name, Email)
VALUES (1, 'Guru99', {'abc@gmail.com', 'xyz@hotmail.com'});
컬렉션을 고정하지 않고 개별 요소를 추가하거나 제거할 수 있다는 것이 컬렉션을 고정하지 않는 가장 큰 장점입니다.
UPDATE University.Teacher SET Email = Email + {'new@guru99.com'} WHERE id = 1;
UPDATE University.Teacher SET Email = Email - {'xyz@hotmail.com'} WHERE id = 1;
Cassandra 컬렉션 목록
요소의 순서가 중요한 경우 목록이 사용됩니다.
예시
다음은 "교사" 테이블에 목록 형식의 "과정" 열이 추가된 스냅샷입니다.
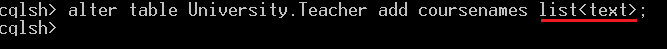
ALTER TABLE University.Teacher ADD coursenames list<text>;
다음은 "coursenames" 열에 데이터가 삽입되는 스냅샷입니다.
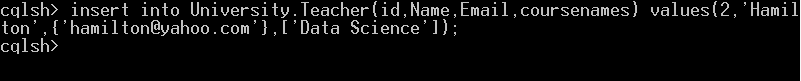
INSERT INTO University.Teacher (id, Name, Email, coursenames)
VALUES (2, 'Hamilton', {'hamilton@hotmail.com'}, ['Data Science']);
다음은 삽입 후 현재 데이터베이스 상태를 보여주는 스냅샷입니다.

요소를 추가하거나 앞에 붙일 수 있지만, 앞에 붙이거나 인덱스로 업데이트하는 두 가지 모두 특정 조건을 충족해야 합니다. Cassandra 먼저 목록을 읽기 때문에 추가하는 방식보다 속도가 느립니다.
UPDATE University.Teacher SET coursenames = coursenames + ['Machine Learning'] WHERE id = 2;
UPDATE University.Teacher SET coursenames = ['Statistics'] + coursenames WHERE id = 2;
Cassandra 지도 수집
맵은 키 값 쌍을 저장하는 데 사용되는 컬렉션 유형입니다. 이름에서 알 수 있듯이 하나의 항목을 다른 항목에 매핑한다는 의미입니다.
예를 들어, 선수과목명과 함께 과목명을 저장하고 싶다면 지도컬렉션을 이용하면 됩니다.
예시
코스 이름과 선수 코스 이름에 대한 지도 유형이 생성된 스냅샷은 다음과 같습니다.

CREATE TABLE University.Course (
    id int,
    prereq map<text, text>,
    PRIMARY KEY (id)
);
맵 컬렉션 형식으로 데이터가 삽입되는 스냅샷은 다음과 같습니다.

INSERT INTO University.Course (id, prereq)
VALUES (1, {'DataScience': 'Database', 'Neural Network': 'Artificial Intelligence'});
지도의 다른 부분을 건드리지 않고 단일 항목을 설정하거나 삭제할 수 있습니다.
UPDATE University.Course SET prereq['Robotics'] = 'Linear Algebra' WHERE id = 1;
DELETE prereq['DataScience'] FROM University.Course WHERE id = 1;
세트 vs 리스트 vs 맵: 컬렉션 선택하기
세 가지 유형은 외관상 서로 호환되지만 주문 보증 및 업데이트 비용에서 차이가 있습니다.
| 아래 | 세트 | 명부 | 지도 |
|---|---|---|---|
| 주문 | 값순으로 정렬 | 삽입 순서가 유지됩니다. | 키를 기준으로 정렬 |
| 중복 | 허용되지 않음 | 허용 | 키는 고유합니다 |
| 업데이트 비용 | 저렴하고, 읽을 필요 없음 | 추가는 저렴하지만, 접두사 추가 및 인덱스 업데이트에는 읽기 작업이 필요합니다. | 키당 저렴함 |
| 가장 좋은 | 태그, 이메일 주소, 고유 라벨 | 중복이 의미 있는 순서 단계 | 예측 불가능한 키를 가진 명명된 속성 |
순서가 정말 중요한 경우가 아니라면 리스트보다는 세트를 사용하는 것이 좋습니다. 리스트 인덱스를 사용하면 인덱스에 저장된 데이터가 삭제되어 동시 쓰기 작업 시 예상치 못한 결과가 발생할 수 있기 때문입니다. 겨울 왕국 세 개의 저장소 중 하나에 변경 불가능한 값으로 저장되므로 컬렉션이 기본 키로 나타날 수 있지만 요소 수준 업데이트는 제거됩니다.
CREATE TABLE University.Enrolment (
    id int,
    tags frozen<set<text>>,
    PRIMARY KEY (id, tags)
);
컬렉션의 요소가 수십 개를 초과하는 경우, 해당 요소를 클러스터링 열로 사용하는 별도의 테이블로 모델링하는 것이 좋습니다. 이는 앞서 제시된 접근 방식을 따릅니다. Cassandra 데이터 모델 규칙컬렉션 콘텐츠를 필터링하려면 인덱스가 필요하며, 이는 다음에서 다룹니다. 인덱스 생성 및 삭제 튜토리얼.
