
Apa itu Skema Bintang dalam pemodelan Data Warehouse?
 David Carter
⚡ Ringkasan Cerdas
Skema Bintang dalam pemodelan gudang data menempatkan tabel fakta pusat di inti tabel dimensi di sekitarnya, menciptakan desain berbentuk bintang yang tidak dinormalisasi yang menyederhanakan kueri analitik, mempercepat pelaporan, dan mendukung kubus OLAP di seluruh platform intelijen bisnis.
Apa itu Skema Bintang?
A skema bintang Dalam data warehouse, struktur pemodelannya adalah tabel fakta pusat yang terhubung ke sejumlah tabel dimensi terkait. Struktur ini disebut skema bintang karena tata letaknya menyerupai bintang, dengan tabel fakta berada di tengah dan tabel dimensi memancar keluar seperti titik-titik.
Skema bintang adalah jenis skema gudang data yang paling sederhana, dan juga dikenal sebagai skema gabungan bintang. Karena tabel dimensinya tidak dinormalisasi, model ini dioptimalkan untuk melakukan kueri pada kumpulan data yang sangat besar, yang menjadikannya pilihan umum untuk pemodelan dimensi dan pelaporan.
Apa itu Skema Multidimensi?
A skema multidimensi Dirancang khusus untuk memodelkan sistem gudang data. Skema ini menjawab kebutuhan unik dari basis data yang sangat besar yang dibangun untuk tujuan analitis. OLAP alih-alih untuk pemrosesan transaksi rutin.
Jenis-jenis skema gudang data: Terdapat tiga jenis utama skema multidimensi, dan masing-masing menawarkan keunggulan tersendiri.
- Skema bintang – tabel fakta pusat yang terhubung langsung ke tabel dimensi yang telah dinormalisasi.
- Skema kepingan salju – perluasan dari skema bintang di mana dimensi dinormalisasi ke dalam tabel sub-dimensi tambahan.
- Skema galaksi – juga disebut sebagai konstelasi fakta, ia menggunakan beberapa tabel fakta yang memiliki tabel dimensi yang sama.
Karena skema snowflake dibangun langsung di atas skema bintang, ada baiknya membandingkan kedua model tersebut sebelum mengerjakan contoh skema bintang secara detail.
Skema Bintang vs Skema Kepingan Salju
Skema bintang dan skema kepingan salju Keduanya mengatur data di sekitar tabel fakta dan dimensi, tetapi berbeda dalam cara penyimpanan dimensinya. Skema bintang menyimpan setiap dimensi dalam satu tabel yang tidak dinormalisasi, sedangkan skema kepingan salju menormalisasi dimensi tersebut ke dalam beberapa tabel yang saling terkait.
- Struktur: Skema bintang bersifat datar dan sederhana; skema kepingan salju membagi dimensi menjadi sub-dimensi.
- Kecepatan kueri: Skema bintang membutuhkan lebih sedikit operasi join, sehingga kueri biasanya berjalan lebih cepat dan kode SQL tetap lebih sederhana.
- penyimpanan: Skema Snowflake menghilangkan redundansi, sehingga menggunakan lebih sedikit ruang tetapi menambah kompleksitas desain.
- Integritas data: Dimensi kepingan salju yang dinormalisasi lebih baik dalam menegakkan integritas, sedangkan dimensi bintang yang didenormalisasi lebih mengutamakan kinerja.
- Mudah digunakan: Skema bintang lebih mudah dipahami oleh analis dan lebih cepat dipelihara, sedangkan skema kepingan salju membutuhkan desain yang lebih cermat.
Dalam praktiknya, tim sering memilih skema bintang untuk data mart dan dasbor yang membutuhkan pelaporan cepat dan mudah, dan skema kepingan salju ketika penghematan penyimpanan dan konsistensi yang ketat lebih penting.
Contoh Skema Bintang
Dalam contoh skema bintang berikut, tabel fakta berada di tengah dan menyimpan kunci untuk setiap tabel dimensi, seperti Dealer_ID, Model_ID, Date_ID, Product_ID, dan Branch_ID, beserta atribut yang dapat diukur seperti unit terjual dan pendapatan.
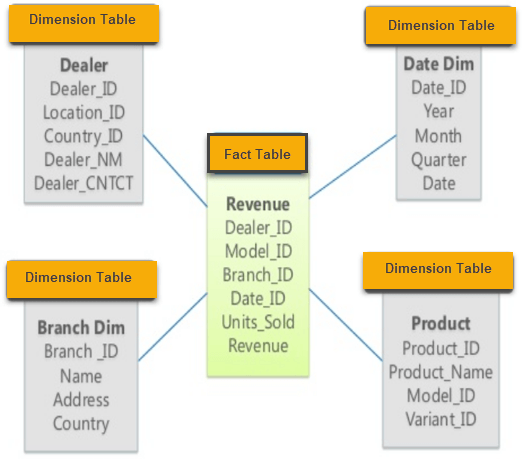
Setiap tabel dimensi di sekitarnya menambahkan konteks deskriptif pada ukuran-ukuran tersebut, sehingga satu kueri dapat mengelompokkan atau memfilter fakta penjualan berdasarkan dealer, model, tanggal, produk, atau cabang tanpa menggabungkan tabel lain.
Tabel Fakta
Tabel fakta dalam skema bintang berisi fakta dan terhubung ke dimensi. Tabel fakta memiliki dua jenis kolom:
- Kolom yang menyimpan fakta, atau ukuran.
- Kunci asing yang menghubungkan ke setiap tabel dimensi.
Secara umum, kunci utama dari sebuah tabel fakta adalah kunci komposit yang terdiri dari semua kunci asing yang membentuk tabel tersebut.
Tabel fakta dapat berisi fakta tingkat detail atau fakta yang telah diagregasi. Tabel fakta yang mencakup fakta yang telah diagregasi sering disebut tabel ringkasan, dan biasanya berisi fakta yang telah diagregasi hingga tingkat tertentu.
Tabel Dimensi
Dimensi adalah struktur yang mengkategorikan data ke dalam hierarki. Dimensi tanpa hierarki dan tingkatan disebut dimensi datar atau daftar. Kunci utama setiap tabel dimensi merupakan bagian dari kunci utama komposit tabel fakta.
Atribut dimensi adalah atribut tekstual deskriptif yang membantu menjelaskan nilai dimensi, seperti nama produk atau kota. Karena tabel dimensi menyimpan konteks deskriptif ini dan bukan peristiwa transaksional, tabel fakta biasanya jauh lebih besar daripada tabel dimensi.
Cara Mendesain Skema Bintang
Perancangan skema bintang mengikuti pendekatan pemodelan dimensional yang dipopulerkan oleh Ralph Kimball. Tujuannya adalah untuk mengatur ukuran bisnis di sekitar dimensi yang jelas dan dapat digunakan kembali sehingga model yang dihasilkan mudah untuk dipertanyakan dan cepat untuk dilaporkan. Lima langkah di bawah ini menguraikan proses yang diikuti oleh sebagian besar proyek pemodelan dimensional, mulai dari pertanyaan bisnis tingkat tertinggi hingga tabel fakta dan dimensi fisik.
- Identifikasi proses bisnis: Pilih aktivitas yang ingin Anda analisis, seperti penjualan, pengiriman.pingatau inventaris. Keputusan ini menentukan apa yang akan diukur oleh tabel fakta.
- Sebutkan jenis biji-bijiannya: Tentukan tingkat detail yang diwakili oleh setiap baris fakta, misalnya satu baris per item, per transaksi, atau per hari. Tingkat detail yang jelas menjaga konsistensi model.
- Identifikasi dimensinya: Cantumkan konteks deskriptif yang dibutuhkan untuk memilah fakta, seperti produk, pelanggan, dealer, cabang, dan tanggal. Masing-masing menjadi tabel dimensi atribut.
- Identifikasi fakta-faktanya: Tentukan ukuran numerik yang diinginkan bisnis. track, seperti unit terjual, pendapatan, atau biaya, dan tempatkan di tabel fakta pusat.
- Bangun bintangnya: Hubungkan tabel fakta ke setiap dimensi melalui kunci asing, simpanping Dimensi-dimensi tersebut dinormalisasi sehingga diagram membentuk tabel fakta pusat tunggal yang dikelilingi oleh dimensi-dimensinya.
Setelah struktur bintang dibuat, tambahkan kunci pengganti (surrogate key) ke setiap dimensi, pastikan setiap tabel fakta memiliki dimensi tanggal yang terkait, dan konfirmasikan bahwa semua fakta berada pada tingkat detail yang sama. Sebaiknya juga memuat data atomik tingkat terendah terlebih dahulu, karena tabel ringkasan selalu dapat dibuat kemudian. Mengikuti aturan-aturan ini akan menjaga skema tetap optimal untuk kinerja tinggi dan sederhana. data warehouse pelaporan.
Karakteristik Skema Bintang
- Setiap dimensi dalam skema bintang hanya diwakili oleh satu tabel dimensi.
- Setiap tabel dimensi berisi kumpulan atributnya sendiri.
- Tabel dimensi dihubungkan ke tabel fakta menggunakan kunci asing.
- Tabel dimensi tidak saling terhubung.
- Tabel fakta berisi kunci dan ukuran.
- Skema bintang mudah dipahami dan memberikan penggunaan disk yang optimal.
- Tabel dimensi tidak dinormalisasi. Misalnya, pada contoh di atas, Country_ID tidak memiliki tabel pencarian Negara terpisah seperti yang seharusnya. OLTP desain akan.
- Skema ini didukung secara luas oleh perangkat BI.
Keuntungan Skema Bintang
Skema bintang menawarkan beberapa manfaat yang menjadikannya titik awal yang populer untuk desain gudang data:
- Skema bintang menggunakan logika penggabungan yang lebih sederhana daripada skema lain saat mengambil data dari sumber transaksional yang sangat dinormalisasi.
- Skema bintang menyederhanakan logika pelaporan bisnis umum, seperti pelaporan periode ke periode dan pelaporan per tanggal.
- Skema bintang banyak digunakan oleh sistem OLAP untuk membangun kubus secara efisien, dan skema bintang dapat berfungsi sebagai sumber tanpa perlu mendesain struktur kubus di sebagian besar sistem OLAP utama.
- Dengan mengaktifkan penyetelan kinerja spesifik yang dapat diterapkan pada kueri, prosesor kueri dapat menawarkan rencana eksekusi yang lebih baik.
Kelemahan Skema Bintang
- Karena skema tersebut sangat tidak dinormalisasi, integritas data tidak ditegakkan secara ketat.
- Sistem ini kurang fleksibel dalam hal kebutuhan analisis tingkat lanjut.
- Skema bintang tidak memperkuat hubungan banyak-ke-banyak antara entitas bisnis.
Kapan Menggunakan Skema Bintang?
Skema bintang adalah pilihan yang tepat ketika kinerja kueri yang cepat dan dapat diprediksi lebih penting daripada penghematan ruang penyimpanan. Karena model ini menjaga tabel dimensinya tetap tidak dinormalisasi dan jumlah penggabungan (join) rendah, model ini cocok untuk beban kerja analitik di mana pengguna bisnis berulang kali menjalankan laporan, dasbor, dan agregasi serupa pada volume data historis yang besar.
Situasi umum di mana skema bintang sangat cocok meliputi:
- Data mart: Departemen data mart Hubungan yang sederhana dan mudah dipahami akan mendapat manfaat dari struktur yang mudah dibaca.
- Dasbor BI: Intelijen bisnis Alat-alat tersebut terintegrasi dengan rapi ke dalam skema bintang, sehingga laporan dan visualisasi dapat dibuat dengan cepat.
- Kubus OLAP: Skema bintang merupakan sumber alami untuk kubus OLAP, agregasi, dan analisis irisan-dan-potong.
Jika prioritasnya bergeser ke penyimpanan minimal, integritas data yang ketat, atau hierarki yang dalam dan berubah-ubah, skema snowflake atau desain yang lebih ternormalisasi mungkin lebih cocok. Banyak tim bahkan menggabungkan keduanya, dimulai dengan skema bintang dan menormalisasi hanya dimensi yang benar-benar membutuhkannya.
