
Skema Kepingan Salju dalam Model Gudang Data
 Tim Editorial
⚡ Ringkasan Cerdas
Skema Snowflake dalam pemodelan Data Warehouse mengatur tabel dimensi yang dinormalisasi yang bercabang dari tabel fakta pusat, menyerupai kepingan salju. Skema ini memperluas skema bintang, mengurangi redundansi data, dan mengatur hierarki di beberapa tabel pencarian terkait.
Apa itu Skema Kepingan Salju?
A Skema Kepingan Salju Dalam data warehouse, terdapat susunan logis tabel dalam basis data multidimensi yang diagram hubungan entitas (ER) menyerupai bentuk kepingan salju. Ini adalah model dimensi di mana tabel fakta pusat terhubung ke tabel dimensi, dan tabel dimensi tersebut selanjutnya dibagi menjadi tabel sub-dimensi yang terkait.
Skema snowflake merupakan perluasan dari skema bintang. Sementara skema bintang menyimpan setiap dimensi dalam satu tabel datar, skema snowflake menormalisasi dimensi tersebut, membagi kelompok data yang berulang ke dalam tabel pencarian tambahan. Normalisasi ini menghilangkan redundansi dan menciptakan struktur hierarkis bercabang yang menjadi asal nama skema ini.
Contoh Skema Kepingan Salju
Dalam contoh skema snowflake berikut, tabel fakta Penjualan berada di tengah, dikelilingi oleh dimensi seperti Produk, Tanggal, dan Toko. Alih-alih menyimpan setiap atribut di dalam satu tabel dimensi, informasi geografis dinormalisasi sehingga Negara dipindahkan ke tabel terpisah tersendiri.

Di sini, dimensi Toko merujuk pada tabel Kota, tabel Kota merujuk pada tabel Negara Bagian, dan tabel Negara Bagian merujuk pada tabel Negara. Setiap nilai hanya disimpan sekali dan dihubungkan oleh kunci asing, sehingga nama negara tidak pernah diulang di jutaan baris. Normalisasi berlapis inilah yang membedakan skema snowflake dari skema bintang datar.
Karakteristik Skema Kepingan Salju
Skema kepingan salju memiliki beberapa karakteristik yang mendefinisikannya:
- Metode ini menggunakan ruang disk yang lebih kecil, karena tabel dimensi yang dinormalisasi menghindari penyimpanan nilai yang berulang.
- Dimensi baru dapat ditambahkan ke skema dengan upaya yang relatif sedikit.
- Performa kueri dapat menurun, karena pengambilan data memerlukan penggabungan banyak tabel.
- Diperlukan lebih banyak upaya pemeliharaan, karena jumlah tabel pencarian yang harus dikelola lebih banyak.
Cara Mendesain Skema Kepingan Salju
Mendesain skema snowflake dimulai dengan cara yang sama seperti model dimensional lainnya, kemudian menambahkan langkah normalisasi. Tujuannya adalah untuk mengidentifikasi proses bisnis yang ingin Anda analisis, memodelkannya terlebih dahulu sebagai skema bintang, dan kemudian menormalisasi dimensi yang berisi hierarki yang dalam. Ikuti langkah-langkah berikut:
- Identifikasi proses bisnis dan tingkat detailnya. Tentukan apa yang diwakili oleh satu baris dalam tabel fakta, misalnya satu transaksi penjualan, dan definisikan ukuran numerik, atau fakta, yang perlu Anda laporkan.
- Buat tabel fakta utama. Jumlahkan ukuran numerik beserta kunci asing yang mengarah ke setiap dimensi; bersama-sama, kunci asing tersebut biasanya membentuk kunci utama komposit.
- Definisikan tabel dimensi. Buat satu tabel untuk setiap dimensi deskriptif, seperti Produk, Pelanggan, Tanggal, dan Toko, dan tetapkan kunci utama pengganti (surrogate primary key) untuk masing-masing dimensi.
- Normalisasikan hierarki. Pisahkan setiap dimensi yang memuat atribut berulang ke dalam tabel sub-dimensi, misalnya memindahkan Kategori dari Produk, atau Kota, Provinsi, dan Negara dari dimensi Toko.
- Hubungkan tabel-tabel tersebut dengan kunci asing. Hubungkan setiap sub-dimensi kembali ke tabel induknya sehingga cabang-cabangnya membentuk hierarki satu-ke-banyak yang jelas menyerupai kepingan salju.
- Validasi dan uji dengan kueri. Jalankan kueri pelaporan representatif untuk memastikan bahwa penggabungan (join) mengembalikan hasil yang benar dan bahwa kinerja keseluruhan tetap dapat diterima.
Karena desain tersebut menormalisasi data ke arah bentuk normal ketiga, dokumentasikan jalur penggabungan dengan jelas agar analis memahami cara menavigasi setiap cabang. Setelah struktur didefinisikan, ada baiknya mempertimbangkan manfaat skema dibandingkan dengan biayanya.
Keunggulan Skema Kepingan Salju
Skema snowflake menawarkan sejumlah manfaat:
- Keunggulan utamanya adalah pengurangan penyimpanan disk, karena penggabungan tabel pencarian yang dinormalisasi lebih kecil menghindari duplikasi data dimensi.
- Hal ini memberikan skalabilitas yang lebih besar dalam hubungan antara komponen dan tingkat dimensi.
- Hal ini menghilangkan redundansi, yang meningkatkan integritas data dan membuat model lebih mudah dipelihara.
- Atribut deskriptif hanya diperbarui di satu tempat, yang mengurangi risiko data yang tidak konsisten.
Kelemahan Skema Snowflake
Desain ini juga memiliki beberapa kompromi yang perlu dipertimbangkan:
- Struktur yang dinormalisasi meningkatkan kebutuhan pemeliharaan untuk mengelola banyak tabel terkait.
- Kueri kompleks yang mencakup banyak operasi join dapat sulit untuk ditulis dan dipahami.
- Semakin banyak tabel berarti semakin banyak operasi join, yang memperpanjang waktu eksekusi query.
- Pengguna bisnis seringkali merasa model percabangan lebih sulit dinavigasi daripada skema bintang sederhana.
Skema Kepingan Salju vs Skema Bintang
Skema kepingan salju dan skema bintang Skema bintang dan skema kepingan salju adalah dua desain multidimensi yang paling umum dalam gudang data, dan perbedaan utama di antara keduanya adalah normalisasi. Skema bintang menyimpan setiap dimensi dalam satu tabel datar yang tidak dinormalisasi untuk kecepatan kueri maksimum, sedangkan skema kepingan salju menormalisasi dimensi tersebut ke dalam beberapa tabel terkait untuk menghemat penyimpanan dan melindungi integritas data. Karena itu, kedua skema tersebut sesuai dengan prioritas yang berbeda.
| Aspek | Skema Bintang | Skema Kepingan Salju |
|---|---|---|
| Tabel dimensi | Tidak dinormalisasi, satu tabel per dimensi | Dinormalisasi ke dalam tabel sub-dimensi |
| Storage | Menggunakan lebih banyak ruang karena adanya redundansi. | Menggunakan lebih sedikit ruang, tanpa redundansi. |
| Performa kueri | Lebih cepat, lebih sedikit penggabungan | Lebih lambat, lebih banyak penggabungan |
| Kompleksitas kueri | Mudah ditulis | Lebih kompleks |
| Paling cocok untuk | Pelaporan cepat dan BI | Dimensi besar dan hierarkis |
Singkatnya, pilih skema bintang (star schema) ketika kecepatan kueri dan kesederhanaan pelaporan menjadi prioritas utama, dan pilih skema kepingan salju (snowflake schema) ketika efisiensi penyimpanan, hierarki yang rapi, dan redundansi data yang rendah menjadi prioritas. Banyak gudang data (data warehouse) yang sebenarnya menggabungkan kedua pola tersebut tergantung pada ukuran dan kedalaman setiap dimensi.
Kapan Menggunakan Skema Kepingan Salju?
Skema snowflake tidak selalu merupakan pilihan yang tepat, jadi ada baiknya menyesuaikan desain dengan beban kerja dan kebutuhan pelaporan. Skema ini cenderung bekerja paling baik dalam situasi berikut:
- Dimensi sangat besar dan mengandung banyak atribut berulang yang membuang ruang penyimpanan saat dinormalisasi.
- Dimensi memiliki hierarki yang mendalam dan terdefinisi dengan baik, seperti Wilayah ke Negara ke Provinsi ke Kota, yang secara alami dipetakan ke tabel terpisah.
- Integritas dan konsistensi data lebih penting bagi proyek daripada kecepatan kueri mentah.
- Biaya penyimpanan merupakan masalah yang nyata dan penghematan ruang disk pada tabel dimensi yang sangat besar sangatlah signifikan.
- Model tersebut memberi makan OLAP alat yang dapat menavigasi hierarki yang dinormalisasi secara efisien.
Sebaliknya, ketika pelaporan yang cepat dan sederhana untuk analis bisnis menjadi prioritas, skema bintang atau desain gugus bintang hibrida biasanya lebih cocok. Banyak arsitektur gudang data Dengan sengaja memadukan kedua pendekatan tersebut untuk menyeimbangkan kecepatan dan penyimpanan.
Apa itu Skema Galaksi?
A Skema Galaxy Berisi dua atau lebih tabel fakta yang berbagi tabel dimensi di antara keduanya. Ini juga disebut Skema Konstelasi Fakta, dan karena dapat dilihat sebagai kumpulan bintang, maka disebut juga skema galaksi.
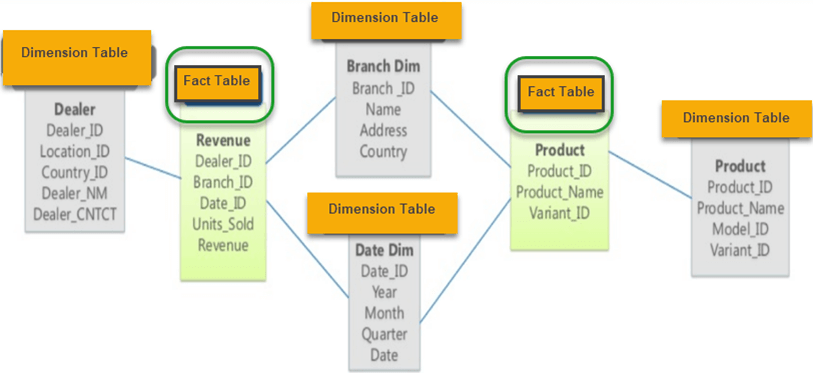
Seperti yang Anda lihat pada contoh di atas, ada dua tabel fakta:
- Revenue
- Produk
Dalam skema galaksi, dimensi yang dibagi antara tabel fakta disebut dimensi yang sesuai.
Karakteristik Skema Galaksi
Skema galaksi memiliki karakteristik sebagai berikut:
- Dimensi-dimensi tersebut dipisahkan menjadi dimensi-dimensi yang berbeda berdasarkan berbagai tingkatan hierarki.
- Sebagai contoh, jika geografi memiliki empat tingkatan hierarki — wilayah, negara, negara bagian, dan kota — maka skema galaksi seharusnya memiliki empat dimensi.
- Skema jenis ini dapat dibangun dengan membagi satu skema bintang menjadi beberapa skema bintang lainnya.
- Dimensi dalam skema ini besar dan harus dibangun sesuai dengan tingkatan hierarki.
- Skema ini bermanfaat untuk menggabungkan tabel fakta guna mendukung analisis dan pemahaman yang lebih baik.
Apa itu Bintang Cluster Skema?
Skema snowflake berisi hierarki yang sepenuhnya diperluas, yang dapat menambah kompleksitas dan memerlukan penggabungan tambahan. Skema bintang, di sisi lain, berisi hierarki yang sepenuhnya dilipat, yang dapat menyebabkan redundansi. Solusi terbaik seringkali merupakan keseimbangan antara kedua desain ini, yang dikenal sebagai skema Bintang. Cluster Skema.
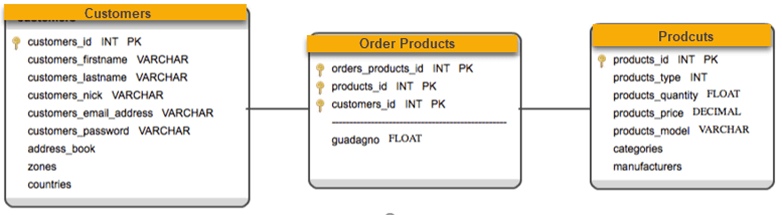
Tumpang tindihping Dimensi muncul sebagai percabangan dalam hierarki. Percabangan terjadi ketika suatu entitas bertindak sebagai induk dalam dua hierarki dimensi yang berbeda. Entitas percabangan ini kemudian diidentifikasi sebagai klasifikasi dengan hubungan satu-ke-banyak, yang membatasi jumlah tabel tambahan yang dibuat oleh desain.
