
Apa itu Pengujian Pemulihan? dengan Contoh
 Tim Editorial
⚡ Ringkasan Cerdas
Pengujian pemulihan memverifikasi bahwa perangkat lunak dapat melanjutkan operasi normal setelah terjadi kerusakan, gangguan jaringan, atau kegagalan perangkat keras, dengan memulihkan sistem ke titik yang diketahui baik dan memproses ulang transaksi hingga terjadinya kegagalan.
Apa itu Pengujian Pemulihan?
Pengujian Pemulihan Pengujian pemulihan adalah teknik pengujian perangkat lunak yang memverifikasi kemampuan perangkat lunak untuk pulih dari kegagalan seperti kerusakan perangkat lunak atau perangkat keras dan kegagalan jaringan. Tujuan pengujian pemulihan adalah untuk menentukan apakah operasi perangkat lunak dapat dilanjutkan setelah bencana atau kehilangan integritas. Pengujian pemulihan melibatkan pengembalian perangkat lunak ke titik di mana integritas diketahui, dan pemrosesan ulang transaksi hingga titik kegagalan.
Dalam rekayasa perangkat lunak, pengujian pemulihan adalah jenis dari pengujian non-fungsional — pengujian ini mencakup aspek-aspek yang tidak terkait dengan fungsi atau tindakan pengguna tertentu, seperti skalabilitas atau keamanan. Pengujian dilakukan oleh penguji profesional, dan data cadangan yang memadai disimpan di lokasi yang aman sebelumnya.
Contoh Pengujian Pemulihan
Dua skenario menunjukkan teknik ini dalam bentuknya yang paling sederhana. Pada masing-masing skenario, kegagalan sengaja dipaksakan, kemudian aplikasi diamati saat melanjutkan operasinya.
- Gangguan jaringan: Saat aplikasi sedang menerima data dari jaringan, cabut kabel penghubung. Setelah beberapa waktu, colokkan kembali dan analisis kemampuan aplikasi untuk terus menerima data dari titik di mana koneksi terputus.
- Pemulihan sesi: Restart sistem saat browser memiliki sejumlah sesi yang terbuka, dan periksa apakah browser dapat memulihkan semua sesi tersebut.
Ilustrasi di bawah ini menyajikan ide yang sama dalam bentuk visual.
Waktu yang dibutuhkan untuk pulih tergantung pada:
- Jumlah titik restart
- Volume data yang disimpan oleh aplikasi
- Pelatihan dan keterampilan orang-orang yang melakukan kegiatan pemulihan, serta alat-alat yang tersedia untuk pemulihan.
Jika terjadi beberapa kegagalan, pengujian pemulihan harus dilakukan secara terstruktur, bukan sekaligus — dilakukan untuk satu segmen lalu segmen lainnya.
Siklus Hidup Proses Pemulihan
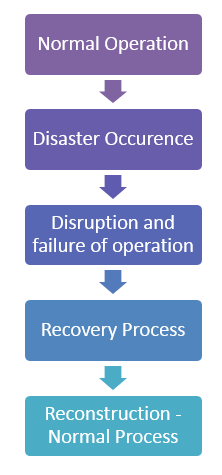
Sebelum merancang kasus uji, ada baiknya untuk melihat di mana uji pemulihan berperan. Siklus hidup proses pemulihan memiliki lima langkah:
- Operasi normal
- Terjadinya bencana
- Gangguan dan kegagalan operasi
- Penghapusan bencana melalui proses pemulihan
- Rekonstruksi seluruh proses dan informasi, mengembalikan seluruh sistem ke operasi normal.
Diagram alur di bawah ini menunjukkan kelima tahapan tersebut secara berurutan.
Mari kita bahas kelima langkah ini secara detail:
- Operasi normal. Suatu sistem yang terdiri dari perangkat keras, perangkat lunak, dan firmware, yang terintegrasi untuk mencapai tujuan bersama, menjalankan tugas yang dirancang tanpa gangguan dalam jangka waktu yang ditentukan.
- Terjadinya bencana. Gangguan dapat terjadi karena kerusakan perangkat lunak, yang disebabkan oleh hal-hal seperti kerusakan yang dipicu oleh input, kerusakan akibat kegagalan perangkat keras, atau kerusakan akibat kebakaran, pencurian, atau pemogokan.
- Gangguan dan kegagalan. Ini adalah fase paling menyakitkan, yang menyebabkan kerugian bisnis, hubungan yang rusak, hilangnya peluang, hilangnya jam kerja, dan, yang tak terhindarkan, kerugian finansial dan reputasi baik. Rencana pemulihan bencana meminimalkan fase ini.
- Pembersihan pasca bencana. Jika rencana cadangan dan proses mitigasi risiko sudah tersedia, pemulihan akan membutuhkan waktu dan upaya yang jauh lebih sedikit. Tim yang ditunjuk, dengan peran masing-masing orang yang ditentukan sebelumnya, akan menetapkan tanggung jawab dan mencegah periode gangguan yang panjang.
- Rekonstruksi. Hal ini mungkin memerlukan beberapa sesi operasi untuk membangun kembali semua folder beserta file konfigurasi. Dokumentasi yang tepat dan proses rekonstruksi yang terdefinisi diperlukan untuk pemulihan yang benar.
Strategi Restorasi
Tim pemulihan harus memiliki strategi sendiri untuk mengambil kode dan data penting guna mengembalikan operasional ke kondisi normal. Strategi tersebut unik untuk setiap organisasi, berdasarkan tingkat kekritisan sistem yang ditanganinya, dan untuk sistem kritis, hal itu bermuara pada serangkaian pilihan:
- Satu cadangan, atau lebih dari satu
- Beberapa cadangan di satu tempat, atau di tempat yang berbeda.
- Pencadangan daring, atau pencadangan luring
- Pencadangan berjalan secara otomatis berdasarkan kebijakan, atau dipicu secara manual.
- Tim restorasi independen, atau tim pengembang yang melakukan pekerjaan tersebut.
Setiap pilihan memiliki faktor biaya, dan beberapa cadangan mungkin akan menghabiskan lebih banyak sumber daya fisik atau membutuhkan tim independen. Ketergantungan juga penting: perusahaan rentan melalui kode dan data yang mereka simpan dengan satu penyedia, dan skala besar AWS Gangguan tersebut berulang kali menyebabkan layanan konsumen ternama tidak dapat diakses pada saat yang bersamaan. Kemampuan pemulihan independen sangat penting dalam kasus seperti ini.
Bagaimana melakukan Pengujian Pemulihan
Setelah strategi ditetapkan, pertanyaan selanjutnya adalah bagaimana pengujian itu sendiri disiapkan. Poin-poin berikut harus dipertimbangkan saat melakukan pengujian pemulihan.
- Buatlah lingkungan pengujian yang sedekat mungkin dengan kondisi penerapan sebenarnya: antarmuka, protokol, firmware, perangkat keras, dan perangkat lunak harus sesuai dengan lingkungan produksi.
- Meskipun pengujian menyeluruh mungkin memakan waktu dan biaya, konfigurasi yang identik dan pemeriksaan lengkap tetap harus dilakukan.
- Jika memungkinkan, ujilah pada perangkat keras yang nantinya akan dipulihkan — terutama saat memulihkan ke mesin yang berbeda dari mesin yang membuat cadangan.
- Beberapa sistem pencadangan mengharapkan ukuran hard drive sama persis dengan ukuran tempat pencadangan diambil.
- Kelola keusangan: teknologi hard drive berkembang pesat, dan hard drive lama mungkin tidak kompatibel dengan yang baru. Memulihkan ke mesin virtual Hal ini membantu, karena perangkat lunak virtualisasi dapat meniru perangkat keras yang ada, termasuk ukuran disk.
- Sistem pencadangan daring tidak terkecuali dari pengujian. Sebagian besar penyedia melindungi pengguna dari masalah media melalui penyimpanan yang toleran terhadap kesalahan, sehingga kegagalan baru muncul belakangan.
- Meskipun sistem pencadangan daring sangat andal, sisi pemulihan harus diuji untuk memastikan tidak ada masalah dengan pengambilan data, keamanan, atau enkripsi.
Karena pemulihan dilakukan dari awal hingga akhir, lari ini biasanya dijadwalkan bersamaan dengan... pengujian sistem alih-alih pada tingkat unit.
Prosedur Pengujian Setelah Restorasi
Memulihkan data hanyalah setengah dari keseluruhan proses; salinan yang dipulihkan masih harus dibuktikan dapat digunakan. Sebagian besar perusahaan besar memiliki auditor independen yang menjalankan latihan pemulihan secara berkala. Rencana pemulihan bencana yang komprehensif mahal untuk dipelihara dan diuji, sehingga organisasi yang lebih kecil sering mengandalkan cadangan dan penyimpanan di luar lokasi sebagai gantinya.
Setelah folder dan file dipulihkan, pemeriksaan berikut akan memastikan bahwa pemulihan telah dilakukan dengan benar:
- Ganti nama folder dokumen yang rusak agar salinan yang dipulihkan tidak tertukar dengannya.
- Hitung jumlah file di dalam folder yang dipulihkan dan bandingkan jumlah tersebut dengan folder aslinya.
- Buka beberapa file dengan aplikasi yang biasanya menggunakannya, dan pastikan data dapat dijelajahi dan diperbarui seperti biasa.
- Buka beberapa file dengan tipe berbeda — gambar, MP3surat dan dokumen, sebagian besar dan sebagian kecil.
- Gunakan utilitas perbandingan file dan direktori yang paling umum digunakan. sistem operasi menyediakan.
