
Gudang data Architekstur, Komponen & Diagram Concepts
 Tim Editorial
⚡ Ringkasan Cerdas
Gudang data ArchiTecture mendefinisikan bagaimana data historis dan kumulatif dari berbagai sumber diorganisasikan ke dalam lapisan bertingkat dan komponen yang terhubung, memungkinkan pelaporan, analisis, dan satu versi kebenaran yang andal untuk pengambilan keputusan dan peramalan organisasi.
Gudang data Concepts
A data warehouse Tujuannya adalah untuk memberikan perusahaan satu versi kebenaran yang tunggal untuk pengambilan keputusan dan peramalan. Ini adalah sistem informasi yang menyimpan data historis dan kumulatif yang diambil dari satu atau banyak sumber.
Dengan mengorganisir data tersebut untuk analisis, bukan transaksi, gudang data menyederhanakan pekerjaan pelaporan dan analisis seluruh organisasi.

Karakteristik Gudang Data
Gudang data memiliki empat karakteristik utama yang membedakannya dari basis data operasional biasa:
- Berorientasi Subjek
- Integrado
- Variasi Waktu
- Tidak mudah menguap
Berorientasi Subjek
Gudang data berorientasi subjek karena memberikan informasi tentang suatu tema, bukan tentang operasional perusahaan yang sedang berjalan. Subjek tipikal meliputi penjualan, pemasaran, dan distribusi.
Alih-alih pemrosesan sehari-hari, gudang data ini menekankan pemodelan dan analisis untuk pengambilan keputusan. Gudang data ini menawarkan pandangan yang sederhana dan ringkas tentang setiap subjek dan menghilangkan data yang tidak mendukung proses pengambilan keputusan.
Integrado
Integrasi terkait erat dengan orientasi subjek. Dalam gudang data, integrasi berarti menetapkan satuan ukuran umum untuk semua data serupa yang diambil dari basis data yang berbeda, dan menyimpan data tersebut dengan cara yang umum dan dapat diterima secara universal.
Gudang data dibangun dengan mengintegrasikan data dari berbagai sumber seperti mainframe, basis data relasional, dan file teks biasa. Selain itu, gudang data juga harus menjaga konsistensi konvensi penamaan, format, dan pengkodean.
Konsistensi dalam penamaan, ukuran atribut, dan struktur pengkodean inilah yang memungkinkan analisis yang efektif. Perhatikan contoh berikut:
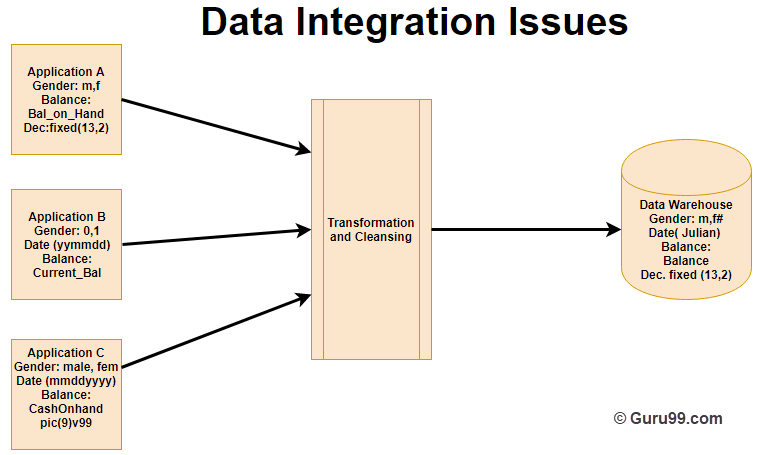
Pada contoh di atas, tiga aplikasi yang diberi label A, B, dan C masing-masing menyimpan informasi Jenis Kelamin, Tanggal, dan Saldo, tetapi setiap aplikasi menyimpannya dengan cara yang berbeda:
- Aplikasi A menyimpan kolom jenis kelamin sebagai nilai logis seperti M atau F.
- Aplikasi B menyimpan kolom jenis kelamin sebagai nilai numerik.
- Aplikasi C menyimpan kolom jenis kelamin sebagai nilai karakter.
- Variasi yang sama berlaku untuk kolom Tanggal dan Saldo.
Setelah proses transformasi dan pembersihan, semua data ini disimpan dalam format umum di dalam gudang data.
Variasi Waktu
Cakupan waktu dari sebuah data warehouse jauh lebih luas daripada sistem operasional. Data dikenali dengan periode tertentu dan menawarkan sudut pandang historis, sehingga selalu mengandung unsur waktu, baik secara eksplisit maupun implisit.
Salah satu tempat munculnya variasi waktu ini adalah dalam struktur kunci rekaman. Setiap kunci utama dalam gudang data harus memuat elemen waktu, seperti hari, minggu, atau bulan.
Aspek lain dari variasi waktu adalah bahwa setelah data dimasukkan ke dalam gudang data, data tersebut tidak dapat diperbarui atau diubah.
Tidak mudah menguap
Data warehouse juga bersifat non-volatil, yang berarti data sebelumnya tidak terhapus ketika data baru datang. Data tersebut hanya dapat dibaca dan diperbarui secara berkala, yang membantu analis mempelajari data historis dan memahami apa yang terjadi dan kapan.
Karena tidak memerlukan pemrosesan transaksi, pemulihan, atau kontrol konkurensi, gudang data menghilangkan aktivitas penghapusan, pembaruan, dan penyisipan yang umum dalam aplikasi operasional. Hanya dua operasi data yang dilakukan dalam gudang data:
- Pemuatan data
- Akses data
Tabel di bawah ini menyoroti beberapa perbedaan utama antara aplikasi operasional dan gudang data:
| OperaAplikasi nasional | Gudang data |
|---|---|
| Program yang kompleks harus dikodekan untuk memastikan bahwa proses pemutakhiran data mempertahankan integritas tinggi dari produk akhir. | Masalah semacam ini tidak terjadi karena pembaruan data tidak dilakukan. |
| Data ditempatkan dalam bentuk yang dinormalisasi untuk memastikan redundansi minimal. | Data tidak disimpan dalam bentuk yang dinormalisasi. |
| Teknologi yang dibutuhkan untuk mendukung permasalahan transaksi, pemulihan data, pengembalian data (rollback), dan penyelesaian kebuntuan (deadlock) cukup kompleks. | Ini menawarkan kesederhanaan relatif dalam teknologi. |
Gudang data Architekstur
Gudang data ArchiStruktur ini kompleks karena sistem menyimpan data historis dan kumulatif dari berbagai sumber. Ada tiga pendekatan untuk membangun lapisan gudang data: satu tingkat, dua tingkat, dan tiga tingkat.
Arsitektur tingkat tunggal Bertujuan untuk meminimalkan jumlah data yang disimpan dengan menghilangkan redundansi. Metode ini jarang digunakan dalam praktik.
Arsitektur dua tingkat Memisahkan sumber data yang tersedia secara fisik dari gudang data. Sistem ini tidak mudah diperluas, mendukung lebih sedikit pengguna akhir, dan dapat mengalami masalah konektivitas karena keterbatasan jaringan.
Arsitektur tiga tingkat merupakan desain data warehouse yang paling banyak digunakan.
Struktur ini terdiri dari tingkatan atas, tengah, dan bawah:
- Tingkat Bawah: Basis data gudang berfungsi sebagai lapisan paling bawah. Biasanya berupa sistem basis data relasional, dan data dibersihkan, ditransformasikan, dan dimuat ke lapisan ini menggunakan alat-alat back-end.
- Tingkat Menengah: Lapisan tengah adalah server OLAP yang diimplementasikan menggunakan model ROLAP atau MOLAP. Ini menghadirkan sebuah antarmuka absolut.tracmemberikan pandangan menyeluruh terhadap basis data dan bertindak sebagai mediator antara pengguna akhir dan basis data.
- Tingkat atas: Lapisan teratas adalah lapisan klien front-end. Lapisan ini berisi alat dan API yang digunakan untuk terhubung dan mengambil data dari gudang data, seperti alat kueri, alat pelaporan, alat kueri terkelola, alat analisis, dan alat penambangan data.
Komponen Gudang Data
Komponen dan arsitektur keseluruhan dari sebuah data warehouse bekerja bersama-sama seperti yang ditunjukkan pada diagram di bawah ini.
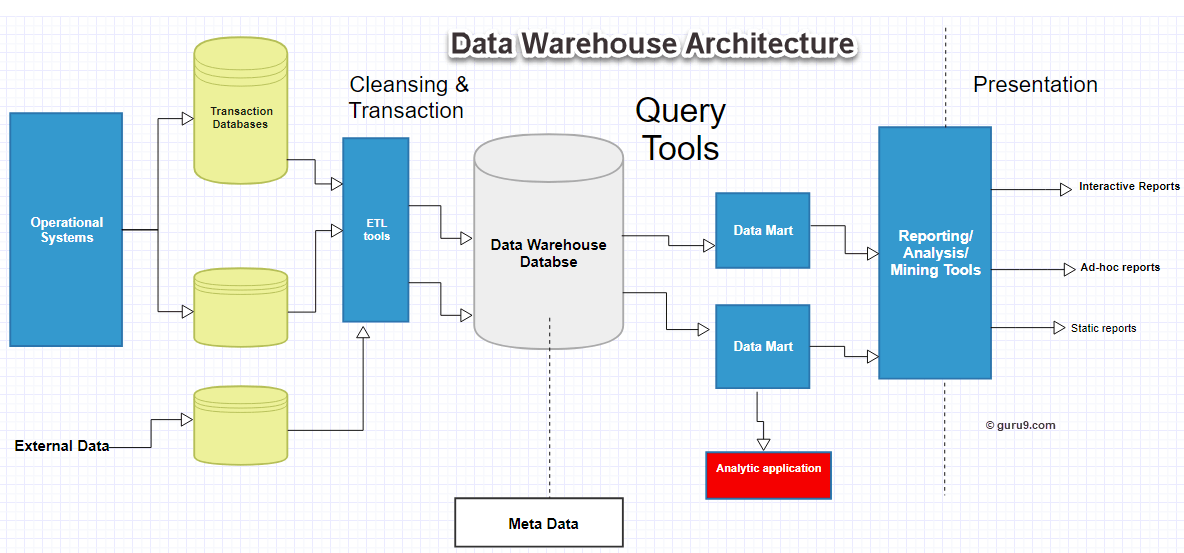
Gudang data ini berbasis pada server RDBMS, sebuah repositori informasi pusat yang dikelilingi oleh komponen-komponen kunci yang menjaga agar seluruh lingkungan tetap berfungsi, mudah dikelola, dan dapat diakses.
Sebuah data warehouse memiliki lima komponen utama, yang dijelaskan di bawah ini.
Basis Data Gudang Data
Basis data pusat adalah fondasi dari lingkungan pergudangan dan diimplementasikan pada RDBMS teknologi. Karena RDBMS tradisional disetel untuk pemrosesan transaksi dan bukan untuk penyimpanan data, operasi yang membutuhkan banyak sumber daya seperti kueri ad-hoc, penggabungan multi-tabel, dan agregasi dapat memperlambatnya.
Oleh karena itu, digunakan pendekatan basis data alternatif:
- Basis data relasional diimplementasikan secara paralel untuk memungkinkan skalabilitas, menggunakan model memori bersama atau tanpa memori bersama pada berbagai konfigurasi multiprosesor atau paralel masif.
- Struktur indeks baru digunakan untuk menghindari pemindaian tabel relasional dan meningkatkan kecepatan.
- Basis data multidimensi (MDDB) digunakan untuk mengatasi keterbatasan model gudang data relasional. Contohnya adalah Essbase. Oracle.
Alat Pengadaan, Akuisisi, Pembersihan dan Transformasi (ETL)
Alat pengumpulan, transformasi, dan migrasi data melakukan semua konversi, peringkasan, dan perubahan yang diperlukan untuk mengubah data menjadi format gudang data yang terpadu. Alat-alat ini juga disebut Ex.tracalat t, Transform, dan Load (ETL).
Fungsi-fungsi tersebut meliputi hal-hal berikut:
- Anonimkan data sesuai ketentuan peraturan.
- Singkirkan data yang tidak diinginkan dari basis data operasional sebelum dimuat ke gudang.
- Cari dan ganti nama dan definisi umum untuk data yang berasal dari sumber berbeda.
- Hitung ringkasan dan data turunan.
- Isi data yang hilang dengan nilai default.
- Menghilangkan duplikasi data berulang yang berasal dari berbagai sumber.
Ini Alat ETL dapat menghasilkan tugas cron, tugas latar belakang, program Cobol, dan skrip shell yang secara teratur memperbarui gudang data dan membantu memelihara metadata.
Karena mengambil data dari banyak sistem, alat ETL juga harus mampu mengatasi heterogenitas basis data dan data.
Metadata
Metadata mungkin terdengar canggih, tetapi sebenarnya hanyalah data tentang data yang mendefinisikan gudang data. Metadata digunakan untuk membangun, memelihara, dan mengelola gudang data.
Dalam arsitektur tersebut, metadata menentukan sumber, penggunaan, nilai, dan fitur data serta mendefinisikan bagaimana data dapat diubah dan diproses, sehingga tetap terhubung erat dengan gudang data.
Sebagai contoh, sebuah baris dalam basis data penjualan dapat berisi:
4030 KJ732 299.90
Ini tidak ada artinya sampai metadata menjelaskan bahwa itu mewakili nomor model 4030, ID Agen Penjualan KJ732, dan total jumlah penjualan sebesar $299.90.
Oleh karena itu, metadata merupakan unsur penting dalam mengubah data menjadi pengetahuan, dan membantu menjawab pertanyaan-pertanyaan seperti:
- Tabel, atribut, dan kunci apa saja yang terdapat dalam gudang data tersebut?
- Dari mana datanya berasal?
- Berapa kali data dimuat ulang?
- Transformasi dan pembersihan apa yang diterapkan?
Metadata terbagi menjadi dua kategori:
- Metadata Teknis: Ini menjelaskan gudang bagi para desainer dan administrator yang membangun dan menjalankannya.
- Metadata Bisnis: Hal ini memberikan kemudahan bagi pengguna akhir untuk memahami informasi yang tersimpan di gudang data.
Alat Kueri
Tujuan utama dari data warehousing adalah untuk memberikan informasi yang dibutuhkan bisnis untuk membuat keputusan strategis, dan alat kueri adalah cara pengguna berinteraksi dengan sistem tersebut.
Alat-alat ini terbagi dalam empat kategori:
- Alat kueri dan pelaporan
- Alat pengembangan aplikasi
- Alat penambangan data
- alat OLAP
Alat Kueri dan Pelaporan
Alat kueri dan pelaporan terbagi menjadi dua kelompok: alat pelaporan dan alat kueri terkelola.
Alat pelaporan terbagi lagi menjadi alat pelaporan produksi dan penulis laporan desktop:
- Para penulis laporan: Ini dirancang untuk pengguna akhir yang membuat analisis mereka sendiri.
- Pelaporan produksi: Perangkat lunak ini memungkinkan organisasi untuk menghasilkan laporan operasional reguler dan mendukung pekerjaan batch bervolume tinggi seperti pencetakan dan perhitungan. Contoh populer termasuk Brio, Business Objects, Oracle, PowerSoft, dan SAS Institute.
Alat kueri terkelola Membantu pengguna akhir dengan menyisipkan lapisan meta antara pengguna dan basis data, yang menyembunyikan kompleksitas SQL dan struktur basis data.
Alat Pengembangan Aplikasi
Ketika alat grafis dan analitik bawaan tidak dapat memenuhi kebutuhan analitik suatu organisasi, laporan khusus dibuat dengan menggunakan alat pengembangan aplikasi.
Alat Penambangan Data
Penambangan data menemukan korelasi, pola, dan tren baru yang bermakna di dalam volume data yang besar, dan alat penambangan data mengotomatiskan penemuan tersebut.
Alat OLAP
OLAP Alat-alat tersebut dibangun di atas basis data multidimensi dan memungkinkan pengguna untuk menganalisis data melalui tampilan multidimensi yang rumit.
Bus Gudang Data Architekstur
Bus gudang data menentukan bagaimana data mengalir melalui gudang data. Aliran tersebut dapat dikategorikan sebagai aliran masuk (inflow), aliran naik (upflow), aliran turun (downflow), aliran keluar (outflow), dan aliran meta (meta-flow).
Saat mendesain bus, Anda harus memperhitungkan dimensi dan fakta bersama yang mencakup berbagai data mart.
Data Mart
A data mart adalah lapisan akses yang digunakan untuk mengirimkan data kepada pengguna. Ini cocok untuk gudang data besar karena membutuhkan waktu dan biaya yang lebih sedikit untuk membangunnya, meskipun tidak ada definisi tunggal yang disepakati tentang data mart.
Secara sederhana, data mart adalah bagian dari data warehouse. Data mart mempartisi data untuk kelompok pengguna tertentu dan dapat berada di database yang sama dengan data warehouse atau di database yang terpisah secara fisik.
Gudang data Archipraktik terbaik
Untuk merancang arsitektur data warehouse yang baik, ikuti praktik terbaik di bawah ini:
- Gunakan model gudang data yang dioptimalkan untuk pengambilan informasi, baik itu dimensi, pendekatan denormalisasi, atau hibrida.
- Pilih pendekatan desain yang tepat, baik dari atas ke bawah maupun dari bawah ke atas.
- Pastikan data diproses dengan cepat dan akurat sambil mengkonsolidasikannya menjadi satu versi kebenaran yang tunggal.
- Rancanglah proses akuisisi dan pembersihan data untuk gudang data dengan cermat.
- Rancang arsitektur metadata yang memungkinkan metadata untuk dibagikan antar komponen gudang data.
- Pertimbangkan sebuah OperaModel National Data Store (ODS) ketika kebutuhan pengambilan data berada di bagian bawah abstraksi data.tracpiramida tion atau ketika beberapa sumber operasional harus diakses.
- Pastikan model data terintegrasi dan bukan hanya dikonsolidasikan; dalam hal ini, gunakan model data 3NF, yang juga ideal saat memperoleh alat ETL dan pembersihan data.
