
MongoDB Regularni izraz ($regex) s primjerima
 Uredništvo
⚡ Pametni sažetak
MongoDB Regularni izrazi izvode usklađivanje uzoraka kako bi pronašli nizove znakova unutar dokumenata, koristeći operator $regex, zastavicu $options za neosjetljivost na velika i mala slova, sidra za točna podudaranja i razdjelnike kose crte kada točna vrijednost polja nije poznata.
Regularni izrazi se koriste za usklađivanje uzoraka, što je u osnovi za pronalaženje nizova znakova unutar dokumenata.
Ponekad prilikom dohvaćanja dokumenata u zbirci možda nećete točno znati koju točnu vrijednost polja tražite. Stoga se regularni izrazi mogu koristiti kao pomoć u dohvaćanju podataka na temelju vrijednosti pretraživanja podudaranja uzoraka.
Korištenje operatora $regex za podudaranje uzorka
Operator $regex u MongoDB koristi se za traženje određenih nizova u kolekciji. Sljedeći primjer pokazuje kako se to može učiniti.
Pretpostavimo da imamo istu kolekciju zaposlenika koja ima nazive polja „Employeeid“ i „EmployeeName“. Također pretpostavimo da u našoj kolekciji imamo sljedeće dokumente.
| ID zaposlenika | ime zaposlenika |
|---|---|
| 22 | NoviMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
Ovdje u donjem kodu koristili smo operator $regex za određivanje kriterija pretraživanja.

db.Employee.find({EmployeeName : {$regex: "Gu" }}).forEach(printjson)
Code Objašnjenje:
- Ovdje želimo pronaći sva imena zaposlenika koja sadrže znak 'Gu'. Stoga navodimo operator $regex kako bismo definirali kriterije pretraživanja za 'Gu'.
- Printjson se koristi za bolji ispis svakog dokumenta koji je vraćen upitom.
Ako je naredba uspješno izvršena, prikazat će se sljedeći izlaz:
Izlaz:

Izlaz jasno pokazuje da se vraćaju oni dokumenti u kojima ime zaposlenika sadrži znakove 'Gu'.
Ako pretpostavimo da vaša kolekcija sadrži sljedeće dokumente s dodatnim dokumentom koji je sadržavao ime zaposlenika kao "Guru999”. Ako ste kriterije pretraživanja unijeli kao „Guru99”, također bi vratio dokument koji je imao „Guru999”. Ali pretpostavimo da to ne želimo i samo želimo vratiti dokument s „Guru99”. Tada to možemo učiniti s točnim podudaranjem uzorka. Za točno podudaranje uzorka koristit ćemo znakove ^ i $. Znak ^ dodat ćemo na početak niza, a $ na kraj niza.
| ID zaposlenika | ime zaposlenika |
|---|---|
| 22 | NoviMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 8 | Guru999 |
Sljedeći primjer pokazuje kako se to može učiniti.
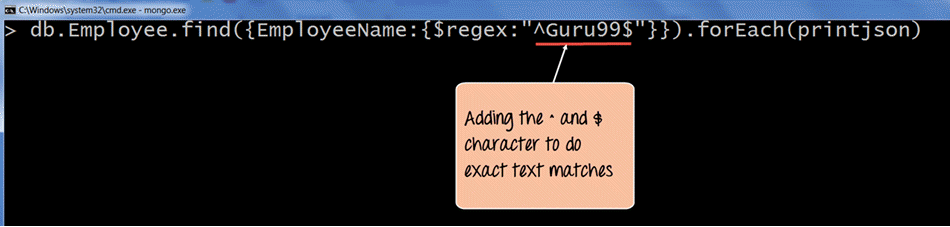
db.Employee.find({EmployeeName : {$regex: "^Guru99$"}}).forEach(printjson)
Code Objašnjenje:
- Ovdje u kriterijima pretraživanja koristimo znakove ^ i $. Znak ^ se koristi kako bi se osiguralo da niz počinje određenim znakom, a znak $ se koristi kako bi se osiguralo da niz završava određenim znakom. Dakle, kada se kod izvrši, dohvatit će samo niz s nazivom „Guru99”.
- Printjson se koristi za bolji ispis svakog dokumenta koji je vraćen upitom.
Ako je naredba uspješno izvršena, prikazat će se sljedeći izlaz:
Izlaz:
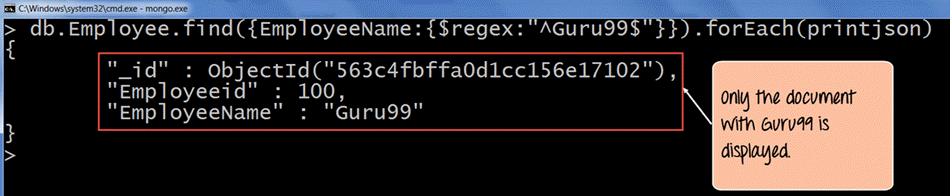
U izlazu je jasno vidljiv niz znakova "GuruDohvaća se 99”.
Usklađivanje uzorka s $opcijama
Prilikom korištenja operatora $regex, moguće je pružiti i dodatne opcije korištenjem $opcije ključna riječ. Na primjer, pretpostavimo da želite pronaći sve dokumente koji imaju 'Gu' u svom imenu zaposlenika, bez obzira na to jesu li osjetljiva na velika ili mala slova. Ako želimo takav rezultat, tada moramo koristiti $opcije s parametrom neosjetljivosti na velika i mala slova.
Sljedeći primjer pokazuje kako se to može učiniti.
Pretpostavimo da imamo istu kolekciju zaposlenika koja ima nazive polja „Employeeid“ i „EmployeeName“.
Pretpostavimo također da u našoj zbirci imamo sljedeće dokumente.
| ID zaposlenika | ime zaposlenika |
|---|---|
| 22 | NoviMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
Ako pokrenemo isti upit kao u prošloj temi, nikada nećemo vidjeti dokument s "GURU99" u rezultatu. Kako bismo osigurali da se ovo pojavi u skupu rezultata, moramo dodati parametar "i" za $options.
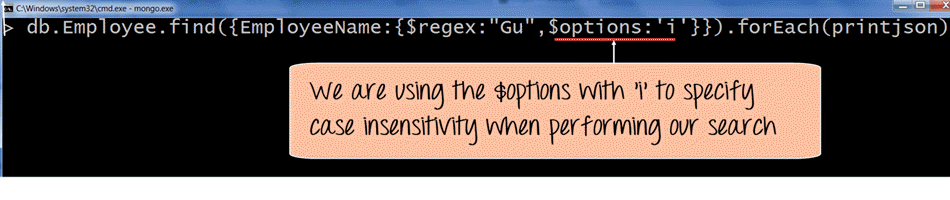
db.Employee.find({EmployeeName:{$regex: "Gu",$options:'i'}}).forEach(printjson)
Code Objašnjenje:
- $options s parametrom 'i' (što znači neosjetljivost na velika i mala slova) određuje da želimo izvršiti pretragu bez obzira na to jesu li slova 'Gu' napisana malim ili velikim slovom.
Ako je naredba uspješno izvršena, prikazat će se sljedeći izlaz:
Izlaz:
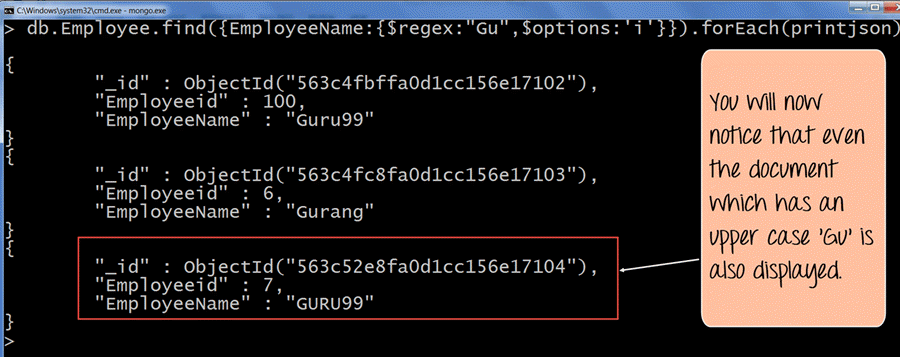
- Izlaz jasno pokazuje da iako jedan dokument sadrži veliko slovo 'Gu', taj se dokument i dalje prikazuje u skupu rezultata.
Uparivanje uzorka bez operatora regularnog izraza
Također se može izvršiti usklađivanje uzoraka bez operatora $regex. Sljedeći primjer pokazuje kako se to može učiniti.
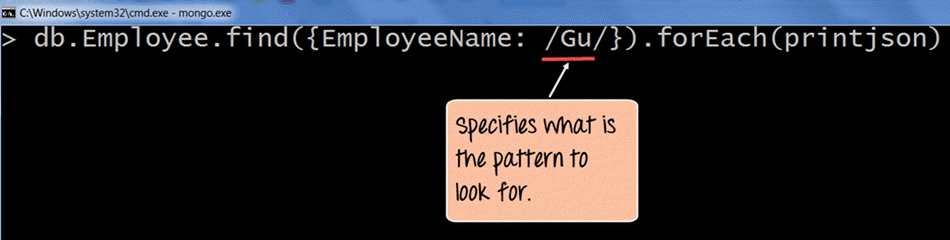
db.Employee.find({EmployeeName: /Gu/}).forEach(printjson)
Code Objašnjenje:
- Razdjelnici "//" u osnovi znače određivanje kriterija pretraživanja unutar tih razdjelnika. Stoga navodimo /Gu/ kako bismo ponovno pronašli one dokumente koji u nazivu zaposlenika imaju 'Gu'.
Ako je naredba uspješno izvršena, prikazat će se sljedeći izlaz:
Izlaz:
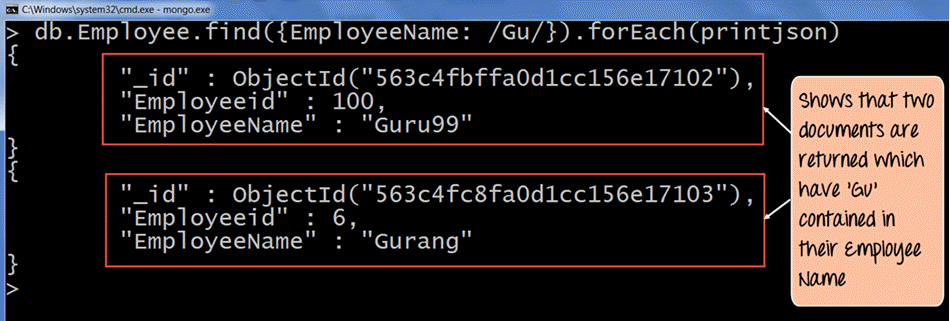
Izlaz jasno pokazuje da se vraćaju oni dokumenti u kojima ime zaposlenika sadrži znakove 'Gu'.
Dohvaćanje posljednjih 'n' dokumenata iz zbirke
Postoje različiti načini za dobivanje zadnjih n dokumenata u zbirci.
Pogledajmo jedan od načina kroz sljedeće korake.
Sljedeći primjer pokazuje kako se to može učiniti.
Pretpostavimo da imamo istu kolekciju zaposlenika koja ima nazive polja „Employeeid“ i „EmployeeName“.
Pretpostavimo također da u našoj zbirci imamo sljedeće dokumente:
| ID zaposlenika | ime zaposlenika |
|---|---|
| 22 | NoviMartin |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
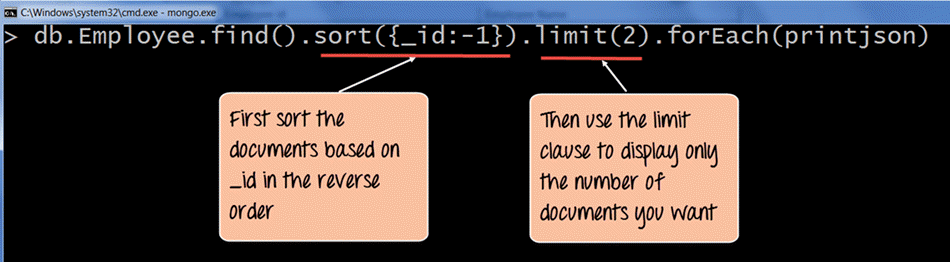
db.Employee.find().sort({_id:-1}).limit(2).forEach(printjson)
Code Objašnjenje:
- Prilikom upita za dokumente, koristite funkciju sortiranja za sortiranje zapisa obrnutim redoslijedom na temelju vrijednosti polja _id u kolekciji. -1 u osnovi označava sortiranje dokumenata obrnutim redoslijedom ili silaznim redoslijedom tako da posljednji dokument postane prvi dokument koji će se prikazati.
- Zatim upotrijebite klauzulu ograničenja za prikaz željenog broja zapisa. Ovdje smo postavili klauzulu ograničenja (2), tako da će dohvatiti posljednja dva dokumenta.
Ako je naredba uspješno izvršena, prikazat će se sljedeći izlaz:
Izlaz:
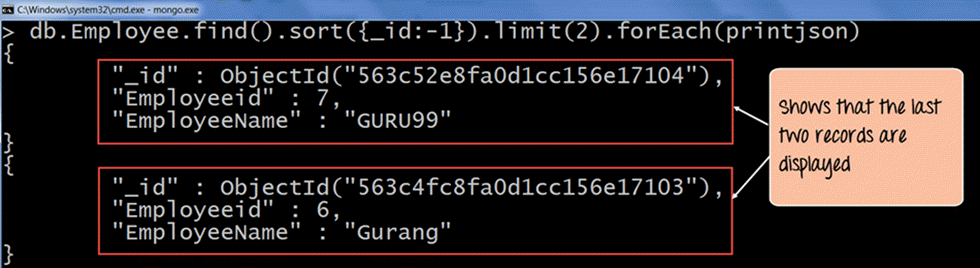
Izlaz jasno pokazuje da su prikazana posljednja dva dokumenta u zbirci. Stoga smo jasno pokazali da za dohvaćanje posljednjih 'n' dokumenata u zbirci, možemo prvo sortirati dokumente silaznim redoslijedom, a zatim koristiti klauzulu o ograničenju da vratimo 'n' broj dokumenata koji su potrebni.
bilješke: Ako se pretraživanje izvodi na nizu koji je veći od recimo 38,000 XNUMX znakova, neće prikazati prave rezultate.
