
Příklad Hadoop MapReduce: První Java Program s Code
 Prafulla Ranadive
⚡ Chytré shrnutí
Programy Hadoop MapReduce jsou psány jako tři Java třídy, mapper, reducer a driver, které jsou zkompilovány, zabaleny do JAR souboru a odeslány do clusteru pro počítání prodejů v jednotlivých zemích.
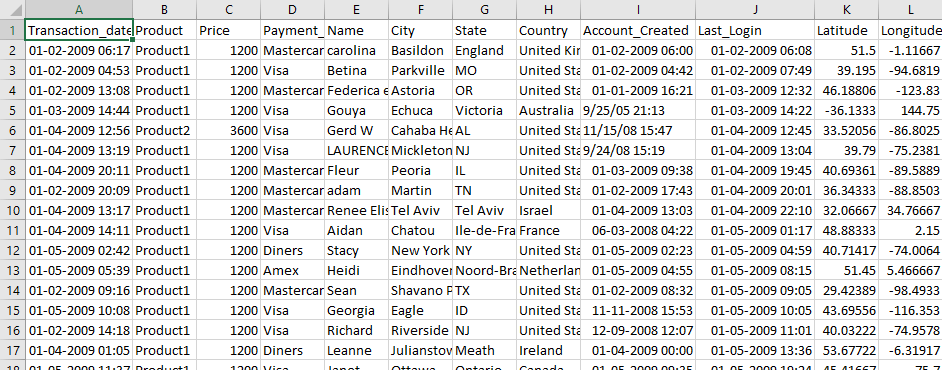
V tomto tutoriálu se naučíte používat Hadoop s příklady MapReduce. Použitá vstupní data jsou ProdejJan2009.csvObsahuje informace související s prodejem, jako je název produktu, cena, způsob platby, město a země klienta. Cílem je zjistit počet prodaných produktů v každé zemi.
První program Hadoop MapReduce
Nyní v tomto Výukový program MapReduce, vytvoříme náš první Java Program MapReduce:
Níže uvedený snímek obrazovky ukazuje nezpracovaná data SalesJan2009, kde každý řádek představuje jednu transakci a země se nachází v osmém sloupci odděleném čárkami.
Ujistěte se, že máte nainstalovaný Hadoop. Než začnete s procesem, změňte uživatele na „hduser“ (ID použité při konfiguraci Hadoopu – můžete přepnout na ID uživatele použité během vaší vlastní konfigurace Hadoopu).
su - hduser_
Výzva se změní na účet hduser, jak je znázorněno níže.

Krok 1) Vytvořte adresář projektu a zdrojové soubory
Vytvořte nový adresář s názvem MapReduceTutorial, jak je znázorněno v níže uvedeném příkladu MapReduce.
sudo mkdir MapReduceTutorial

Udělit oprávnění
sudo chmod -R 777 MapReduceTutorial

Vytvořte tři Java zdrojové soubory níže v MapReduceTutorial. Všimněte si, že všechny tři používají starší org.apache.hadoop.mapred API, které je stále dodáváno s Hadoopem 3.x.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
Archiv se rozbalí do stejných tří zdrojových souborů, jak je zde znázorněno.
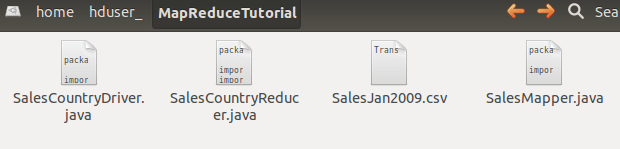
Zkontrolujte souborová oprávnění všech těchto souborů

Pokud chybí oprávnění pro „čtení“, udělte je:

Krok 2) Export třídní cesty Hadoopu
Exportujte cestu ke třídám, jak je znázorněno v níže uvedeném příkladu Hadoopu.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Exportovaná cesta ke třídám se zobrazí zpět v příkazovém řádku.

Krok 3) Zkompilujte Java soubory
Zkompilujte Java soubory (tyto soubory se nacházejí v adresáři Final-MapReduceHandsOn). Jejich soubory tříd budou umístěny do adresáře balíčku.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
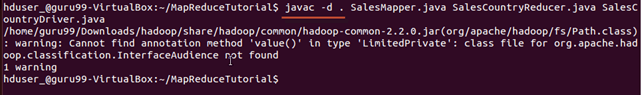
Toto varování lze bezpečně ignorovat – pouze hlásí, že mapované API je zastaralé.
Tato kompilace vytvoří v aktuálním adresáři adresář s názvem balíčku uvedeným v Java zdrojový soubor (tj. v našem případě SalesCountry) a vložte do něj všechny zkompilované soubory tříd.

Krok 4) Vytvořte soubor manifestu
Vytvořte nový soubor Manifest.txt
sudo gedit Manifest.txt
Přidejte k němu následující řádek:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver je název hlavní třídy. Upozorňujeme, že na konci tohoto řádku je nutné stisknout klávesu Enter.
Krok 5) Zabalte třídy do sklenice
Vytvořte soubor Jar
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Zkontrolujte, zda je vytvořen soubor jar

Krok 6) Spuštění Hadoopu
Spusťte Hadoop
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Krok 7) Zkopírujte vstupní soubor do HDFS
Zkopírujte soubor SalesJan2009.csv do ~/inputMapReduce.
Nyní použijte níže uvedený příkaz ke zkopírování ~/inputMapReduce do HDFS.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
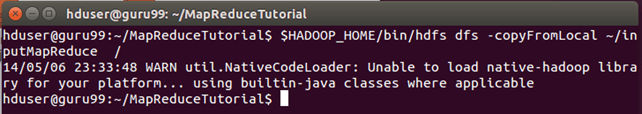
Toto varování můžeme klidně ignorovat.
Ověřte, zda je soubor skutečně zkopírován nebo ne.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Krok 8) Spusťte úlohu MapReduce
Spusťte úlohu MapReduce
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Tím se vytvoří výstupní adresář s názvem mapreduce_output_sales on HDFS. Obsahem tohoto adresáře bude soubor obsahující prodeje produktů v jednotlivých zemích.
Krok 9) Přečtěte si výsledky
Výsledek lze vidět prostřednictvím rozhraní příkazu jako:
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
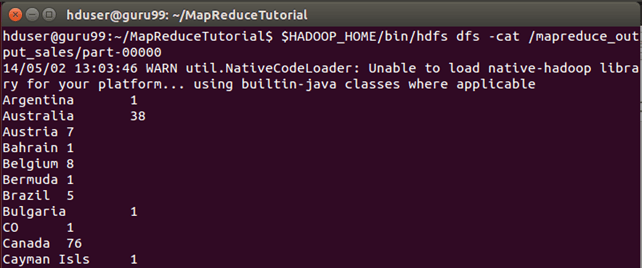
Výsledky lze také zobrazit prostřednictvím webového rozhraní jako-
Otevřená http://localhost:50070/ ve webovém prohlížeči. V systému Hadoop 3.x se webové uživatelské rozhraní NameNode přesunulo na port 9870, takže použijte http://localhost:9870/ tam místo toho.

Nyní vyberte „Procházet souborový systém“ a přejděte do /mapreduce_output_sales

Otevřená část-r-00000

Vysvětlení třídy SalesMapper
V následujících třech částech se budeme věnovat tomu, co každá třída dělá, a to od začátku do konce.
V této části se budeme zabývat implementací třídy SalesMapper.
1. Začneme zadáním názvu balíčku pro naši třídu. SalesCountry je název našeho balíčku. Upozorňujeme, že výstup kompilace, SalesMapper.class, bude uložen do adresáře s tímto názvem balíčku: SalesCountry.
Poté importujeme balíčky knihoven.
Níže uvedený snímek ukazuje implementaci třídy SalesMapper -

Vzorek Code Vysvětlení:
1. Definice třídy SalesMapper-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Každá třída mapperu musí být rozšířena z třídy MapReduceBase a musí implementovat rozhraní Mapper.
2. Definování funkce 'mapa'-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
Hlavní částí třídy Mapper je metoda 'map()', která přijímá čtyři argumenty.
Při každém volání metody 'map()' se předává pár klíč-hodnota (v tomto kódu 'key' a 'value').
Metoda 'map()' začíná rozdělením vstupního textu, který je přijat jako argument. Každý řádek rozdělí na pole.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Zde se jako oddělovač používá ','.
Poté se vytvoří dvojice s použitím záznamu na 7. indexu pole 'SingleCountryData' a hodnoty '1'.
output.collect(new Text(SingleCountryData[7]), one);
Vybíráme záznam na 7. indexu, protože potřebujeme data o zemi a ta se nachází na 7. indexu v poli 'SingleCountryData'.
Vezměte prosím na vědomí, že naše vstupní data jsou v níže uvedeném formátu (kde země je na 7. indexu, přičemž 0 je počáteční index) -
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
Výstupem mapperu je opět pár klíč-hodnota, který je vygenerován pomocí metody 'collect()' třídy 'OutputCollector'.
Vysvětlení třídy SalesCountryReducer
V této části se budeme zabývat implementací třídy SalesCountryReducer.
1. Začneme zadáním názvu balíčku pro naši třídu. SalesCountry je název našeho balíčku. Upozorňujeme, že výstup kompilace, SalesCountryReducer.class, bude uložen do adresáře s tímto názvem balíčku: SalesCountry.
Poté importujeme balíčky knihoven.
Níže uvedený snímek ukazuje implementaci třídy SalesCountryReducer -
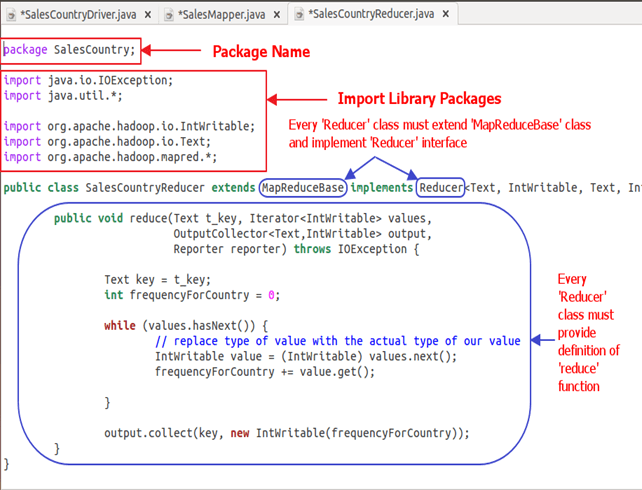
Code Vysvětlení:
1. Definice třídy SalesCountryReducer-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
První dva datové typy, „Text“ a „IntWritable“, zde představují datový typ vstupního páru klíč-hodnota pro reduktor.
Výstup mapperu je ve tvaru , Tento výstup mapperu se stává vstupem pro reducer. Pro zarovnání s jeho datovým typem se zde jako datové typy používají Text a IntWritable.
Poslední dva datové typy, 'Text' a 'IntWritable', jsou datové typy výstupu generovaného reduktorem ve formě páru klíč-hodnota.
Každá třída reduceru musí být rozšířena z třídy MapReduceBase a musí implementovat rozhraní Reducer.
2. Definování funkce 'snížení'-
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
Vstupem do metody reduce() je klíč se seznamem více hodnot.
V našem případě to bude např.
, , , , , .
Toto je dáno reduktoru jako
Pro přijetí argumentů v tomto tvaru se tedy používají první dva datové typy, a to Text a Iterator. Text je datový typ klíče a iterátoru. je datový typ pro seznam hodnot pro daný klíč.
Další argument je typu OutputCollector. který shromažďuje výstup redukční fáze.
Metoda reduce() začíná kopírováním hodnoty klíče a inicializací frequency count na 0.
Text key = t_key;int frequencyForCountry = 0;
Pak pomocí smyčky 'while' iterujeme seznamem hodnot spojených s daným klíčem a sečtením všech hodnot vypočítáme konečnou frekvenci.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Nyní výsledek v podobě klíče a získaného čítače frekvencí odešleme na výstupní kolektor.
Níže uvedený kód to dělá -
output.collect(key, new IntWritable(frequencyForCountry));
Vysvětlení třídy SalesCountryDriver
V této části se budeme zabývat implementací třídy SalesCountryDriver.
1. Začneme zadáním názvu balíčku pro naši třídu. SalesCountry je název našeho balíčku. Upozorňujeme, že výstup kompilace, SalesCountryDriver.class, bude uložen do adresáře s tímto názvem balíčku: SalesCountry.
Zde je řádek určující název balíčku následovaný kódem pro import balíčků knihovny.

2. Definujte třídu ovladače, která vytvoří novou klientskou úlohu, konfigurační objekt a inzeruje třídy Mapper a Reducer.
Třída ovladače je zodpovědná za spuštění naší úlohy MapReduce HadoopV této třídě specifikujeme název úlohy, datový typ vstupu/výstupu a názvy tříd mapperů a reducerů.

3. V níže uvedeném úryvku kódu nastavíme vstupní a výstupní adresáře, které se používají ke spotřebování vstupní datové sady a k produkci výstupu.
arg[0] a arg[1] jsou argumenty příkazového řádku předávané s příkazem zadaným v praktickém cvičení s MapReduce, tj.
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
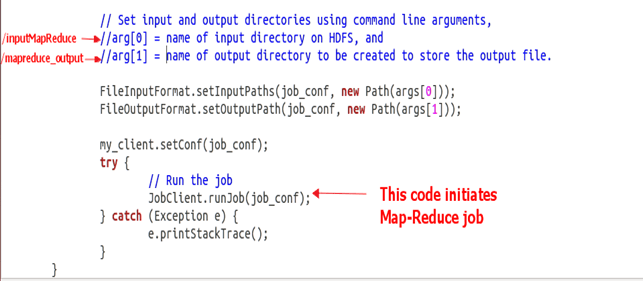
4. Spusťte naši práci
Níže uvedený kód spouští provádění úlohy MapReduce -
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
