
Hadoop Pig Tutorial: Co je Apache Pig? Architecture, Příklad
 Prafulla Ranadive
⚡ Chytré shrnutí
Apache Pig je platforma na vysoké úrovni pro analýzu velkých datových sad na platformě Hadoop, která spojuje jazyk Pig Latin pro tok dat s běhovým prostředím, které kompiluje každý skript do formátů MapReduce, Tez nebo... Spark úlohy automaticky.
Tento tutoriál začíná myšlenkou Apache Pig a poté vás provede jeho instalací a spuštěním kompletního latinského písma Pig od začátku do konce.
Co je Apache Pig?
Prase je na vysoké úrovni programovací jazyk užitečné pro analýzu velkých datových sad. Pig byl výsledkem vývojového úsilí společnosti Yahoo!
V frameworku MapReduce je třeba programy převést do série fází Map a Reduce. Nejedná se však o programovací model, se kterým jsou datoví analytici obeznámeni. Aby se tedy tato mezera překlenula, je nutný abs...tracProjekt s názvem Pig byl postaven na vrcholu Hadoop.
Apache Pig umožňuje lidem více se soustředit na analýzu hromadných datových sad a trávit méně času psaním programů MapReduce. Podobně jako prasata, která jedí cokoli, je programovací jazyk Apache Pig navržen tak, aby pracoval s jakýmkoli druhem dat. Proto název Pig! Maskot projektu níže vyjadřuje totéž.

Projekt je stále aktivní. Apache Pig 0.18.0 byla vydána 15. září 2025 a přidává podporu pro Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 a Python 3, podle Stránka s vydáním Apache PigNíže uvedený návod byl původně napsán pro mnohem starší verzi 0.12.1, takže několik kroků obsahuje poznámku, kde se aktuální verze chová odlišně.
Prase Architecture
Architektura Pig se skládá ze dvou komponent:
- prasečí latina, což je jazyk
- Runtime prostředí, pro provozování programů Pig Latin.
Program v Pig Latin se skládá ze série operací nebo transformací, které se aplikují na vstupní data za účelem vytvoření výstupu. Tyto operace popisují tok dat, který je spouštěcím prostředím Hadoop Pig přeložen do spustitelné reprezentace. Níže jsou uvedeny výsledky těchto transformací. MapReduce úkoly, kterých si programátor není vědom. Pig v Hadoopu tedy programátorovi v jistém smyslu umožňuje soustředit se na data spíše než na povahu provádění.
Pig Latin je poměrně rigidní jazyk, který používá známá klíčová slova ze zpracování dat, např. Join, Group a Filter. Diagram níže tracprochází skript z Grunt shellu přes parser, optimalizátor a kompilátor na cestě k spouštěcímu enginu.

Režimy provádění
Pig v Hadoopu má dva režimy spouštění a níže uvedený návod k instalaci používá oba:
- Lokální režim: V tomto režimu běží jazyk Hadoop Pig v jednom JVM a využívá lokální souborový systém. Tento režim je vhodný pouze pro analýzu malých datových sad pomocí Pig v Hadoopu.
- Režim MapReduce: V tomto režimu jsou dotazy napsané v Pig Latin přeloženy do úloh MapReduce a spouštěny na clusteru Hadoop (cluster může být pseudodistribuovaný nebo plně distribuovaný). Režim MapReduce s plně distribuovaným clusterem je užitečný pro spouštění Pig na velkých datových sadách.
Tyto dva představují klasickou dvojici. Aktuální verze ve skutečnosti zpřístupňují šest typů spuštění neboli exectypes, každý vybraný se stejným -x vlajka, jak je zdokumentováno v Průvodce Začínáme s Pig 0.18.0.
| Typ provedení | Příkaz | Kde práce probíhá |
|---|---|---|
| Místní | prase -x místní | Jeden JVM proti lokálnímu souborovému systému |
| Tez local | prase -x tez_local | Jeden JVM využívající běhové prostředí Tez (experimentální) |
| Spark místní | prase -x spark_local | Jeden JVM používající Spark běhové prostředí (experimentální) |
| MapReduce | prase nebo prase -x mapreduce | Cluster Hadoop s HDFS; toto je výchozí nastavení |
| Tez | prase -x tez | Cluster Hadoop s enginem Tez |
| Spark | prase -x jiskra | A Spark, YARN nebo Mesos cluster s HDFS |
Typy dat Pig Latin a Operatorů
Než začnete psát skript, je dobré vědět, co Pig dokáže uchovávat a co s tím může dělat. Datový model je plně vnořený, což umožňuje Pigu číst logovací soubory a další volně strukturované vstupy, které by relační tabulka odmítla.
Pig Latin nabízí dvě rodiny typů:
- Skalární typy:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerabigdecimalV následujícím příkladovém skriptu je každý sloupec deklarován jakochararray. - Složité typy: a n-tice je uspořádaná sada polí a chová se jako řádek; pytel je neuspořádaná kolekce n-tic a chová se jako tabulka; mapa je sada párů klíč a hodnota, jejichž klíč musí být
chararray.
Operátoři spadají do malého počtu pracovních míst a hrstka z nich provozuje téměř každý ropovod:
| OperaTor | Co to dělá |
|---|---|
| NABÍJENÍ / ULOŽENÍ | Načíst relaci ze souborového systému a zapsat výsledek zpět |
| FILTER | Zachovat pouze n-tice, které splňují podmínku |
| PROVÁDĚT … GENEROVAT | Pracujte sloupec po sloupci a budujte nová pole |
| SKUPINA / SPOLEČNÁ SKUPINA | Seskupení jedné relace nebo dvou či více relací pomocí klíče |
| REGISTRACE | Spojování relací pomocí vnitřního nebo vnějšího spojení |
| UNIE / ROZDĚLENÍ | Sloučení vztahů nebo rozdělení jednoho na několik |
| ŘAZENÍ PODLE / ROZDÍLNOSTI / LIMITU | Seřadit, odstranit duplicitní prvky a omezit počet n-tic |
| VYHOĎ / POPIŠ / VYSVĚTLI / ILUSTRATUJ | Kontrola výsledků, schémat, plánů provádění a ukázkových běhů |
Čtyři inspekční operátoři mají také zkratky Grunt, což šetří čas.ping během ladění: \d pro VYPLÁTKU, \de pro POPIS, \e pro VYSVĚTLENÍ a \i pro ILLUSTRATE.
Předpoklady
Pig je klientský nástroj. Analyzuje skript, plánuje práci a odesílá úlohy, ale neposkytuje vlastní úložiště ani cluster, takže nejprve musí existovat funkční instalace Hadoopu. Seznam požadavků na Apache je krátký.
| Složka | Požadavek | Proč je to potřeba |
|---|---|---|
| Hadoop | Hadoop 2.x nebo 3.x s exportovaným HADOOP_HOME | Dodává HDFS a spouštěcí engine. Bez HADOOP_HOME se Pig 0.18.0 vrací k vestavěnému Hadoopu 2.7.3. |
| Java | Java 1.7 nebo novější, s JAVA_HOME nastaveným na kořenový adresář instalace | Pig a démoni Hadoop jsou Java programy |
| Python (Volitelné) | Python 2.7 | Potřebné pouze pro streamování Python uživatelem definované funkce |
| Mravenec (volitelné) | Mravenec 1.8 | Potřebné pouze při sestavování nebo rekompilaci Pig ze zdrojového kódu |
Vedle tohoto seznamu jsou dva praktické body. Za prvé, spusťte vše jako uživatel Linuxu, který již má domovský adresář v HDFS a oprávnění k zápisu do něj; tento tutoriál používá hduser, účet vytvořený během instalace Hadoopu. Za druhé, spusťte cluster před spuštěním Pigu v režimu MapReduce, protože Pig okamžitě selže, pokud jsou NameNode a ResourceManager nefunkční. Pokud Hadoop ještě není nainstalován, postupujte podle jak nainstalovat Hadoop .
Jak stáhnout a nainstalovat Pig
Nyní v tomto tutoriálu Apache Pig se naučíme, jak stáhnout a nainstalovat Pig:
Než začneme s samotným procesem, ujistěte se, že máte nainstalovaný Hadoop. Změňte uživatele na „hduser“ (ID použité při konfiguraci Hadoopu; můžete přepnout na ID uživatele použité během vaší vlastní konfigurace Hadoopu).

Krok 1) Stáhněte si nejnovější stabilní verzi Pig Hadoop z libovolného zrcadlového serveru dostupného na adrese
https://pig.apache.org/releases.html
Vyberte soubor tar.gz (a nikoli src.tar.gz) ke stažení, jak je znázorněno níže.

Krok 2) Jakmile je stahování dokončeno, přejděte do adresáře obsahujícího stažený soubor tar a přesuňte jej na místo, kde chcete nastavit Pig Hadoop. V tomto případě se přesuneme do /usr/local.

Přejděte do adresáře, který bude obsahovat soubory Pig Hadoop.
cd /usr/local
ExtracObsah souboru tar je uveden níže.
sudo tar -xvf pig-0.12.1.tar.gz

Krok 3) Upravte soubor ~/.bashrc a přidejte proměnné prostředí související s Pig.
Otevřete soubor ~/.bashrc v libovolném textovém editoru a proveďte níže uvedené úpravy.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Krok 4) Nyní si tuto konfiguraci prostředí vyžádejte pomocí níže uvedeného příkazu.
. ~/.bashrc

Krok 5) Potřebujeme překompilovat Pig, aby podporoval Hadoop 2.2.0.
Zde jsou kroky, jak toho dosáhnout.
Přejděte do domovského adresáře Pig.
cd $PIG_HOME
Nainstalujte Anta.
sudo apt-get install ant

Poznámka: Stahování začne a bude trvat déle v závislosti na rychlosti vašeho internetového připojení.
Znovu kompilovat prase.
sudo ant clean jar-all -Dhadoopversion=23

Vezměte prosím na vědomí, že během tohoto procesu rekompilace se stáhne více komponent, takže systém by měl být připojen k internetu.
Také v případě, že se tento proces někde zasekne a na příkazovém řádku neuvidíte žádný pohyb po dobu delší než 20 minut, stiskněte Ctrl + C a spusťte stejný příkaz znovu.
V našem případě to trvá 20 minut.

Tento krok rekompilace patří do éry verze 0.12.1, kdy byly dodávané jar soubory sestaveny proti Hadoopu 1 a -Dhadoopversion=23 flag přepnul sestavení Ant na linii Hadoop 0.23 a 2.x. Apache Pig 0.18.0 dodává binární soubory, které již běží na Hadoopu 2.7 a vyšším, stejně jako na Hadoopu 3, takže v aktuální verzi můžete obvykle rozbalit tarball a přejít rovnou k níže uvedenému testu.
Krok 6) Otestujte instalaci Pig pomocí příkazu
pig -help

Příklad prasečího skriptu
Po nainstalování Pigu se ve zbytku tohoto tutoriálu o Apache Pigu spustí kompletní skript. Použijeme Pig Scripts k nalezení počtu prodaných produktů v jednotlivých zemích.
Vstup: Naše vstupní datová sada je soubor CSV, ProdejJan2009.csv.
Krok 1) Spusťte Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Krok 2) Pig in Big Data bere soubor z HDFS v režimu MapReduce a ukládá výsledky zpět do HDFS.
Zkopírujte soubor SalesJan2009.csv (uložený v lokálním souborovém systému v adresáři ~/input/SalesJan2009.csv) do domovského adresáře HDFS (Hadoop Distributed File System).
V tomto příkladu Apache Pig se soubor nachází ve složce input. Pokud je soubor uložen na jiném místě, zadejte místo toho tento název.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Ověřte, zda byl soubor skutečně zkopírován, či nikoli.
$HADOOP_HOME/bin/hdfs dfs -ls /

Krok 3) Konfigurace prasete.
Nejprve přejděte do adresáře $PIG_HOME/conf a uložte si kopii původního souboru s vlastnostmi.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Otevřete soubor pig.properties pomocí libovolného textového editoru a zadejte cestu k souboru protokolu pomocí pig.logfile.
sudo gedit pig.properties

Logger použije tento soubor k protokolování chyb.
Krok 4) Spusťte příkaz 'pig', který spustí příkazový řádek Pig, interaktivní shell pro dotazy Pig.
pig

Krok 5) V příkazovém řádku Grunt pro Pig spusťte níže uvedené příkazy Pig v uvedeném pořadí.
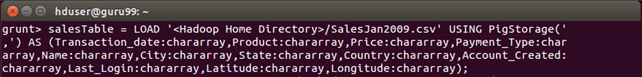
— A. Načtěte soubor obsahující data.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Po tomto příkazu stiskněte Enter.
— B. Seskupte data podle pole Země.
GroupByCountry = GROUP salesTable BY Country;

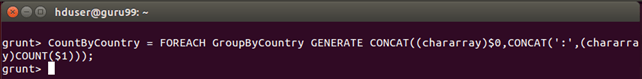
— C. Pro každou n-tici v „GroupByCountry“ vygenerujte výsledný řetězec ve tvaru Název země: Počet prodaných produktů.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Po tomto příkazu stiskněte Enter.
— D. Uložte výsledky datového toku do adresáře „pig_output_sales“ na HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Provedení tohoto příkazu bude nějakou dobu trvat. Po dokončení byste měli vidět následující obrazovku.

Krok 6) Výsledek lze vidět v příkazovém rozhraní jako
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Výsledky lze zobrazit i přes webové rozhraní.
Otevřete http://localhost:50070/ ve webovém prohlížeči.
Port 50070 je webové uživatelské rozhraní NameNode na Hadoopu 2. Hadoop 3 přesunul stejnou stránku na port 9870, takže pokud váš cluster běží na Hadoopu 3, použijte tuto adresu.

Nyní vyberte „Procházet souborový systém“ a přejděte do složky /user/hduser/pig_output_sales.

Otevřete soubor part-r-00000 a přečtěte si páry country a product-count, které skript vygeneroval.

Apache Pig vs. Hive vs. MapReduce
Prase je zřídka hodnoceno samostatně. Obvyklá otázka zní, zda daná práce patří do Prasete, Úl nebo v ručně psaném programu MapReduce, protože všechny tři skončí jako úlohy na stejném clusteru.
| Vzhled | MapReduce (Java) | Apačské prase | Úl Apache |
|---|---|---|---|
| Rozhraní | Java API | Pig Latin , skriptovací jazyk pro tok dat | HiveQL, dialekt SQL |
| Úroveň břišních svalůtracvání | Nízké | Střední | Vysoký |
| Typický uživatel | Java vývojka | Datový inženýr nebo výzkumník | Analytik se vyzná v SQL |
| Data, která se hodí | Cokoli, ručně ovladatelné | Strukturované a polostrukturované; schéma je volitelné při načítání | Strukturované tabulky registrované v metastore |
| Code objem | Většina linek | Méně řádků | Nejméně řádků pro dotaz |
| Běží jako | Úloha MapReduce | Kompiluje se do MapReduce, Tez nebo Spark pracovních míst | Kompiluje se do MapReduce, Tez nebo Spark pracovních míst |
| Nejlepší na | Plná kontrola a vlastní logika | Vícekrokové ETL kanály | Ad hoc dotazování a reportování |
V praxi je rozdělení přímočaré. Po Hive se použijí, když data již vypadají jako tabulka a otázka jako SQL. Po Pig se použijí, když je vstup chaotický, když je pipeline řetězcem transformací spíše než jediným dotazem, nebo když se stejný skript musí větvit a znovu spojovat. Po MapReduce se použijí pouze tehdy, když ani abstracce může vyjádřit logiku, protože počet řádků rychle roste.
Prase se také pohodlně usazuje vedle zbytku ekosystému. Sqoop a Flume přistát nezpracovaná data, Pig nebo Hive je upraví a plánovač, jako například Apache Oozie řetězí kroky do opakovatelného postupu. Širší představu o tom, kam tyto nástroje zapadají, naleznete v průvodci velké údajů a shrnutí nástroje pro velká data; komerční alternativu ETL k ručně psaným skriptům viz Talend.
