
Gaussian Kernel в машинното обучение: Python Методи на ядрото
 Евелин Кларк
⚡ Умно обобщение
Гаусовите методи на ядрото правят неразделимите данни линейно разделими, без изобщо да се изгражда карта на характеристиките с многомерност. Това ръководство показва картата на полиномите.ping ръчно, след което обучава произволен класификатор на ядрото на Фурие в TensorFlow.
Целта на този урок е да направи набор от данни линейно разделим. Урокът е разделен на две части:
- Трансформация на характеристиките
- Обучете класификатор на ядрото с TensorFlow
В първата част ще разберете идеята зад метода на ядрото в машинното обучение, докато във втората част ще видите как да обучите класификатор на ядрото с... TensorFlowЩе използвате набора от данни за възрастни. Целта на този набор от данни е да класифицира приходите под и над 50 000 долара, като знае поведението на всяко домакинство.
Защо се нуждаете от методи на ядрото?
Целта на всеки класификатор е да предскаже правилно класовете. За тази цел наборът от данни трябва да е разделим. Вижте графиката по-долу; сравнително лесно е да се види, че всички точки над черната линия принадлежат към първия клас, а останалите точки - към втория клас. Изключително рядко обаче има толкова прост набор от данни. В повечето случаи данните не са разделими, а данните, които не са разделими, затрудняват наивни класификатори като логистичната регресия.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

На фигурата по-долу е показан набор от данни, който не е линейно разделим. Ако начертаем права линия, повечето точки няма да бъдат класифицирани в правилния клас.
Един от начините за справяне с този проблем е да се вземе наборът от данни и да се трансформират данните в друга карта на характеристиките. Това означава, че ще използвате функция, за да преместите данните в друга равнина, която трябва да е линейно разделима.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
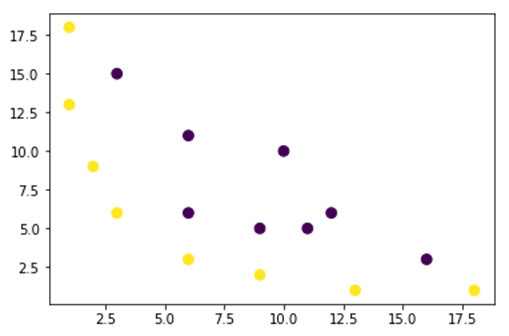
Данните от фигурата по-горе се намират в 2D равнина и не са разделими. Можете да опитате да трансформирате тези данни в три измерения, което означава, че създавате фигура с 3 оси.
В нашия пример с Гаусово ядро ще приложим полиномиално изображениеping да преведем данните си в трето измерение. Формулата за трансформиране на данните е следната.

Вие дефинирате функция в Gaussian Kernel Python за създаване на новите карти на характеристиките.
Можете да използвате numpy за кодиране на горната формула. Всеки ред по-долу сдвоява един член от картатаping с израза за масив, който го произвежда, а малкото изображение маркира корен квадратен от двумножител.
| Формула | Еквивалентен NumPy код |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
Новата картаping има 3 измерения и 16 точки.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Сега направете нова графика с 3 оси, съответно x, y и z.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Виждаме подобрение, но ако променим ориентацията на графиката, става ясно, че наборът от данни вече е разделим.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Ако трябва да манипулирате голям набор от данни и да създадете повече от 2 измерения, ще се сблъскате с голям проблем с горния метод. Всъщност, трябва да трансформирате всички точки от данни, което очевидно не е устойчиво. Ще ви отнеме много време и компютърът ви може да остане без памет.
Най-разпространеният начин за преодоляване на този проблем е използването на ядро.
Какво е ядро в машинното обучение?
Идеята е да се използва пространство от характеристики с по-високо измерение, за да се направят данните почти линейно разделими, както е показано на фигурата по-горе.
Има многобройни пространства с по-високи размери, които правят точките от данни разделими. Например, показахме, че полиномиалното изображениеping е страхотно начало.
Също така демонстрирахме, че при много данни тези трансформации не са ефективни. Вместо това можете да използвате функция на ядрото в машинното обучение, за да промените данните, без да се премествате в нова равнина на характеристиките.
Магията на ядрото е да намери функция, която избягва всички проблеми, произтичащи от изчисленията с многомерни числа. Резултатът от ядрото е скалар или, казано по друг начин, връщаме се към едномерното пространство.
След като сте намерили тази функция, можете да я включите в стандартния линеен класификатор.
Ето един пример, който прави концепцията за машинно обучение на ядрото конкретна. Имате два вектора, x1 и x2. Целта е да се създаде по-високо измерение, като се използва полиномиално изображение.pingРезултатът е равен на скаларното произведение на новата карта на характеристиките. От горния метод трябва да:
- Трансформирайте x1 и x2 в ново измерение
- Изчислете точковия продукт: общ за всички ядра
Трансформирайте x1 и x2 в ново измерение
Можете да използвате функцията, създадена по-горе, за да изчислите по-високото измерение.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
Продукция
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Изчислете точковия продукт
Можете да използвате точката на обекта от numpy да се изчисли скаларното произведение между първия и втория вектор, съхранени в x_1.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
Резултатът е 8100. Виждате проблема: трябва да съхраните нова карта на характеристиките в паметта, за да изчислите скаларното произведение. Ако имате набор от данни с милиони записи, това е изчислително неефективно.
Вместо това, можете да използвате ядрото на полинома, за да изчислите скаларното произведение, без да трансформирате вектора. Тази функция изчислява скаларното произведение на x1 и x2, сякаш тези два вектора са били трансформирани в по-високо измерение. С други думи, функцията на ядрото изчислява резултата от скаларното произведение от друго пространство от характеристики.
Можете да напишете полиномната ядрена функция в Python както следва.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
Това е степента на точковото произведение на два вектора. По-долу връщате втората степен на ядрото на полинома. Резултатът е равен на другия метод. Това е магията на ядрото.
polynomial_kernel(x1, x2, p=2)
8100
Видове методи на ядрото
Съществуват много различни техники за ядрото. Най-простата е линейното ядро. Тази функция работи доста добре за класификация на текст. Другите ядра са:
- Полиномиално ядро
- Гаусово ядро
Таблицата по-долу обобщава какво прави всеки от тях и кога практикуващите го използват.
| ядро | Какво изчислява | Типична употреба |
|---|---|---|
| Линеен | Просто скаларно произведение в оригиналното пространство на характеристиките | Вече разделими данни и високоразмерни текстови характеристики |
| полином | Скаловидно произведение, повдигнато до степен p, улавящо взаимодействията на характеристиките | Извити граници, когато е известно, че взаимодействията са от значение |
| Гаусова (RBF) | Прилика, базирана на разстояние, която спада към нула, когато точките се отдалечават една от друга | Обичайният първи избор, когато формата на границата е неизвестна |
В примера с TensorFlow ще използваме случайни Фурие характеристики. TensorFlow има вграден оценител за изчисляване на новото пространство от характеристики. Случайният Фурие картограф е апроксимация на Гаусовата функция на ядрото, показана по-долу.

Функцията за филтриране на Гаус изчислява сходството между точките от данни в пространство с много по-големи измерения.
След като теорията е установена, останалата част от това ръководство използва Гаусово ядро за работа върху реален набор от данни.
Обучете класификатора на Gaussian Kernel с TensorFlow
Целта на алгоритъма е да класифицира домакинството, което печели повече или по-малко от 50k.
Първо ще оцените логистична регресия, за да получите модел за сравнение. След това ще обучите класификатор на ядрото, за да видите дали можете да получите по-добри резултати.
Използвате следните променливи от набора от данни за възрастни:
- възраст
- работен клас
- fnlwgt
- образование
- образование_номер
- брачен
- окупация
- връзка
- раса
- секс
- капиталова_печалба
- капиталова_загуба
- часове_седмица
- родна_страна
- етикет
Ще процедирате както следва, преди да обучите и оцените модела:
- Импортирайте библиотеките
- Импортирайте данните
- Подгответе данните
- Конструирайте логистичния модел: базов модел
- Оценете модела
- Конструирайте и оценете класификатора на ядрото
Бележка към версията: Всеки фрагмент по-долу е насочен към TensorFlow 1.x. Именуването tf.contrib, което предоставя real_valued_column, RandomFourierFeatureMapper и KernelLinearClassifier, беше премахнато в TensorFlow 2.0, а самият tf.estimator беше премахнат в TensorFlow 2.16. В текущата версия, изградете същия конвейер със слоя tf.keras.layers.experimental.RandomFourierFeatures, последван от изходен слой Dense, или с двойката RBFSampler и SGDClassifier от scikit-learn.
Стъпка 1) Импортирайте библиотеките
За импортиране и обучение на модели на ядрото Изкуствен интелект, трябва да импортирате TensorFlow, панди и NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Стъпка 2) Импортирайте данните
Изтегляте данните от Страница с данни за възрастни на UCI и го импортирайте като pandas DataFrame.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
След като влакът и тестовият набор са дефинирани, можете да промените етикета на колоната от низ на цяло число. TensorFlow не приема низови стойности за етикета.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Стъпка 3) Подгответе данните
Наборът от данни съдържа както непрекъснати, така и категорични характеристики. Добра практика е да се стандартизират стойностите на непрекъснатите променливи. Можете да използвате функцията StandardScaler от scikit-научитеСъздавате и потребителски дефинирана функция, за да улесните преобразуването на набора от данни за обучение и тестване. Обърнете внимание, че свързвате непрекъснатите и категориалните променливи в общ набор от данни, а масивът трябва да е от тип float32.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
Функцията за трансформация е готова, така че можете да конвертирате набора от данни и да създадете функцията input_fn.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
В следващата стъпка ще тренирате логистична регресия. Това ще ви даде базова точност. Целта е да се победи базовата линия с различен алгоритъм, а именно класификатор на ядрото.
Стъпка 4) Конструирайте логистичния модел: Базов модел
Вие конструирате колоната с характеристики с обекта real_valued_column. Той ще гарантира, че всички променливи са плътни числови данни.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
Оценката се дефинира с помощта на TensorFlow Estimator API; вие предоставяте колоните на характеристиките и къде да се запази графиката.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Ще обучавате логистичната регресия, използвайки мини-партиди с размер 200.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
Можете да обучите модела с 1,000 итерации.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Стъпка 5) Оценете модела
Дефинирате входната функция на NumPy, за да оцените модела. Използвате целия набор от тестове за оценка.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Имате точност от 82 процента. В следващия раздел ще се опитате да победите логистичния класификатор с класификатор на ядрото.
Стъпка 6) Конструирайте класификатора на ядрото
Ядрената оценка не е толкова различна от традиционния линеен класификатор, поне по отношение на конструкцията. Идеята зад нея е да се комбинира силата на експлицитно ядрено картографиранеping с линейния класификатор.
Имате нужда от два предварително дефинирани оценителя, налични в TensorFlow, за да обучите класификатора на ядрото:
- RandomFourierFeatureMapper
- KernelLinearClassifier
В първия раздел научихте, че трябва да трансформирате ниското измерение във високо измерение, използвайки функция на ядрото. По-точно, ще използвате случайни характеристики на Фурие, които апроксимират Гаусовата функция. TensorFlow 1.x предоставя това изображение.ping като RandomFourierFeatureMapper, а моделът може да бъде обучен с помощта на оценителя KernelLinearClassifier.
За да изградите модела, ще следвате следните стъпки:
- Задайте високоразмерната функция на ядрото
- Задайте хиперпараметър L2
- Изградете модела
- Обучете модела
- Оценете модела
Стъпка A) Задайте функцията на ядрото с висока размерност
Текущият набор от данни съдържа 14 характеристики, които ще трансформирате в нов 5,000-мерен вектор. Използвате случайни характеристики на Фурие, за да постигнете трансформацията. Ако си спомняте формулата на Гаусово ядро, ще забележите, че има параметър за стандартно отклонение, който трябва да се дефинира. Този параметър контролира мярката за сходство, използвана по време на класификацията: малко stddev кара ядрото да третира само много близки точки като подобни, докато голямо изглажда границата на решението.
Можете да настроите всички параметри в RandomFourierFeatureMapper с:
- input_dim = 14
- output_dim = 5000
- stddev = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
Трябва да конструирате картографа на ядрото, като използвате колоните с функции, създадени преди: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Стъпка Б) Задайте хиперпараметъра L2
За да предотвратите пренареждане, наказвате функцията на загуба с регуларизатора L2. Задавате хиперпараметъра L2 на 0.1, а скоростта на обучение на 5.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Стъпка В) Изграждане на модела
Следващата стъпка е подобна на линейната класификация. Използвате вградения оценител KernelLinearClassifier. Обърнете внимание, че добавяте дефинирания по-рано картограф на ядрото и променяте директорията на модела.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Предупрежденията за отхвърляне по-долу са очаквани в TensorFlow 1.x, тъй като модулът kernel_methods е изграден върху по-старите оценки tf.contrib.learn.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Стъпка Г) Обучение на модела
След като класификаторът на ядрото е изграден, сте готови да го обучите. Избирате да итерирате модела 2,000 пъти.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Стъпка Д) Оценка на модела
Не на последно място, вие оценявате ефективността на вашия модел. Трябва да можете да победите логистичната регресия.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
Крайната точност е 84%, което е с около 1.6 процентни пункта над базовата линия на логистичната регресия (0.83975184 спрямо 0.82353663). Има компромис между подобряването на точността и изчислителните разходи. Трябва да помислите дали това подобрение си струва времето, изразходвано от по-тежкия класификатор, и дали има убедително въздействие върху вашия бизнес.
