
Урок за Scikit-Learn: Как да инсталирате & примери за Scikit-Learn
 Евелин Кларк
⚡ Умно обобщение
Scikit-learn е платформа с отворен код Python Библиотека, която обхваща предварителна обработка, класификация, регресия, клъстеризация и избор на модел, разположен зад един последователен интерфейс за оценка, който поддържа целия работен процес на машинно обучение кратък, четим и възпроизводим от сурови данни до оценени прогнози.
Какво е Scikit-learn?
Научете се е с отворен код Python библиотека за машинно обучениеТой поддържа утвърдени алгоритми като KNN, градиентно усилване, случайна гора и SVM и е изграден върху... numpy и SciPy. Scikit-learn се използва широко в състезанията на Kaggle, както и във водещи технологични компании. Той обхваща предварителна обработка, намаляване на размерността, класификация, регресия, клъстеризация и избор на модел.
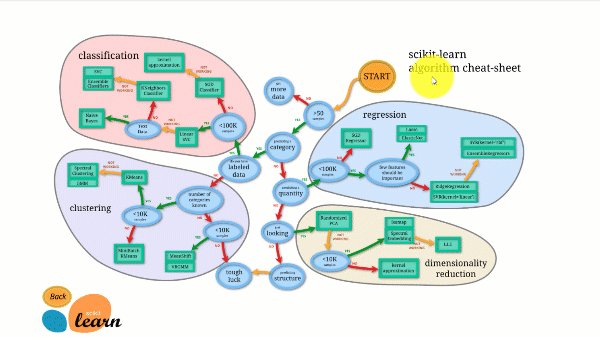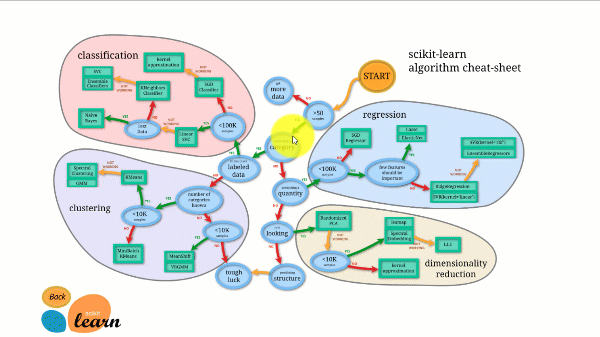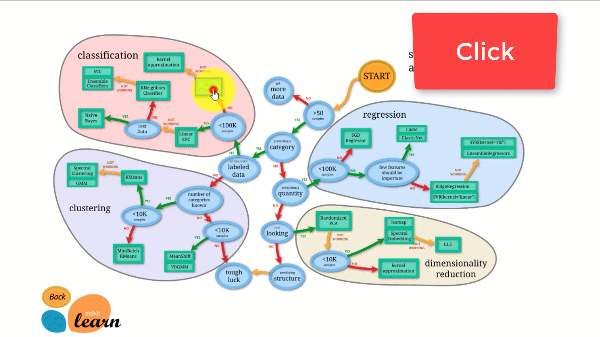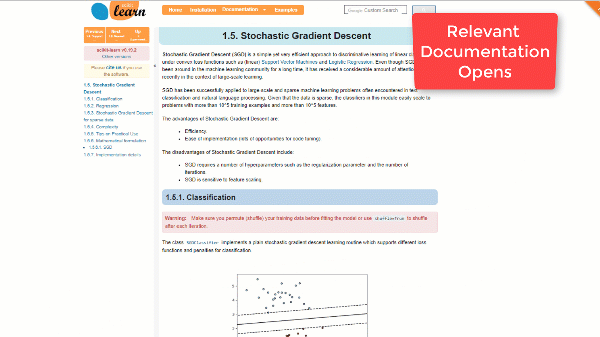
Scikit-learn има една от най-добрите документации сред библиотеките с отворен код. Тя дори предоставя интерактивна диаграма за оценка, Избор на правилния оценител, което ви превежда от размера на вашия набор от данни до кратък списък с алгоритми, които си струва да изпробвате.
Фигурата по-долу илюстрира как работи Scikit-learn.
Scikit-learn не е труден за използване и дава отлични резултати. Той обаче се обучава на процесора: работата се паралелизира между ядра с аргумента n_jobs, а не на графичен процесор. Изпълнението на алгоритъм за дълбоко обучение с него е възможно, но рядко е оптимално, особено ако вече знаете как да го използвате. TensorFlow.
Как да изтеглите и инсталирате Scikit-learn
Сега в това Python Урок за Scikit-learn, ще научите как да изтеглите и инсталирате Scikit-learn:
Вариант 1: AWS
Scikit-learn може да се използва върху AWS. Docker образ с предварително инсталиран scikit-learn спестява изцяло работата по настройката.
За да инсталирате версията за разработчици, изпълнете командата по-долу вътре Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
Вариант 2: Mac или Windows с помощта на Anaconda
За да научите повече за инсталирането на Anaconda, вижте как да изтеглите и инсталирате TensorFlow.
По времето, когато това ръководство беше написано, разработчиците на scikit бяха пуснали версия за разработка, която отстрани проблемите, присъстващи в текущата версия, така че стъпките по-долу използват тази разработческа версия. На нова машина днес текущата стабилна версия вече съдържа всеки трансформатор, използван тук, и pip инсталиране -U scikit-learn е достатъчно.
Как да инсталирате scikit-learn с Conda Environment
Ако сте инсталирали scikit-learn със средата conda, следвайте стъпките по-долу, за да актуализирате до версия 0.20.
Стъпка 1) Активирайте средата tensorflow
source activate hello-tf
Стъпка 2) Премахнете scikit-learn с помощта на командата conda
conda remove scikit-learn
Стъпка 3) Инсталирайте версията за разработчици
Инсталирайте версията за разработчици scikit-learn заедно с необходимите библиотеки.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
ЗАБЕЛЕЖКА: Windows потребителите се нуждаят Microsoft зрителен C++ 14. Можеш да го получиш тук.
Пример за Scikit-Learn с машинно обучение
Този урок за Scikit е разделен на две части:
- Машинно обучение с scikit-learn
- Как да се доверите на вашия модел с LIME
Първата част описва подробно как да се изгради конвейер, да се създаде модел и да се настроят хиперпараметрите, докато втората част обхваща интерпретацията на модела.
Стъпка 1) Импортирайте данните
По време на този урок за Scikit learn ще използвате набора от данни за преброяване на възрастни.
Файлът се чете директно от хранилището за машинно обучение на UCI в кода по-долу, така че не е необходимо ръчно изтегляне. Ако се интересувате от описателната статистика, инструментите Dive и Overview си струва да разгледате. Вижте този урок за да научите повече за гмуркането и общия преглед.
Импортирате набора от данни с pandas. Обърнете внимание, че трябва да конвертирате непрекъснатите променливи във формат с плаваща запетая.
Този набор от данни включва осем категорични променливи, изброени в CATE_FEATURES:
- работен клас
- образование
- брачен
- окупация
- връзка
- раса
- секс
- родна_страна
Включва и шест непрекъснати променливи, изброени в CONTI_FEATURES:
- възраст
- fnlwgt
- образование_номер
- капиталова_печалба
- капиталова_загуба
- часове_седмица
Списъците се попълват ръчно, за да имате по-ясна представа кои колони са в действие. По-бърз начин за изграждане на списък с категорични или непрекъснати колони е:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Ето кода за импортиране на данните:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
Извикването на describe() върху рамката връща обобщената статистика за шестте непрекъснати колони:
| възраст | fnlwgt | образование_номер | капиталова_печалба | капиталова_загуба | часове_седмица | |
|---|---|---|---|---|---|---|
| броя | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| означава | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| станд | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| мин | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| макс | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Можете да проверите броя на уникалните стойности на характеристиката native_country. Само едно домакинство е от Холандия. Това домакинство не носи никаква информация и ще генерира грешка по време на обучението.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
Можете да изключите този неинформативен ред от набора от данни:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
След това съхранявате позицията на непрекъснатите характеристики в списък. Ще ви трябва в следващата стъпка за изграждане на тръбопровода.
Кодът по-долу преминава през всички имена на колони в CONTI_FEATURES, чете всяко местоположение (тоест, номера на колоната му) и го добавя към списък, наречен conti_features.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
Следващият блок върши същата работа за категориалните променливи.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Сега разгледайте самия набор от данни. Всяка категориална характеристика е низ, а на модел не може да се подаде низова стойност, така че наборът от данни трябва да бъде трансформиран с фиктивни променливи.
df_train.head(5)
Всъщност, ви е необходима по една колона за всяка група във всяка функция. Първо, изпълнете кода по-долу, за да изчислите общия брой необходими колони.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
Целият набор от данни съдържа 101 групи, както е показано по-горе. Само характеристиката workclass има девет групи. Можете да изброите имената на групите с кода по-долу; unique() връща различните стойности на всяка категорична характеристика.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
Следователно, наборът от данни за обучение ще съдържа 101 + 6 колони: групите с един активен елемент плюс шестте непрекъснати характеристики.
Scikit-learn може да се погрижи за преобразуването в две стъпки:
- Преобразувайте низа в ID. State-gov става ID 1, Self-emp-not-inc става ID 2 и така нататък. LabelEncoder прави това вместо вас.
- Транспонирайте всеки идентификатор в нова колона. Наборът от данни има 101 групови идентификатора, така че ще има 101 колони, обхващащи всяка категорична група характеристики. Scikit-learn предоставя OneHotEncoder за тази операция.
Стъпка 2) Създайте комплекта за обучение/тест
След като наборът от данни е готов, разделете го на 80/20: 80 процента за обучителния набор и 20 процента за тестовия набор.
Можете да използвате train_test_split. Първият аргумент е рамката от данни на характеристиките, а вторият е етикетът. Задавате размера на тестовия набор с test_size.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
Стъпка 3) Изградете тръбопровода
Конвейерът улеснява захранването на модела с последователни данни. Идеята е суровите данни да се прехвърлят през един обект, който изпълнява всяка операция по ред.
С този набор от данни трябва да стандартизирате непрекъснатите променливи и да конвертирате категориалните. Всяка операция може да се извършва в рамките на конвейер: липсващите стойности могат да бъдат заменени със средна стойност или медиана и могат да бъдат създадени нови променливи.
Имате избор: да кодирате твърдо двата процеса или да изградите конвейер. Твърдото кодиране може да доведе до изтичане на тестови данни в съобразените статистики и да създаде несъответствия с течение на времето, така че конвейерът е по-добрият вариант.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
Тръбопроводът извършва две операции, преди да захранва логистичния класификатор:
- Стандартизирайте променливата: StandardScaler()
- Преобразувайте категоричните характеристики: OneHotEncoder(sparse=False)
Изпълнявате и двете стъпки с make_column_transformer. Когато това ръководство е написано, функцията не е била в издадената версия на scikit-learn (0.19), поради което е използвана разработческата версия; тя е била включена във всяка стабилна версия от 0.20 насам.
make_column_transformer е лесно: декларирате кои колони да трансформирате и коя трансформация да приложите. За да стандартизирате непрекъснатите функции, които предавате:
- conti_features, StandardScaler() вътре в make_column_transformer
- conti_features: списъкът с непрекъснати колони
- StandardScaler: стандартизира тези колони
Обектът OneHotEncoder вътре в make_column_transformer кодира етикетите автоматично.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Бележка към версията: Два аргумента в горния блок са преместени напред. Текущите версии очакват първо трансформатора, а след това колоните, и рядък бе преименуван рядък_изход в scikit-learn 1.2 и премахнато в 1.4, така че по-нов код чете OneHotEncoder(sparse_output=False).
Можете да проверите дали конвейерът работи с fit_transform. Изходът трябва да има формата 26048, 107.
preprocess.fit_transform(X_train).shape
(26048, 107)
Трансформаторът на данни е готов. Създавате конвейера с make_pipeline и след като данните са трансформирани, ги подавате към логистичната регресия.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Обучението на модел със scikit-learn е тривиално: извикайте fit в конвейера. Можете да отпечатате точността с метода score.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Накрая можете да предскажете класовете с predict_proba, която връща вероятността за всеки клас. Обърнете внимание, че двете вероятности се сумират до едно.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
Стъпка 4) Използване на нашия конвейер при търсене в мрежа
Настройването на хиперпараметрите, стойностите, които фиксират структурата на модела, може да бъде досадно и изтощително.
Един от начините за оценка на модела би бил да се промени размерът на обучаващия набор и да се измери производителността, като се повтори упражнението десет пъти, за да се види разпределението на резултата. Това е много ръчна работа.
Вместо това, scikit-learn предоставя функции, които извършват настройка на параметри и кръстосана валидация вместо вас.
Кръстосана проверка
Кръстосаната валидация означава, че по време на обучението обучаващият набор се разделя n пъти на групи и моделът се оценява n пъти. Ако cv е зададено на 10, моделът се обучава и оценява десет пъти. Във всеки кръг класификаторът обучава девет групи, избрани на случаен принцип, а десетата група се запазва за оценка.
Търсене в мрежата
Всеки класификатор има хиперпараметри за настройване. Можете да изпробвате стойности една по една или да зададете мрежа от параметри. Документацията на scikit-learn изброява всички параметри, които логистичният класификатор приема. За да се ускори обучението, този пример настройва само параметъра C, който контролира регуляризацията. Той трябва да е положителен, а малка стойност дава по-голяма тежест на регуларизатора.
Използвате обекта GridSearchCV, който приема речник на хиперпараметрите за настройване. Избройте всеки хиперпараметър, последван от стойностите, които искате да опитате. За да настроите C, пишете:
- 'logisticeregression__C': [0.001, 0.01, 0.1, 1.0] — името на параметъра е предшествано от името на класификатора с малки букви и две долни черти.
Моделът ще опита четири различни стойности: 0.001, 0.01, 0.1 и 1. Той е обучен с 10 пъти, което е cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Вече можете да обучите модела, използвайки GridSearchCV с параметъра grid и cv.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
Изход:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Бележка към версията: - идентификатор на друг идентификатор Аргументът , видим в този изход, беше остарял в scikit-learn 0.22 и премахнат в 0.24, така че просто трябва да бъде премахнат от извикването на GridSearchCV в текущите версии.
За достъп до най-добрите параметри използвате best_params_.
grid_clf.best_params_
Изход:
{'logisticregression__C': 1.0}
След обучение на модела с четири различни стойности на регуляризация, оптималният параметър дава:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
най-добра логистична регресия от търсене в мрежата: 0.850891
За достъп до прогнозираните вероятности:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
Модел XGBoost с scikit-learn
Сега опитайте един от най-силните класификатори на пазара. XGBoost е подобрение на случайната гора, което увеличава градиента. Теоретичната му основа е извън обхвата на това изследване. Python Урок за Scikit, но имайте предвид, че XGBoost е печелил много състезания на Kaggle. Върху набор от данни със среден размер може да се представи толкова добре, колкото алгоритъм за дълбоко обучение, или дори по-добре.
Класификаторът е труден за обучение, защото предоставя голям брой параметри. Разбира се, можете да използвате GridSearchCV, за да ги изберете вместо вас.
По-добър вариант тук е RandomizedSearchCV. GridSearchCV става бавен, когато мрежата е голяма, защото пространството за търсене нараства с всеки добавен параметър. RandomizedSearchCV вместо това взема проби от стойностите на всеки хиперпараметър на случаен принцип при всяка итерация, така че 1,000 итерации оценяват 1,000 комбинации. Иначе работи подобно на GridSearchCV.
Трябва да импортирате xgboost. Ако библиотеката не е инсталирана, изпълнете pip3 install xgboost или я инсталирайте отвътре Jupyter тефтер с:
use import sys
!{sys.executable} -m pip install xgboost
След това импортирайте класификатора и двата помощника за търсене:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
Следващата стъпка в този Scikit Python Урокът е да се зададат параметрите за настройване. Официалната документация на XGBoost ги изброява всички. За целите на това Python В урока на Sklearn избирате само два хиперпараметъра с по две стойности всеки, защото XGBoost отнема много време за обучение и всяка допълнителна точка от мрежата добавя към чакането.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
След това изграждате нов конвейер с класификатора XGBoost и 600 оценки. n_estimators сам по себе си е настройваем и високата стойност може да доведе до пренастройване. Можете да опитате други стойности, но имайте предвид, че това може да отнеме часове. Всеки друг параметър запазва стойността си по подразбиране.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
Можете да подобрите кръстосаната валидация с помощта на Stratified K-Folds cross-validator. Тук се използват само три сгъвания, за да се ускори изчислението, но с известна загуба на качество; увеличете това до 5 или 10 на вашата машина за по-добри резултати. Моделът се обучава в рамките на четири итерации.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
Рандомизираното търсене е готово, така че можете да обучите модела.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Както можете да видите, XGBoost се представя по-добре от по-ранната логистична регресия.
print("Best parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
Best parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Създайте DNN с MLPClassifier в scikit-learn
Накрая, можете да обучите невронна мрежа със самия scikit-learn. Методът е същият като за всеки друг класификатор, а оценката е MLPClassifier.
from sklearn.neural_network import MLPClassifier
Мрежата по-долу е дефинирана с:
- Решател на Адам
- Функция за активиране на ReLU
- Алфа = 0.0001
- Размер на партидата от 150
- Два скрити слоя съответно със 200 и 100 неврона
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
Можете да промените броя на слоевете, за да подобрите модела.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
DNN регресионен резултат: 0.821253
LIME: Доверете се на своя модел
След като вече имате добър модел, ви е нужен начин да му се доверите. Алгоритмите за машинно обучение, особено случайните гори и невронните мрежи, са известни като модели на черна кутия: те работят, но никой не може да разбере защо.
Трима изследователи са създали инструмент, който показва как компютърът достига до прогноза. Тяхната статия е... „Защо да ти вярвам?“, а публикуваният от тях алгоритъм се нарича Локално интерпретируеми моделно-агностични обяснения (LIME).
Вземете пример. Понякога не знаете дали може да се вярва на прогноза, получена от машинно обучение. Лекарят не може да приеме диагноза само защото е била поставена от компютър, и е необходимо да знаете дали даден модел е надежден, преди да го пуснете в производство.
Представете си, че можете да разберете защо който и да е класификатор е направил дадено предсказание, дори за модели, толкова сложни като невронни мрежи, случайни гори или SVM с произволно ядро. Става много по-лесно да се доверите на предсказание, когато причините за него са видими, и също толкова по-лесно е да решите кога на даден модел не трябва да се има доверие. LIME ви казва кои характеристики са довели до решението на класификатора.
Подготовка на данните
Има няколко неща, които трябва да промените, за да стартирате LIME с PythonПърво, инсталирайте lime в терминала с командата pip install lime.
Lime използва обект LimeTabularExplainer, за да апроксимира модела локално. Този обект изисква:
- набор от данни в numpy формат
- Името на функциите: имена_на_функции
- Името на класовете: class_names
- Индексът на колоната на категорийните признаци: категорични_характеристики
- Името на групата за всяка категорична характеристика: categorical_names
Създайте влаковия комплект NumPy
Можете да копирате и конвертирате df_train от pandas в NumPy много лесно.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Вземете името на класа
Етикетът е достъпен чрез unique(). Трябва да видите:
- „<=50K“
- '>50K'
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
Индексиране на колоните с категорични характеристики
Използвайте метода, който научихте по-рано, за да получите името на всяка група. Кодирате етикета с LabelEncoder и повтаряте операцията за всяка категорична характеристика.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
След като наборът от данни е готов, можете да изградите различните набори от данни, показани в примерите за обучение на Scikit по-долу. Данните се трансформират извън конвейера тук, за да се избегнат грешки с LIME: наборът за обучение, предаден на LimeTabularExplainer, трябва да бъде масив NumPy без низове, а методът по-горе вече е създал такъв.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
Можете да направите тръбопровода с оптималните параметри, намерени от XGBoost.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Получавате предупреждение. То обяснява, че не е необходимо да създавате енкодер за етикети преди конвейера. Ако не използвате LIME, методът от първата част на този урок за машинно обучение със Scikit-learn е подходящ. В противен случай, запазете този подход: първо създайте кодиран набор от данни, след което приложете енкодера one-hot вътре в конвейера.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Преди да пуснете LIME в действие, създайте масив в NumPy, съдържащ характеристиките на неправилно класифицираните редове. Можете да използвате този списък по-късно, за да добиете представа какво е подвело класификатора.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
След това създавате ламбда функция, която извлича прогнозата от модела за нови данни. Ще ви е необходима скоро.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
Конвертирате рамката от данни на pandas в масив NumPy.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Сега изберете произволно домакинство от тестовия набор и вижте както прогнозата, така и как компютърът е стигнал до нея.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
Можете да използвате обяснителя с explain_instance, за да проверите обосновката на модела. Диаграмата, която той рендира, е показана по-долу.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Класификаторът е предвидил правилно дохода на това домакинство: доходът наистина е над 50 000.
Първото нещо, което трябва да се отбележи, е, че класификаторът не е много сигурен в себе си. Той прогнозира доход над 50 000 с вероятност от 64%, като 64% се определят от капиталова печалба и семейно положение. Синият цвят допринася отрицателно за положителния клас, а оранжевата линия - положително.
Класификаторът е колеблив, защото капиталовата печалба на това домакинство е нула, докато капиталовата печалба обикновено е добър показател за богатство. Домакинствата също така работят по-малко от 40 часа седмично. Възрастта, професията и полът имат положителен принос.
Ако семейното положение беше неженен/неомъжена, класификаторът би предвидил доход под 50 000 (0.64 – 0.18 = 0.46).
Сега опитайте с друго домакинство, което е класифицирано погрешно. Таблицата с обяснения за него следва кода.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Класификаторът е предвидил доход под 50 000, което е грешно. Това домакинство е необичайно: то няма нито капиталова печалба, нито капиталова загуба, лицето е разведено, на близо 60 години и образовано, т.е. education_num > 12. Следвайки общата закономерност, класификаторът е поставил домакинството под 50 000.
Поиграйте си с LIME и ще забележите множество груби грешки в класификатора. GitHub хранилището на автора на библиотеката съдържа допълнителна документация за класификация на изображения и текст.
Справочник на командите Scikit-learn
По-долу е даден списък с полезни команди, които се отнасят за scikit-learn версия 0.20 и по-нова.
| Task | Функция или клас |
|---|---|
| Създаване на набор от данни за обучение/тест | train_test_split |
| Изградете тръбопровод | |
| Изберете колоните и приложете трансформацията | създаване_на_колона_трансформатор |
| Вид трансформация | |
| Стандартизирайте | StandardScaler |
| Мащабиране от мин. до макс. | MinMaxScaler |
| Нормализиране | Нормализатор |
| Вмъкване на липсващи стойности | SimpleImputer |
| Преобразувайте категорично | OneHotEncoder |
| Нагласете и трансформирайте данните | fit_transform |
| Направи тръбопровода | make_pipeline |
| Основен модел | |
| Логистична регресия | Логистична регресия |
| XGBoost | XGB Класификатор |
| Невронна мрежа | MLPClassifier |
| Търсене в мрежата | GridSearchCV |
| Случайно търсене | RandomizedSearchCV |
