
Пример за Hadoop MapReduce: Първи Java Програма с Code
 Прафула Ранадив
⚡ Умно обобщение
Програмите Hadoop MapReduce са написани като три Java класове, мапър, редуктор и драйвер, които се компилират, пакетират в JAR файл и се изпращат към клъстера за преброяване на продажбите по държави.
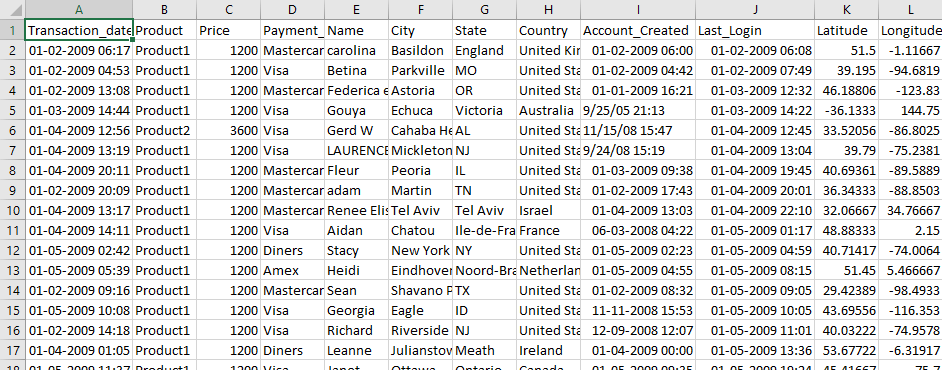
В този урок ще се научите да използвате Hadoop с примери за MapReduce. Използваните входни данни са SalesJan2009.csvСъдържа информация, свързана с продажбите, като име на продукта, цена, начин на плащане, град и държава на клиента. Целта е да се установи броят на продадените продукти във всяка държава.
Първата програма Hadoop MapReduce
Сега в това Урок за MapReduce, ние ще създадем нашия първи Java Програма MapReduce:
Екранната снимка по-долу показва суровите данни за SalesJan2009, където всеки ред е една транзакция, а държавата се намира в осмата колона, разделена със запетаи.
Уверете се, че имате инсталиран Hadoop. Преди да започнете самия процес, променете потребителя на „hduser“ (идентификаторът, използван при конфигурирането на Hadoop — можете да превключите към потребителския идентификатор, използван по време на вашата собствена конфигурация на Hadoop).
su - hduser_
Подканата се променя към акаунта hduser, както е показано по-долу.

Стъпка 1) Създайте директорията на проекта и изходните файлове
Създайте нова директория с име MapReduceTutorial, както е показано в примера MapReduce по-долу.
sudo mkdir MapReduceTutorial

Дайте разрешения
sudo chmod -R 777 MapReduceTutorial

Създайте трите Java изходните файлове по-долу в MapReduceTutorial. Обърнете внимание, че и трите използват по-стария org.apache.hadoop.mapred API, който все още се доставя с Hadoop 3.x.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
Архивът се разширява в същите три изходни файла, както е показано тук.
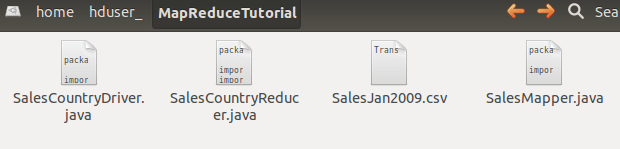
Проверете файловите разрешения на всички тези файлове

Ако липсват разрешения за „четене“, предоставете ги:

Стъпка 2) Експортиране на пътя към класовете на Hadoop
Експортирайте пътя към класа, както е показано в примера на Hadoop по-долу.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Експортираният път към класа се връща обратно в подканата.

Стъпка 3) Компилирайте Java файлове
Компилирайте Java файлове (тези файлове се намират в директорията Final-MapReduceHandsOn). Техните файлове с класове ще бъдат поставени в директорията на пакета.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
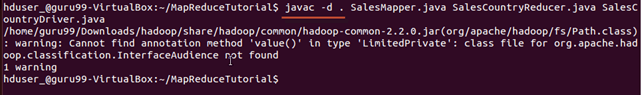
Това предупреждение може да бъде игнорирано безопасно — то само съобщава, че mapred API е остарял.
Тази компилация ще създаде директория в текущата директория, наречена с името на пакета, посочено в Java изходния файл (т.е. SalesCountry в нашия случай) и поставяме всички компилирани файлове с класове в него.

Стъпка 4) Създайте файла на манифеста
Създайте нов файл Manifest.txt
sudo gedit Manifest.txt
Добавете следния ред към него:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver е името на основния клас. Моля, обърнете внимание, че трябва да натиснете клавиша Enter в края на този ред.
Стъпка 5) Опаковайте класовете в буркан
Създайте Jar файл
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Проверете дали jar файлът е създаден

Стъпка 6) Стартирайте Hadoop
Стартирайте Hadoop
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Стъпка 7) Копирайте входния файл в HDFS
Копирайте файла SalesJan2009.csv в ~/inputMapReduce
Сега използвайте командата по-долу, за да копирате ~/inputMapReduce в HDFS.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
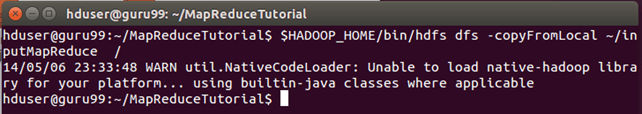
Спокойно можем да пренебрегнем това предупреждение.
Проверете дали файлът наистина е копиран или не.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Стъпка 8) Изпълнете задачата MapReduce
Изпълнете задание MapReduce
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Това ще създаде изходна директория с име mapreduce_output_sales HDFS. Съдържанието на тази директория ще бъде файл, съдържащ продажбите на продукти по държави.
Стъпка 9) Прочетете резултатите
Резултатът може да се види чрез командния интерфейс като,
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
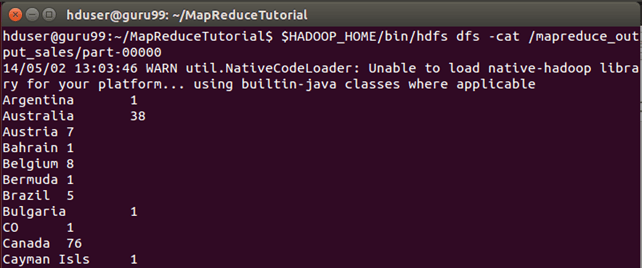
Резултатите могат да се видят и чрез уеб интерфейс като-
отворено http://localhost:50070/ в уеб браузър. В Hadoop 3.x уеб интерфейсът на NameNode се премести в порт 9870, така че използвайте http://localhost:9870/ там вместо това.

Сега изберете „Преглед на файловата система“ и отидете до /mapreduce_output_sales

Отворена част-r-00000

Обяснение на клас SalesMapper
След като задачата се изпълнява от край до край, следващите три раздела разглеждат какво всъщност прави всеки клас.
В този раздел ще разберем имплементацията на класа SalesMapper.
1. Започваме, като задаваме име на пакет за нашия клас. SalesCountry е името на нашия пакет. Моля, обърнете внимание, че резултатът от компилацията, SalesMapper.class, ще бъде записан в директория, наречена с това име на пакет: SalesCountry.
След това импортираме библиотечни пакети.
По-долу е показана имплементация на класа SalesMapper -

Проба Code Обяснение:
1. Дефиниция на клас SalesMapper-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Всеки клас на мапър трябва да бъде разширен от класа MapReduceBase и трябва да имплементира интерфейса на Mapper.
2. Дефиниране на функцията "карта"-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
Основната част на класа Mapper е методът 'map()', който приема четири аргумента.
При всяко извикване на метода 'map()' се предава двойка ключ-стойност („ключ“ и „стойност“ в този код).
Методът 'map()' започва с разделяне на входния текст, който се получава като аргумент. Той разделя всеки ред на полета.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Тук „,“ се използва като разделител.
След това се формира двойка, използвайки запис на 7-ми индекс на масива „SingleCountryData“ и стойност „1“.
output.collect(new Text(SingleCountryData[7]), one);
Избираме запис на 7-ми индекс, защото ни трябват данни за държавата и той се намира на 7-ми индекс в масива „SingleCountryData“.
Моля, обърнете внимание, че нашите входни данни са във формата по-долу (където държавата е на 7-ми индекс, с 0 като начален индекс) -
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
Изходът на mapper отново е двойка ключ-стойност, която се генерира с помощта на метода 'collect()' на 'OutputCollector'.
Обяснение на клас SalesCountryReducer
В този раздел ще разберем имплементацията на класа SalesCountryReducer.
1. Започваме, като задаваме име на пакета за нашия клас. SalesCountry е името на нашия пакет. Моля, обърнете внимание, че резултатът от компилацията, SalesCountryReducer.class, ще бъде прехвърлен в директория, наречена с това име на пакет: SalesCountry.
След това импортираме библиотечни пакети.
По-долу е показана имплементация на класа SalesCountryReducer -
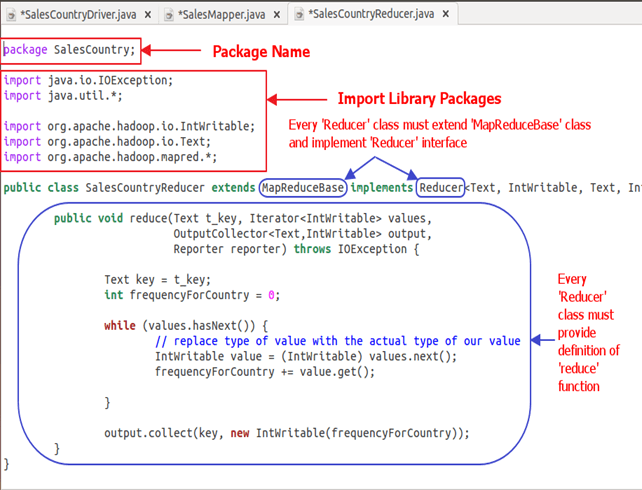
Code Обяснение:
1. Дефиниция на клас SalesCountryReducer-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Тук първите два типа данни, „Text“ и „IntWritable“, са типът данни на входната ключ-стойност към редуктора.
Изходът на маппера е във формата , Този изход на мапъра става вход за редуктора. Така че, за да се подравни с неговия тип данни, тук като тип данни се използват Text и IntWritable.
Последните два типа данни, „Text“ и „IntWritable“, са типовете данни на изхода, генериран от редуктора под формата на двойка ключ-стойност.
Всеки клас редуктор трябва да бъде разширен от класа MapReduceBase и трябва да имплементира интерфейса на Reducer.
2. Дефиниране на функцията „намаляване“-
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
Входът към метода reduce() е ключ със списък от множество стойности.
Например, в нашия случай ще бъде-
, , , , , .
Това се дава на редуктора като
Така че, за да се приемат аргументи от този вид, се използват първите два типа данни, а именно текст и итератор. Текстът е тип данни за ключ и итератор. е тип данни за списък със стойности за този ключ.
Следващият аргумент е от тип OutputCollector който събира изхода на редукторната фаза.
Методът reduce() започва с копиране на стойността на ключа и инициализиране на frequency count на 0.
Text key = t_key;int frequencyForCountry = 0;
След това, използвайки цикъла „while“, итерираме през списъка със стойности, свързани с ключа, и изчисляваме крайната честота, като сумираме всички стойности.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Сега, изпращаме резултата към изходния колектор под формата на ключ и полученото броене на честоти.
Кодът по-долу прави това-
output.collect(key, new IntWritable(frequencyForCountry));
Обяснение на клас SalesCountryDriver
В този раздел ще разберем имплементацията на класа SalesCountryDriver.
1. Започваме, като задаваме име на пакет за нашия клас. SalesCountry е името на нашия пакет. Моля, обърнете внимание, че резултатът от компилацията, SalesCountryDriver.class, ще бъде записан в директория, наречена с това име на пакет: SalesCountry.
Ето ред, указващ име на пакет, последван от код за импортиране на библиотечни пакети.

2. Дефинирайте клас драйвер, който ще създаде нова клиентска работа, конфигурационен обект и ще рекламира класове Mapper и Reducer.
Класът на драйвера е отговорен за настройването на нашата задача MapReduce да се изпълнява HadoopВ този клас ние определяме име на задачата, тип данни за вход/изход и имена на класове мапър и редуктор.

3. В кодовия фрагмент по-долу задаваме входни и изходни директории, които се използват съответно за използване на набор от входни данни и генериране на изход.
arg[0] и arg[1] са аргументите от командния ред, подадени с команда, зададена в MapReduce hands-on, т.е.
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
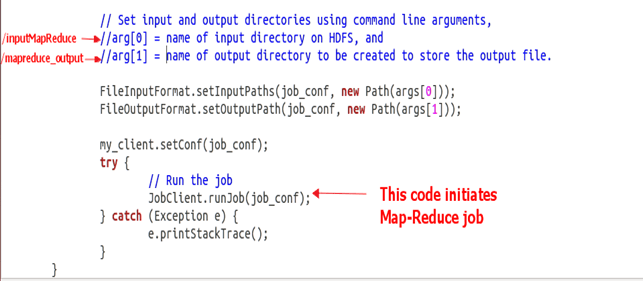
4. Задействайте нашата работа
Кодът по-долу стартира изпълнението на задачата MapReduce -
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
