
Какво е Hadoop? ArchiСтруктура, екосистема и компоненти
 Прафула Ранадив
⚡ Умно обобщение
Apache Hadoop е рамка с отворен код, която съхранява огромни набори от данни в клъстери от масови машини и премества логиката на обработка към данните, така че анализът се мащабира чрез добавяне на евтини възли, вместо по-големи сървъри.
Какво е Hadoop?
Apache Hadoop е софтуерна рамка с отворен код, използвана за разработване на приложения за обработка на данни, които се изпълняват в разпределена изчислителна среда.
Приложенията, изградени с помощта на Hadoop, се изпълняват върху големи масиви от данни, разпределени в клъстери от масови компютри. Масовите компютри са евтини и широко достъпни. Те са полезни главно за постигане на по-голяма изчислителна мощност на ниска цена.
Подобно на данните, намиращи се в локална файлова система на персонален компютър, в Hadoop данните се намират в разпределена файлова система, която се нарича Разпределена файлова система HadoopМоделът на обработка е базиран на „Местност на данните“ концепция, при която изчислителната логика се изпраща към клъстерните възли (сървъри), съдържащи данните. Тази изчислителна логика е просто компилирана версия на програма, написана на език от високо ниво, като например JavaТакава програма обработва данни, съхранени в Hadoop HDFS.
Знаеш ли? Компютърният клъстер се състои от набор от множество процесорни устройства (диск за съхранение + процесор), които са свързани помежду си и действат като единна система.
Версия 3.5.0, публикувана на 2 април 2026 г., е текущата стабилна версия; линията 3.4 все още получава актуализации за поддръжка.
Hadoop екосистема и компоненти
Диаграмата по-долу показва различните компоненти в екосистемата Hadoop, групирани по задачата, която всеки от тях изпълнява – съхранение, обработка и инструменти за заявки, приемане и координация около тях.

Apache Hadoop се състои от два подпроекта –
- Hadoop MapReduce: MapReduce е изчислителен модел и софтуерна рамка за писане на приложения, които се изпълняват на Hadoop. Тези програми MapReduce са в състояние да обработват огромни данни паралелно на големи клъстери от изчислителни възли.
- HDFS (Разпределена файлова система Hadoop): HDFS се грижи за частта за съхранение на приложенията на Hadoop. Приложенията MapReduce консумират данни от HDFS. HDFS създава множество реплики на блокове данни и ги разпределя в изчислителни възли в клъстер. Това разпределение позволява надеждни и изключително бързи изчисления.
Текущите издания доставят два допълнителни основни модула. Hadoop прежда, добавен в Hadoop 2.x, планира работата на клъстера и Хадуп Комън държи споделеното Java библиотеки, от които зависи всеки модул. YARN е това, което позволява на двигатели като Spark, Tez и Flink работят успоредно с MapReduce.
Въпреки че Hadoop е най-известен с MapReduce и неговата разпределена файлова система HDFS, терминът се използва и за семейство свързани проекти, които попадат под шапката на разпределените изчисления и мащабната обработка на данни. Други проекти, свързани с Hadoop в Apache, включват Кошер, HBase, Mahout, Sqoop, Flumeи Зоопарк.
Hadoop Archiтекстура
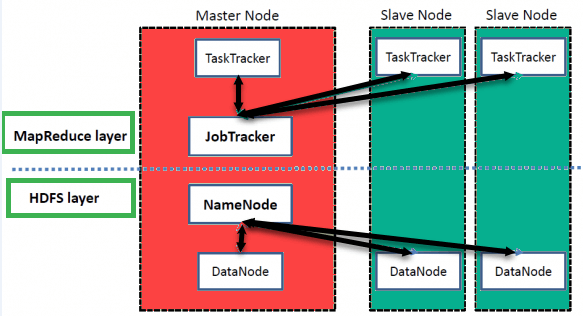
Hadoop има master-slave архитектура за съхранение на данни и разпределена обработка на данни, използвайки MapReduce и HDFS методи. Диаграмата по-долу поставя тези роли една до друга, като слоят за съхранение е от едната страна, а слоят за обработка е от другата.
Hadoop на високо ниво Archiтекстура
NameNode
NameNode съхранява метаданните за всеки файл и директория, използвани в пространството от имена, включително кои блокове съставляват всеки файл и къде се намират тези блокове.
Възел на данни
DataNode управлява състоянието на HDFS възел и ви позволява да взаимодействате с блоковете, които съхранява, като докладва обратно на NameNode с периодични отчети за блокове и пулсации.
Главен възел
Главният възел ви позволява да провеждате паралелна обработка на данни с помощта на Hadoop MapReduce.
Подчинен възел
Подчинените възли са допълнителните машини в клъстера Hadoop, които ви позволяват да съхранявате данни и да изпълнявате сложни изчисления. Освен това, всеки подчинен възел изпълнява задача (Task).Tracker и DataNode. Това ви позволява да синхронизирате процесите с NameNode и JobTracкер съответно.
В Hadoop, главни или подчинени системи могат да бъдат настроени в облака или локално.
Една бележка за именуване: РаботаTracКер намлява TaskTracКер принадлежат към първото поколение среда за изпълнение MapReduce (MRv1). От Hadoop 2.x нататък, YARN разделя задълженията си между клъстерна среда Мениджър на ресурси, и NodeManager на работник и един ApplicationMaster за всяка задача. NameNode и DataNode остават непроменени.
Характеристики на Hadoop
Подходящ за анализ на големи данни
As Голямо количество от данни Тъй като по природа са разпределени и неструктурирани, Hadoop клъстерите са най-подходящи за анализ на големи данни. Тъй като логиката за обработка (не самите данни) се предава към изчислителните възли, се изразходва по-малко мрежова честотна лента. Това се нарича концепция за локализация на даннитеи това помага за повишаване на ефективността на приложенията, базирани на Hadoop.
скалируемост
Клъстерите Hadoop могат лесно да бъдат мащабирани до всякаква степен чрез добавяне на допълнителни клъстерни възли и по този начин да се позволи растежът на големите данни. Също така, мащабирането не изисква модификации в логиката на приложението.
Толерантност на грешки
Екосистемата Hadoop има възможност за репликиране на входните данни към други клъстерни възли. По този начин, в случай на повреда на клъстерен възел, обработката на данни може да продължи, като се използват данни, съхранени на друг клъстерен възел. HDFS съхранява три копия на всеки блок по подразбиране, стойност, зададена от dfs.replication свойството, а NameNode репликира повторно всеки блок, чийто брой падне под този брой.
Мрежова топология в Hadoop
Топологията (подредбата) на мрежата влияе върху производителността на Hadoop клъстера с нарастването на размера на клъстера. В допълнение към производителността, трябва да се обърне внимание и на високата достъпност и обработката на повреди. За да се постигне това, формирането на Hadoop клъстери използва мрежова топология.
Дървото по-долу показва как е моделирана тази подредба, от центъра за данни до възлите във всеки стелаж.

Обикновено мрежовата пропускателна способност е важен фактор, който трябва да се вземе предвид при формирането на всяка мрежа. Тъй като измерването на пропускателната способност може да бъде трудно, в Hadoop мрежата се представя като дърво, а разстоянието между възлите на това дърво (броят на преходите) се счита за важен фактор при формирането на Hadoop клъстер. Тук разстоянието между два възела е равно на сумата от разстоянията им до най-близкия им общ предшественик.
Клъстерът Hadoop се състои от център за данни, стелаж и възел, който реално изпълнява задачи. Тук центърът за данни се състои от стелажи, а стелажът се състои от възли. Мрежовата честотна лента, достъпна за процесите, варира в зависимост от местоположението на процесите. Тоест, наличната честотна лента намалява с отдалечаването от...
- Процеси на един и същи възел
- Различни възли на една и съща стойка
- Възли на различни стелажи на един и същ център за данни
- Възли в различни центрове за данни
Осведомеността за стелажи използва същото дърво: HDFS поставя реплики на повече от един стелаж, така че загубата на стелажния комутатор не отнема всяко копие на данните със себе си.
