
البرنامج التعليمي لـ Apache Flume: ما هو، Archiمثال على التقنية وHadoop
 برافولا راناديفي
⚡ ملخص ذكي
Apache Flume هي خدمة موزعة لجمع وتجميع ونقل كميات كبيرة من بيانات السجلات إلى HDFS، وهي مبنية حول وكلاء يربطون المصدر والقناة والمصب معًا.
ما هو أباتشي فلوم في Hadoop؟
أباتشي فلوم هو نظام موثوق وموزع لجمع وتجميع ونقل كميات هائلة من بيانات السجلات. يتميز ببنية بسيطة ومرنة تعتمد على تدفقات البيانات المتدفقة. يُستخدم أباتشي فلوم لجمع بيانات السجلات الموجودة في ملفات السجلات من خوادم الويب وتجميعها في HDFS للتحليل.
يدعم Flume في Hadoop مصادر متعددة، بما في ذلك:
- 'tail' (الذي يقوم بنقل البيانات من ملف محلي وكتابتها في HDFS عبر Flume، على غرار أمر Unix 'tail')
- سجلات النظام
- أباتشي سجل 4j (مما يتيح Java تطبيقات لكتابة الأحداث إلى الملفات في HDFS عبر Flume).
الإصدار الحالي هو Flume 1.11.0نُشر في 25 أكتوبر 2022، وهو متاح من صفحة تنزيل Apache Flumeتمت كتابة هذا الدليل الإرشادي بناءً على الإصدار 1.4.0، لذا فإن العديد من الخطوات أدناه تحمل ملاحظة حيث يتصرف الإصدار الحالي بشكل مختلف.
وهد Architecture
عامل التدفق هو JVM عملية تتكون من ثلاثة عناصر - مصدر فلوم، وقناة فلوم، ومصب فلوم - تنتقل عبرها الأحداث بعد بدءها من مصدر خارجي. يوضح الرسم التخطيطي أدناه كيفية اتصالها.
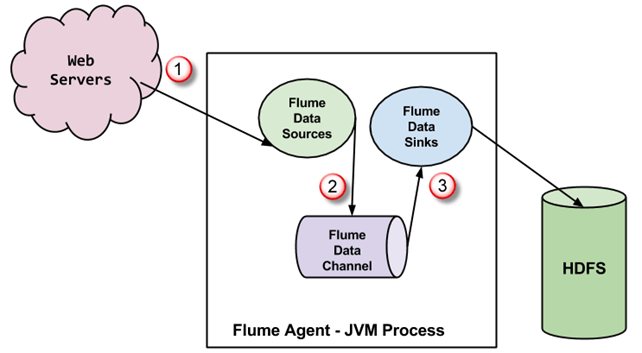
- تستهلك منصة Flume الأحداث التي يُنشئها المصدر الخارجي (خادم الويب). ويرسل المصدر الخارجي الأحداث إلى منصة Flume بتنسيق تتعرف عليه المنصة المستهدفة.
- يستقبل مصدر Flume حدثًا ويخزنه في قناة واحدة أو أكثر. تعمل القناة كمخزن يحتفظ بالحدث حتى يستهلكه مستقبل Flume. قد تستخدم هذه القناة نظام ملفات محليًا لتخزين هذه الأحداث.
- يقوم مُستقبِل Flume بإزالة الحدث من القناة وتخزينه في مستودع خارجي مثل HDFS. قد يكون هناك عدة وكلاء Flume، وفي هذه الحالة يقوم مُستقبِل Flume بإعادة توجيه الحدث إلى مصدر Flume الخاص بالوكيل التالي في التدفق.
بعض الميزات المهمة لقناة المياه
- يتميز Flume بتصميم مرن يعتمد على تدفقات البيانات المتدفقة. وهو مقاوم للأعطال وقوي، مع آليات متعددة للتعافي من الأعطال. يوفر Flume مستويات مختلفة من الموثوقية، بما في ذلك "التسليم بأقصى جهد" و "التسليم الشامل". تسليم بأفضل جهد لا يتسامح مع أي عطل في عقدة Flume، بينما التسليم من طرف إلى طرف يضمن التسليم حتى في حالة حدوث أعطال في عدة عقد.
- ينقل نظام Flume البيانات بين مصادرها ومستقبلاتها. ويمكن أن تتم عملية جمع البيانات هذه إما بشكل مجدول أو بناءً على أحداث محددة. يمتلك Flume محرك معالجة استعلامات خاص به، مما يسهل تحويل كل دفعة بيانات جديدة قبل نقلها إلى وجهتها المقصودة.
- ممكن المصارف المسايل يشمل ذلك نظام ملفات HDFS و HBaseيمكن لـ Flume أيضًا نقل بيانات الأحداث مثل بيانات حركة مرور الشبكة، والبيانات التي تولدها مواقع التواصل الاجتماعي ورسائل البريد الإلكتروني.
المسايل والمكتبة وإعداد التعليمات البرمجية المصدر
قبل أن نبدأ بالعملية الفعلية، تأكد من تثبيت Hadoop؛ إذا لم يكن مثبتًا، فتابع من خلال كيفية تثبيت هادوب أولاً. قم بتغيير المستخدم إلى 'hduser' (المعرف المستخدم أثناء تكوين Hadoop؛ يمكنك التبديل إلى معرف المستخدم المستخدم أثناء تكوين Hadoop الخاص بك).

الخطوة 1) أنشئ مجلدًا جديدًا باسم 'FlumeTutorial'.
sudo mkdir FlumeTutorial
- امنح صلاحيات القراءة والكتابة والتنفيذ.
sudo chmod -R 777 FlumeTutorial
- انسخ الملفات MyTwitterSource.java و MyTwitterSourceForFlume.java إلى هذا المجلد.
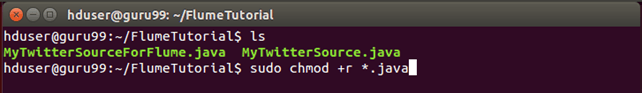
تحقق من أذونات الملفات لجميع هذه الملفات، كما هو موضح أدناه، وامنح إذن "القراءة" إذا كان مفقودًا.
الخطوة 2) قم بتنزيل برنامج "أباتشي فلوم" من https://flume.apache.org/download.html.
تم استخدام Apache Flume 1.4.0 في هذا البرنامج التعليمي Flume.

ثم انقر للوصول إلى نسخة طبق الأصل.

الخطوة 3) انسخ الملف المضغوط الذي تم تنزيله إلى المجلد الذي تختاره ثم قم بفك ضغطه.tracقم باستعراض المحتويات باستخدام الأمر التالي.
sudo tar -xvf apache-flume-1.4.0-bin.tar.gz

يؤدي هذا إلى إنشاء دليل جديد باسم apache-flume-1.4.0-bin و extracيتم وضع الملفات فيه. ويُشار إلى هذا المجلد باسم في بقية المقال.
الخطوة 4) إعداد مكتبة Flume. انسخ الملفات التالية: twitter4j-core-4.0.1.jar، وflume-ng-configuration-1.4.0.jar، وflume-ng-core-1.4.0.jar، وflume-ng-sdk-1.4.0.jar إلى
/ليب/
قد تحتوي بعض أو جميع ملفات JAR المنسوخة على إذن التنفيذ، مما قد يُسبب مشكلة في تجميع الكود، لذا قم بإلغائه. في حالتي، كان ملف twitter4j-core-4.0.1.jar يحتوي على إذن التنفيذ. قمتُ بإلغائه كما هو موضح أدناه.
sudo chmod -x twitter4j-core-4.0.1.jar

بعد ذلك، يمنح الأمر أدناه إذن "القراءة" على twitter4j-core-4.0.1.jar للجميع.
sudo chmod +rrr /usr/local/apache-flume-1.4.0-bin/lib/twitter4j-core-4.0.1.jar
يرجى ملاحظة أنني قمت بتنزيل ملف twitter4j-core-4.0.1.jar من مستودع مافنوجميع ملفات Flume JAR، أي flume-ng-*-1.4.0.jar، من org.apache.flume artifacts.
تحميل البيانات من تويتر باستخدام Flume
الخطوة 1) انتقل إلى المجلد الذي يحتوي على ملفات التعليمات البرمجية المصدرية.
الخطوة 2) قم بتعيين CLASSPATH ليحتوي على /lib/* و ~/FlumeTutorial/flume/mytwittersource/*.
export CLASSPATH="/usr/local/apache-flume-1.4.0-bin/lib/*:~/FlumeTutorial/flume/mytwittersource/*"

الخطوة 3) قم بتجميع الكود المصدري باستخدام الأمر أدناه.
javac -d . MyTwitterSourceForFlume.java MyTwitterSource.java

الخطوة 4) أنشئ ملف JAR. أولاً، أنشئ ملف Manifest.txt باستخدام محرر نصوص من اختيارك وأضف السطر التالي إليه.
Main-Class: flume.mytwittersource.MyTwitterSourceForFlume
هنا، flume.mytwittersource.MyTwitterSourceForFlume هو اسم الفئة الرئيسية. يُرجى ملاحظة أنه يجب عليك الضغط على مفتاح الإدخال (Enter) في نهاية هذا السطر، كما هو موضح أدناه.

الآن، قم بإنشاء ملف JAR 'MyTwitterSourceForFlume.jar' كما يلي.
jar cfm MyTwitterSourceForFlume.jar Manifest.txt flume/mytwittersource/*.class

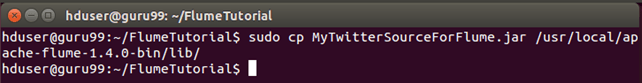
الخطوة 5) انسخ ملف JAR هذا إلى /lib/.
sudo cp MyTwitterSourceForFlume.jar <Flume Installation Directory>/lib/
الخطوة 6) انتقل إلى دليل إعدادات Flume، /conf.
إذا لم يكن ملف flume.conf موجودًا، فانسخ ملف flume-conf.properties.template وأعد تسميته إلى flume.conf.
sudo cp flume-conf.properties.template flume.conf

إذا لم يكن الملف flume-env.sh موجودًا، فانسخ الملف flume-env.sh.template وأعد تسميته إلى flume-env.sh.
sudo cp flume-env.sh.template flume-env.sh

إنشاء تطبيق تويتر
اقرأ هذا أولاً. البث المباشر الإصدار 1.1 statuses/filter تم إيقاف نقطة النهاية التي يحتاجها twitter4j 4.0.1 في 9 مارس 2023، وتم استبدالها بواجهة برمجة التطبيقات v2 التي تعمل بتقنية التدفق المُصفّى، وهي الآن على developer.x.comيقع خلف مستوى مدفوع. تعامل مع الشاشات أدناه كنمط مصدر مخصص، ثم وجّه نفس الوكيل إلى ملف أو ملف تنفيذي أو مصدر Kafka.
الخطوة 1) أنشئ تطبيقًا على تويتر عن طريق تسجيل الدخول إلى بوابة المطورين.


الخطوة 2) انتقل إلى "تطبيقاتي" (يظهر هذا الخيار عند النقر على زر "البيضة" في الزاوية العلوية اليمنى).

الخطوة 3) أنشئ تطبيقًا جديدًا بالنقر على "إنشاء تطبيق جديد".
الخطوة 4) املأ بيانات الطلب بتحديد اسم التطبيق ووصفه وموقعه الإلكتروني. يمكنك الرجوع إلى الملاحظات الواردة أسفل كل خانة إدخال.
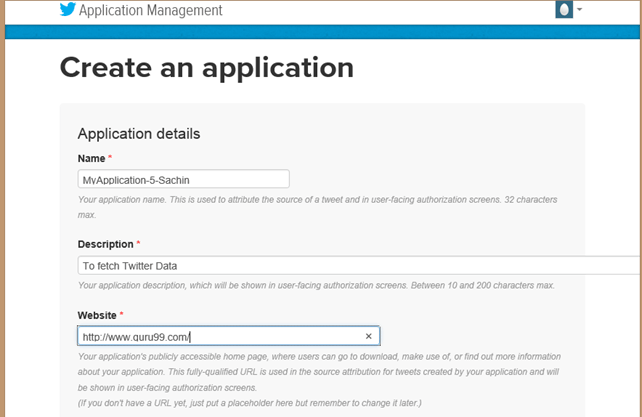
الخطوة 5) قم بالتمرير لأسفل الصفحة، واقبل الشروط عن طريق تحديد "نعم، أوافق" وانقر على زر "إنشاء تطبيق تويتر الخاص بك".

الخطوة 6) في نافذة التطبيق الذي تم إنشاؤه حديثًا، انتقل إلى علامة التبويب "مفاتيح API"، وقم بالتمرير لأسفل الصفحة وانقر فوق الزر "إنشاء رمز الوصول الخاص بي".


الخطوة 7) قم بتحديث الصفحة.
الخطوة 8) انقر على "اختبار OAuth". سيؤدي هذا إلى عرض إعدادات "OAuth" الخاصة بالتطبيق.

الخطوة 9) قم بتعديل ملف 'flume.conf' باستخدام إعدادات OAuth هذه. تجد أدناه خطوات تعديل ملف 'flume.conf'.

نحتاج إلى نسخ مفتاح المستهلك، وسر المستهلك، ورمز الوصول، وسر رمز الوصول من أجل تحديث ملف 'flume.conf'.
ملاحظة: هذه القيم تخص المستخدم وبالتالي فهي سرية، لذا لا ينبغي مشاركتها.
تعديل ملف "flume.conf".
الخطوة 1) افتح ملف 'flume.conf' في وضع الكتابة وقم بتعيين قيم المعلمات أدناه.
sudo gedit flume.conf
انسخ المحتويات أدناه.
MyTwitAgent.sources = Twitter
MyTwitAgent.channels = MemChannel
MyTwitAgent.sinks = HDFS
MyTwitAgent.sources.Twitter.type = flume.mytwittersource.MyTwitterSourceForFlume
MyTwitAgent.sources.Twitter.channels = MemChannel
MyTwitAgent.sources.Twitter.consumerKey = <Copy consumer key value from Twitter App>
MyTwitAgent.sources.Twitter.consumerSecret = <Copy consumer secret value from Twitter App>
MyTwitAgent.sources.Twitter.accessToken = <Copy access token value from Twitter App>
MyTwitAgent.sources.Twitter.accessTokenSecret = <Copy access token secret value from Twitter App>
MyTwitAgent.sources.Twitter.keywords = guru99
MyTwitAgent.sinks.HDFS.channel = MemChannel
MyTwitAgent.sinks.HDFS.type = hdfs
MyTwitAgent.sinks.HDFS.hdfs.path = hdfs://localhost:54310/user/hduser/flume/tweets/
MyTwitAgent.sinks.HDFS.hdfs.fileType = DataStream
MyTwitAgent.sinks.HDFS.hdfs.writeFormat = Text
MyTwitAgent.sinks.HDFS.hdfs.batchSize = 1000
MyTwitAgent.sinks.HDFS.hdfs.rollSize = 0
MyTwitAgent.sinks.HDFS.hdfs.rollCount = 10000
MyTwitAgent.channels.MemChannel.type = memory
MyTwitAgent.channels.MemChannel.capacity = 10000
MyTwitAgent.channels.MemChannel.transactionCapacity = 1000

الخطوة 2) قم أيضًا بتعيين TwitterAgent.sinks.HDFS.hdfs.path كما هو موضح أدناه.
TwitterAgent.sinks.HDFS.hdfs.path = hdfs:// : / /المسيل/تغريدات/

للعثور على ، و انظر إلى قيمة المعلمة 'fs.defaultFS' المحددة في $HADOOP_HOME/etc/hadoop/core-site.xml، كما هو موضح أدناه.

الخطوة 3) من أجل تفريغ البيانات إلى نظام ملفات Hadoop الموزع (HDFS) عند ورودها، احذف الإدخال أدناه إذا كان موجودًا.
TwitterAgent.sinks.HDFS.hdfs.rollInterval = 600
مثال: دفق بيانات تويتر باستخدام Flume
الخطوة 1) افتح ملف 'flume-env.sh' في وضع الكتابة وقم بتعيين قيم المعلمات أدناه.
JAVA_HOME=<Installation directory of Java>
FLUME_CLASSPATH="<Flume Installation Directory>/lib/MyTwitterSourceForFlume.jar"

الخطوة 2) ابدأ تشغيل هادوب.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
الخطوة 3) اثنان من ملفات JAR الموجودة في حزمة Flume المضغوطة غير متوافقين مع Hadoop 2.2.0، لذا في هذا المثال الخاص بـ Apache Flume، نتبع الخطوات التالية لجعل Flume متوافقًا مع Hadoop 2.2.0. يُعد استبدال ملف JAR هذا إصلاحًا لإصدار 1.4.0؛ إذ أن Flume 1.11.0 يتضمن بالفعل إصدارات protobuf وGuava الحديثة، لذا لا تحتاج الحزمة المضغوطة الحديثة عادةً إلى أيٍّ منها.
أ. انقل ملف protobuf-java-2.4.1.jar من ' /lib'. انتقل إلى هذا المجلد أولاً.
قرص مضغوط /lib
sudo mv protobuf-java-2.4.1.jar ~/

ب. ابحث عن ملف JAR المسمى 'guava' كما هو موضح أدناه.
find . -name "guava*"

انقل ملف guava-10.0.1.jar من ' /lib'.
sudo mv guava-10.0.1.jar ~/

ج. قم بتنزيل ملف guava-17.0.jar من مستودع مافن، ظاهر أدناه.

الآن، انسخ ملف JAR الذي تم تنزيله إلى ' /lib'.
الخطوة 4) انتقل إلى قم بتشغيل الأمر /bin' وابدأ تشغيل Flume كما يلي.
./flume-ng agent -n MyTwitAgent -c conf -f <Flume Installation Directory>/conf/flume.conf

تبدو نافذة موجه الأوامر التي يقوم برنامج Flume من خلالها بجلب التغريدات على هذا النحو.

من رسالة نافذة الأوامر، نلاحظ أن المخرجات تُكتب في المجلد /user/hduser/flume/tweets/. الآن، افتح هذا المجلد باستخدام متصفح الويب.
الخطوة 5) للاطلاع على نتيجة تحميل البيانات، افتح الرابط http://localhost:50070/ في متصفح، ثم تصفح نظام الملفات، ثم انتقل إلى الدليل الذي تم تحميل البيانات فيه، أي
/المسيل/تغريدات/
المنفذ 50070 هو واجهة المستخدم الخاصة بـ NameNode على Hadoop 2؛ قام Hadoop 3 بنقل نفس الصفحة إلى المنفذ 9870.

يمثل التدفق نصف عملية الابتلاع: سكوب يستورد الجداول على دفعات، ثم يقوم Flume ببث الأحداث، خنزير or خلية النحل قم بتشكيل الملفات و أوزي يُحدد جدولة السلسلة. انظر أيضًا أدوات تحليل البيانات الضخمة, عمليات الربط والعدادات في MapReduce و Talend.
