
البرنامج التعليمي لـ Hadoop Pig: ما هو Apache Pig؟ Archiالبنية، مثال
 برافولا راناديفي
⚡ ملخص ذكي
أباتشي بيج هي منصة عالية المستوى لتحليل مجموعات البيانات الكبيرة على هادوب، حيث تجمع بين لغة تدفق البيانات بيج لاتين ووقت تشغيل يقوم بتجميع كل نص برمجي إلى MapReduce أو Tez أو Spark يتم تنفيذ المهام تلقائيًا.
يبدأ هذا البرنامج التعليمي بالفكرة الكامنة وراء Apache Pig، ثم يشرح بالتفصيل عملية تثبيته وتشغيل برنامج Pig Latin كامل من البداية إلى النهاية.
ما هو خنزير أباتشي؟
الخنزير هو مستوى عالٍ لغة برمجة يُعد برنامج Pig مفيدًا لتحليل مجموعات البيانات الكبيرة. وقد كان نتاجًا لجهود التطوير في شركة Yahoo!
في إطار عمل MapReduce، يجب ترجمة البرامج إلى سلسلة من مراحل Map وReduce. ومع ذلك، فإن هذا ليس نموذج برمجة مألوفًا لمحللي البيانات. لذا، لسد هذه الفجوة، تم تطوير نموذج برمجة مستقل.tracتم بناء منطقة تسمى بيغ فوق Hadoop.
يُمكّن Apache Pig المستخدمين من التركيز بشكل أكبر على تحليل مجموعات البيانات الضخمة، وتقليل الوقت المُستغرق في كتابة برامج MapReduce. وكما هو الحال مع الخنازير التي تأكل أي شيء، صُممت لغة برمجة Apache Pig للعمل على أي نوع من البيانات. ولهذا السبب سُميت بـ Pig! ويُؤكد شعار المشروع أدناه على هذه الفكرة.

المشروع لا يزال قائماً. أباتشي بيغ 0.18.0 تم إصداره في 15 سبتمبر 2025، ويضيف دعمًا لـ Hadoop 3 و Tez 0.10 و Hive 3. Spark 3، HBase 2 و Python 3، وفقًا لـ صفحة إصدارات أباتشي بيغتمت كتابة الدليل أدناه في الأصل على أساس الإصدار 0.12.1 الأقدم بكثير، لذا فإن بعض الخطوات تحمل ملاحظة حيث يتصرف الإصدار الحالي بشكل مختلف.
خنزير Architecture
يتكون تصميم Pig من عنصرين:
- خنزير لاتيني, وهي لغة
- بيئة وقت التشغيل، لتشغيل برامج Pig Latin.
يتألف برنامج Pig Latin من سلسلة من العمليات أو التحويلات التي تُطبق على بيانات الإدخال لإنتاج المخرجات. تصف هذه العمليات تدفق البيانات الذي يُترجم إلى تمثيل قابل للتنفيذ بواسطة بيئة تنفيذ Hadoop Pig. في جوهرها، تُمثل نتائج هذه التحويلات سلسلة من مابريديوس وظائف قد لا يكون المبرمج على دراية بها. لذا، بطريقة ما، يسمح Pig في Hadoop للمبرمج بالتركيز على البيانات بدلاً من طبيعة التنفيذ.
لغة Pig Latin هي لغة جامدة نسبياً تستخدم كلمات مفتاحية مألوفة من معالجة البيانات، مثل: Join و Group و Filter. الرسم البياني أدناه traces عبارة عن نص برمجي من واجهة Grunt shell عبر المحلل اللغوي والمُحسِّن والمُجمِّع في طريقه إلى محرك التنفيذ.

أوضاع التنفيذ
يحتوي Pig in Hadoop على وضعين للتنفيذ، ويستخدم دليل التثبيت الموضح أدناه كلا الوضعين:
- الوضع المحلي: في هذا الوضع، تعمل لغة Hadoop Pig في بيئة واحدة JVM ويستخدم نظام الملفات المحلي. هذا الوضع مناسب فقط لتحليل مجموعات البيانات الصغيرة باستخدام Pig في Hadoop.
- وضع MapReduce: في هذا الوضع، تُترجم الاستعلامات المكتوبة بلغة Pig Latin إلى مهام MapReduce وتُنفذ على مجموعة Hadoop (قد تكون المجموعة موزعة جزئيًا أو كليًا). يُعد وضع MapReduce مع مجموعة موزعة كليًا مفيدًا لتشغيل Pig على مجموعات بيانات ضخمة.
هذان هما الزوج الكلاسيكي. في الواقع، تعرض الإصدارات الحالية ستة أنواع تنفيذ، أو أنماط تنفيذ، يتم اختيار كل منها بنفس الطريقة. -x العلم، كما هو موثق في دليل البدء السريع لبرنامج Pig 0.18.0.
| نموذج تنفيذي | أمر | حيث يجري العمل |
|---|---|---|
| محلّي | pig -x local | آلة جافا افتراضية واحدة تعمل على نظام الملفات المحلي |
| تيز لوكال | pig -x tez_local | جهاز JVM واحد يستخدم وقت تشغيل Tez (تجريبي) |
| Spark محلي | pig -x spark_local | آلة جافا افتراضية واحدة تستخدم Spark وقت التشغيل (تجريبي) |
| مابريديوس | pig أو pig -x mapreduce | مجموعة هادوب مع نظام ملفات هادوب الموزع (HDFS)؛ هذا هو الوضع الافتراضي |
| تيز | خنزير -x تيز | مجموعة هادوب تشغل محرك تيز |
| Spark | خنزير -x شرارة | A Sparkمجموعة YARN أو Mesos مع HDFS |
أنواع بيانات لغة الخنزير اللاتينية و Operaالاختصاصات
قبل كتابة أي برنامج نصي، من المفيد معرفة ما يمكن لـ Pig استيعابه وما يمكنه فعله به. نموذج البيانات متداخل بالكامل، وهذا ما يسمح لـ Pig بقراءة ملفات السجلات وغيرها من المدخلات ذات البنية غير المنظمة التي قد يرفضها الجدول العلائقي.
تقدم لغة الخنزير اللاتينية نوعين من الأنواع:
- الأنواع العددية:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerوbigdecimalيُعرّف النص البرمجي النموذجي لاحقًا كل عمود على النحو التالي:chararray. - الأنواع المعقدة: a الصفوف (tuple) هي مجموعة مرتبة من الحقول وتتصرف كصف؛ أ حقيبة هي مجموعة غير مرتبة من الصفوف وتتصرف مثل الجدول؛ رسم خريطة هي مجموعة من أزواج المفاتيح والقيم التي يجب أن يكون مفتاحها
chararray.
ينقسم المشغلون إلى عدد قليل من الوظائف، ويتولى عدد قليل منهم إدارة جميع خطوط الأنابيب تقريبًا:
| المُشغل | ماذا يفعل |
|---|---|
| تحميل / تخزين | اقرأ علاقة من نظام الملفات واكتب النتيجة مرة أخرى |
| منقي | احتفظ فقط بالصفوف التي تطابق شرطًا معينًا |
| لكل منها... توليد | العمل عمودًا تلو الآخر، وإنشاء حقول جديدة |
| مجموعة / مجموعة مشتركة | قم بتجميع علاقة واحدة، أو علاقتين أو أكثر، باستخدام مفتاح. |
| الانضمام | دمج العلاقات من خلال وصلة داخلية أو خارجية |
| اتحاد / انقسام | دمج العلاقات معًا، أو تقسيم علاقة واحدة إلى عدة علاقات. |
| ترتيب حسب / مميز / حد | قم بفرز البيانات وإزالة التكرارات وتحديد الحد الأقصى لعدد الصفوف. |
| تفريغ / وصف / شرح / توضيح | افحص النتائج والمخططات وخطط التنفيذ وعمليات التشغيل النموذجية |
يمتلك مشغلو التفتيش الأربعة اختصارات خاصة ببرنامج Grunt أيضًا، مما يوفر الوقتping أثناء عملية تصحيح الأخطاء: \d لـ DUMP، \de لوصف، \e للشرح و \i للتوضيح.
المتطلبات الأساسية المسبقة
Pig أداة تعمل على جانب العميل. تقوم بتحليل النصوص البرمجية، وتخطيط العمل، وإرسال المهام، لكنها لا توفر مساحة تخزين أو مجموعة خوادم خاصة بها، لذا يجب أن يكون هناك تثبيت Hadoop جاهز للعمل أولاً. قائمة متطلبات Apache مختصرة.
| مكون | متطلبات | لماذا هو مطلوب |
|---|---|---|
| Hadoop | Hadoop 2.x أو 3.x، مع تصدير HADOOP_HOME | يُوفر نظام ملفات Hadoop الموزع (HDFS) ومحرك التنفيذ. في حال عدم وجود متغير بيئة HADOOP_HOME، يعود Pig 0.18.0 إلى استخدام Hadoop 2.7.3 المُضمّن. |
| Java | Java الإصدار 1.7 أو أحدث، مع ضبط متغير البيئة JAVA_HOME على جذر التثبيت. | الخنزير وشياطين هادوب هما Java برامج |
| Python (اختياري) | Python 2.7 | مطلوب فقط للبث Python وظائف يحددها المستخدم |
| النملة (اختياري) | النملة 1.8 | لا يلزم ذلك إلا عند بناء أو إعادة تجميع Pig من المصدر |
هناك نقطتان عمليتان إلى جانب تلك القائمة. أولاً، قم بتشغيل كل شيء كمستخدم لينكس لديه بالفعل دليل رئيسي في HDFS وإذن بالكتابة إليه؛ يستخدم هذا البرنامج التعليمي hduserالحساب الذي تم إنشاؤه أثناء إعداد Hadoop. ثانيًا، ابدأ تشغيل المجموعة قبل تشغيل Pig في وضع MapReduce، لأن Pig يفشل فورًا إذا كان NameNode وResourceManager معطلين. إذا لم يكن Hadoop مثبتًا بعد، فتابع الخطوات التالية كيفية تثبيت هادوب لأول مرة.
كيفية تنزيل وتثبيت Pig
الآن في هذا البرنامج التعليمي لـ Apache Pig، سوف نتعلم كيفية تنزيل وتثبيت Pig:
قبل أن نبدأ بالعملية الفعلية، تأكد من تثبيت Hadoop. غيّر المستخدم إلى 'hduser' (المعرّف المستخدم أثناء تكوين Hadoop؛ يمكنك التبديل إلى معرّف المستخدم المستخدم أثناء تكوين Hadoop الخاص بك).

الخطوة 1) قم بتنزيل أحدث إصدار مستقر من Pig Hadoop من أي من المواقع البديلة المتاحة على
https://pig.apache.org/releases.html
حدد ملف tar.gz (وليس src.tar.gz) لتنزيله، كما هو موضح أدناه.

الخطوة 2) بعد اكتمال التنزيل، انتقل إلى المجلد الذي يحتوي على ملف tar الذي تم تنزيله، ثم انقل الملف إلى الموقع الذي ترغب في تثبيت Pig Hadoop فيه. في هذه الحالة، سننقله إلى /usr/local.

انتقل إلى الدليل الذي سيحتوي على ملفات Pig Hadoop.
cd /usr/local
Extracقم بفحص محتويات ملف tar كما هو موضح أدناه.
sudo tar -xvf pig-0.12.1.tar.gz

الخطوة 3) قم بتعديل ملف ~/.bashrc لإضافة متغيرات البيئة المتعلقة بـ Pig.
افتح ملف ~/.bashrc في أي محرر نصوص من اختيارك وقم بإجراء التعديلات أدناه.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

الخطوة 4) الآن، قم بتفعيل إعدادات هذه البيئة باستخدام الأمر أدناه.
. ~/.bashrc

الخطوة 5) نحتاج إلى إعادة تجميع Pig لدعم Hadoop 2.2.0.
إليك الخطوات اللازمة للقيام بذلك.
انتقل إلى دليل المستخدم الرئيسي لـ Pig.
cd $PIG_HOME
قم بتثبيت Ant.
sudo apt-get install ant

ملاحظة: سيبدأ التنزيل وسيستغرق وقتاً حسب سرعة الإنترنت لديك.
أعد تجميع برنامج Pig.
sudo ant clean jar-all -Dhadoopversion=23

يرجى ملاحظة أنه في عملية إعادة التجميع هذه يتم تنزيل مكونات متعددة، لذلك يجب أن يكون النظام متصلاً بالإنترنت.
أيضًا، في حالة توقف هذه العملية في مكان ما وعدم رؤية أي حركة على موجه الأوامر لأكثر من 20 دقيقة، فاضغط على Ctrl + c وأعد تشغيل نفس الأمر.
في حالتنا، يستغرق الأمر 20 دقيقة.

تعود خطوة إعادة التجميع هذه إلى حقبة الإصدار 0.12.1، عندما تم بناء ملفات JAR المُشحونة باستخدام Hadoop 1 و -Dhadoopversion=23 غيّرت هذه العلامة إصدار Ant إلى Hadoop 0.23 و 2.x. يأتي Apache Pig 0.18.0 مزودًا بملفات تنفيذية تعمل بالفعل على Hadoop 2.7 والإصدارات الأحدث، بالإضافة إلى Hadoop 3، لذا في الإصدار الحالي، يمكنك عادةً فك ضغط الملف المضغوط والانتقال مباشرةً إلى الاختبار أدناه.
الخطوة 6) اختبر تثبيت Pig باستخدام الأمر
pig -help

مثال على سيناريو الخنزير
بعد تثبيت Pig، يُشغّل باقي هذا الدرس التعليمي لـ Apache Pig برنامجًا نصيًا كاملًا. سنستخدم Pig Scripts لمعرفة عدد المنتجات المباعة في كل دولة.
المدخلات: مجموعة بيانات الإدخال لدينا عبارة عن ملف CSV، SalesJan2009.csv.
الخطوة 1) ابدأ تشغيل هادوب.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
الخطوة 2) يقوم Pig in Big Data بأخذ ملف من HDFS في وضع MapReduce وتخزين النتائج مرة أخرى في HDFS.
انسخ الملف SalesJan2009.csv (المخزن على نظام الملفات المحلي في ~/input/SalesJan2009.csv) إلى الدليل الرئيسي لنظام الملفات الموزعة Hadoop (HDFS).
في هذا المثال الخاص بـ Apache Pig، يوجد الملف في مجلد الإدخال. إذا كان الملف مخزناً في موقع آخر، فاستخدم ذلك الاسم بدلاً من ذلك.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

تحقق مما إذا تم نسخ الملف بالفعل أم لا.
$HADOOP_HOME/bin/hdfs dfs -ls /

الخطوة 3) تكوين الخنزير.
أولاً، انتقل إلى $PIG_HOME/conf واحتفظ بنسخة من ملف الخصائص الأصلي.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

افتح ملف pig.properties باستخدام محرر نصوص من اختيارك، وحدد مسار ملف السجل باستخدام pig.logfile.
sudo gedit pig.properties

سيستخدم برنامج التسجيل هذا الملف لتسجيل الأخطاء.
الخطوة 4) قم بتشغيل الأمر 'pig'، والذي سيبدأ موجه أوامر Pig، وهو عبارة عن واجهة تفاعلية لاستعلامات Pig.
pig

الخطوة 5) في موجه أوامر Grunt الخاص بـ Pig، قم بتنفيذ أوامر Pig أدناه بالترتيب.
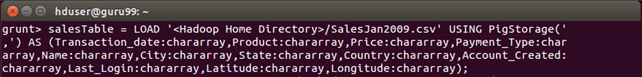
- أ. قم بتحميل الملف الذي يحتوي على البيانات.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
اضغط على Enter بعد هذا الأمر.
— ب. تجميع البيانات حسب حقل البلد.
GroupByCountry = GROUP salesTable BY Country;

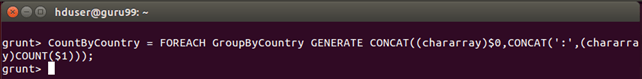
— ج. لكل صف في 'GroupByCountry'، قم بإنشاء السلسلة الناتجة بالشكل التالي: اسم البلد: عدد المنتجات المباعة.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
اضغط على Enter بعد هذا الأمر.
— د. قم بتخزين نتائج تدفق البيانات في الدليل 'pig_output_sales' على HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

سيستغرق تنفيذ هذا الأمر بعض الوقت. بمجرد الانتهاء، ستظهر لك الشاشة التالية.

الخطوة 6) يمكن رؤية النتيجة من خلال واجهة الأوامر كما يلي:
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

ويمكن أيضاً الاطلاع على النتائج عبر واجهة الويب.
افتح الرابط http://localhost:50070/ في متصفح الويب.
المنفذ 50070 هو واجهة المستخدم الخاصة بـ NameNode على Hadoop 2. نقل Hadoop 3 نفس الصفحة إلى المنفذ 9870، لذا استخدم هذا العنوان بدلاً من ذلك إذا كانت مجموعتك تعمل بنظام Hadoop 3.

الآن حدد "استعراض نظام الملفات" وانتقل إلى /user/hduser/pig_output_sales.

افتح الجزء r-00000 لقراءة أزواج البلد وعدد المنتجات التي أنتجها البرنامج النصي.

أباتشي بيج مقابل هايف مقابل ماب ريديوس
نادرًا ما يتم تقييم برنامج Pig بشكل مستقل. السؤال المعتاد هو ما إذا كانت الوظيفة مناسبة لبرنامج Pig، أم لا. خلية النحل أو في برنامج MapReduce مكتوب بخط اليد، حيث ينتهي الأمر بالثلاثة جميعًا كوظائف على نفس المجموعة.
| البعد | MapReduce (Java) | اباتشي خنزير | اباتشي خلية |
|---|---|---|---|
| السطح البيني | Java API | لغة Pig Latin، وهي لغة برمجة نصية لتدفق البيانات | خليةلهجة من لغة SQL |
| مستوى الامتصاصtracالإنتاج | منخفض | متوسط | مرتفع |
| المستخدم النموذجي | Java المطور | مهندس بيانات أو باحث | محلل يجيد استخدام لغة SQL |
| البيانات التي تناسبها | أي شيء، يتم التعامل معه يدوياً | مُهيكلة وشبه مُهيكلة؛ المخطط اختياري عند التحميل | الجداول المهيكلة المسجلة في مخزن البيانات الوصفية |
| Code حجم | معظم الخطوط | عدد أقل من الأسطر | أقل عدد من الأسطر للاستعلام |
| يعمل كـ | وظيفة MapReduce | يُترجم إلى MapReduce أو Tez أو Spark وظائف | يُترجم إلى MapReduce أو Tez أو Spark وظائف |
| خاصة في | تحكم كامل ومنطق مخصص | خطوط أنابيب ETL متعددة الخطوات | الاستعلام والتقارير المخصصة |
عمليًا، يكون التقسيم واضحًا. استخدم Hive عندما تكون البيانات مُرتبة كجدول، والسؤال مُصاغ بلغة SQL. استخدم Pig عندما تكون المدخلات غير مُنظمة، أو عندما تكون سلسلة العمليات عبارة عن سلسلة من التحويلات وليست استعلامًا واحدًا، أو عندما يتطلب نفس البرنامج النصي التفرع وإعادة الربط. استخدم MapReduce فقط عندما لا يكون أيٌّ من الخيارين مُجديًا.tracيمكن لـ tion أن تعبر عن المنطق، لأن عدد الأسطر ينمو بسرعة.
كما أن الخنزير ينسجم بشكل مريح مع بقية النظام البيئي. سكوب وفلوم قم بتحميل البيانات الأولية، ثم قم بتشكيلها باستخدام Pig أو Hive، ثم استخدم مُجدولًا مثل أباتشي أوزي يربط الخطوات في مسار متكرر. للاطلاع على الصورة الأوسع لمكانة هذه الأدوات، راجع الدليل الخاص بـ البيانات الكبيرة وملخص لـ أدوات البيانات الضخمةللاطلاع على بديل تجاري لعمليات استخراج البيانات وتحويلها وتحميلها (ETL) بدلاً من البرامج النصية المكتوبة يدويًا، انظر Talend.
