
ما هو Hadoop؟ Archiالبنية، النظام البيئي والمكونات
 برافولا راناديفي
⚡ ملخص ذكي
Apache Hadoop هو إطار عمل مفتوح المصدر يقوم بتخزين مجموعات بيانات ضخمة عبر مجموعات من الأجهزة العادية وينقل منطق المعالجة إلى البيانات، بحيث يمكن توسيع نطاق التحليل عن طريق إضافة عقد رخيصة بدلاً من خوادم أكبر.
ما هو Hadoop؟
Apache Hadoop هو إطار عمل برمجي مفتوح المصدر يستخدم لتطوير تطبيقات معالجة البيانات التي يتم تنفيذها في بيئة حوسبة موزعة.
تُشغَّل التطبيقات المبنية باستخدام هادوب على مجموعات بيانات ضخمة موزعة على مجموعات من الحواسيب التجارية. تتميز هذه الحواسيب برخص ثمنها وتوفرها على نطاق واسع، وهي مفيدة بشكل أساسي لتحقيق قدرة حسابية أكبر بتكلفة منخفضة.
على غرار البيانات الموجودة في نظام ملفات محلي لجهاز كمبيوتر شخصي، في هادوب، توجد البيانات في نظام ملفات موزع يسمى نظام الملفات الموزعة Hadoopيعتمد نموذج المعالجة على "مكانة البيانات" مفهوم يتم فيه إرسال منطق حسابي إلى عقد المجموعة (الخوادم) التي تحتوي على البيانات. هذا المنطق الحسابي هو ببساطة نسخة مُجمّعة من برنامج مكتوب بلغة عالية المستوى مثل Javaيقوم هذا البرنامج بمعالجة البيانات المخزنة في Hadoop HDFS.
هل تعرف؟ تتكون مجموعة الحواسيب من مجموعة من وحدات المعالجة المتعددة (قرص التخزين + المعالج) المتصلة ببعضها البعض وتعمل كنظام واحد.
الإصدار 3.5.0، الذي تم نشره في 2 أبريل 2026، هو الإصدار المستقر الحالي؛ ولا يزال الإصدار 3.4 يتلقى تحديثات الصيانة.
نظام هادوب البيئي ومكوناته
يوضح الرسم البياني أدناه المكونات المختلفة في نظام Hadoop البيئي، مجمعة حسب الوظيفة التي يقوم بها كل منها - التخزين والمعالجة وأدوات الاستعلام والاستيعاب والتنسيق المحيطة بها.

يتكون Apache Hadoop من مشروعين فرعيين –
- Hadoop MapReduce: MapReduce هو نموذج حسابي وإطار عمل برمجي لكتابة التطبيقات التي يتم تشغيلها على Hadoop. تتمتع برامج MapReduce هذه بالقدرة على معالجة كميات هائلة من البيانات بالتوازي على مجموعات كبيرة من عقد الحوسبة.
- HDFS (نظام الملفات الموزعة Hadoop): يتولى HDFS مسؤولية جزء التخزين في تطبيقات Hadoop. تستهلك تطبيقات MapReduce البيانات من HDFS. ينشئ HDFS نسخًا متعددة من كتل البيانات ويوزعها على عقد الحوسبة في مجموعة. يتيح هذا التوزيع إجراء عمليات حسابية موثوقة وسريعة للغاية.
تتضمن الإصدارات الحالية وحدتين أساسيتين إضافيتين. غزل هادوبتمت إضافتها في Hadoop 2.x، وهي تُجدول العمل على المجموعة، و Hadoop المشتركة يضم المشترك Java المكتبات التي يعتمد عليها كل وحدة. YARN هو ما يسمح لمحركات مثل Spark، يعمل كل من Tez و Flink جنبًا إلى جنب مع MapReduce.
على الرغم من أن هادوب تشتهر بتقنية ماب ريديوس ونظام الملفات الموزعة HDFS، إلا أن المصطلح يُستخدم أيضًا للإشارة إلى مجموعة من المشاريع ذات الصلة التي تندرج تحت مظلة الحوسبة الموزعة ومعالجة البيانات واسعة النطاق. وتشمل المشاريع الأخرى ذات الصلة بهادوب في أباتشي ما يلي: خلية النحلإتش بيس، ماهوت، سكوب، فلوموZooKeeper.
Hadoop Architecture
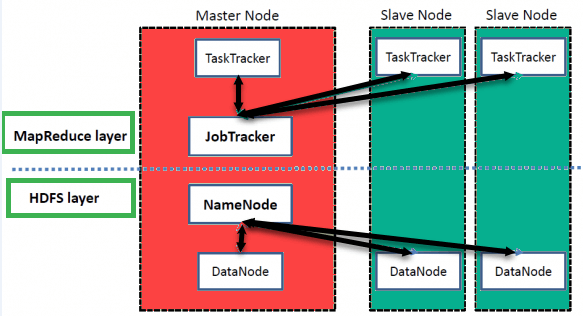
تعتمد هادوب على بنية رئيسية-تابعة لتخزين البيانات ومعالجة البيانات الموزعة باستخدام مابريديوس وطرق نظام ملفات Hadoop الموزع (HDFS). يوضح الرسم البياني أدناه هذه الأدوار جنبًا إلى جنب، مع وجود طبقة التخزين على جانب وطبقة المعالجة على الجانب الآخر.
هادوب عالي المستوى Architecture
NameNode
يقوم NameNode بتخزين البيانات الوصفية لكل ملف ودليل مستخدم في مساحة الاسم، بما في ذلك الكتل التي تشكل كل ملف ومكان وجود تلك الكتل.
داتاينود
تتولى عقدة البيانات إدارة حالة عقدة HDFS وتتيح لك التفاعل مع الكتل التي تخزنها، وترسل تقارير دورية إلى عقدة الاسم مع تقارير الكتل ونبضات القلب.
MasterNode
تتيح لك العقدة الرئيسية إجراء معالجة متوازية للبيانات باستخدام Hadoop MapReduce.
عقدة تابعة
تُعدّ العُقد التابعة أجهزةً إضافيةً في مجموعة Hadoop، تُمكّنك من تخزين البيانات وإجراء العمليات الحسابية المعقدة. علاوةً على ذلك، تُشغّل كل عُقدة تابعة مهمةً واحدةً.Tracker و DataNode. يتيح لك هذا مزامنة العمليات مع NameNode و JobTracكير على التوالي.
في هادوب، يمكن إعداد أنظمة رئيسية أو تابعة في السحابة أو في الموقع.
ملاحظة واحدة بخصوص التسمية: وظيفةTracكير و مهمةTracكير ينتمي إلى الجيل الأول من بيئة تشغيل MapReduce (MRv1). بدءًا من Hadoop 2.x، يقسم YARN مهامه بين مجموعة كاملة من المكونات مدير مواردأو المعلم NodeManager لكل عامل، وواحد مدير التطبيق لكل وظيفة. لم يطرأ أي تغيير على NameNode و DataNode.
ميزات هادوب
مناسب لتحليل البيانات الضخمة
As البيانات الكبيرة نظرًا لأن البيانات الضخمة تميل إلى أن تكون موزعة وغير منظمة بطبيعتها، فإن مجموعات Hadoop هي الأنسب لتحليلها. ولأن منطق المعالجة (وليس البيانات الفعلية) هو ما يتدفق إلى عقد الحوسبة، فإن استهلاك عرض النطاق الترددي للشبكة يكون أقل. وهذا ما يُسمى بـ مفهوم محلة البياناتويساعد ذلك على زيادة كفاءة التطبيقات القائمة على Hadoop.
التوسعة
يمكن توسيع نطاق مجموعات Hadoop بسهولة إلى أي مدى بإضافة عُقد إضافية، مما يسمح بنمو البيانات الضخمة. كما أن التوسع لا يتطلب تعديلات على منطق التطبيق.
التسامح مع الخطأ
يُتيح نظام Hadoop البيئي إمكانية نسخ بيانات الإدخال إلى عُقد أخرى في المجموعة. وبهذه الطريقة، في حال تعطل إحدى عُقد المجموعة، يُمكن استكمال معالجة البيانات باستخدام البيانات المخزنة على عُقدة أخرى. يحتفظ نظام ملفات Hadoop الموزع (HDFS) بثلاث نسخ من كل كتلة افتراضيًا، وهي قيمة مُحددة بواسطة... dfs.replication الخاصية، ويقوم NameNode بإعادة نسخ أي كتلة تنخفض عن هذا العدد.
بنية الشبكة في هادوب
تؤثر بنية الشبكة (ترتيبها) على أداء مجموعة Hadoop مع ازدياد حجمها. وبالإضافة إلى الأداء، من الضروري مراعاة التوافر العالي ومعالجة الأعطال. ولتحقيق ذلك، تستفيد عملية تكوين مجموعة Hadoop من بنية الشبكة.
يوضح الشكل الشجري أدناه كيفية تصميم هذا الترتيب، بدءًا من مركز البيانات وصولًا إلى العقد الموجودة داخل كل رف.

عادةً، يُعدّ عرض النطاق الترددي للشبكة عاملاً مهماً عند إنشاء أي شبكة. ولكن، نظراً لصعوبة قياس عرض النطاق الترددي، تُمثَّل الشبكة في هادوب على شكل شجرة، وتُعتبر المسافة بين عُقد هذه الشجرة (عدد القفزات) عاملاً مهماً في تكوين مجموعة هادوب. هنا، تُساوي المسافة بين عُقدتين مجموع المسافة بينهما وبين أقرب سلف مشترك لهما.
تتكون مجموعة Hadoop من مركز بيانات، وحامل، وعقدة تُنفذ المهام. يتكون مركز البيانات من حوامل، ويتكون الحامل من عقد. يختلف عرض النطاق الترددي المتاح للعمليات باختلاف موقعها، أي أنه يقل كلما ابتعدنا عن مركز البيانات.
- العمليات على نفس العقدة
- عقد مختلفة على نفس الرف
- العقد على رفوف مختلفة من نفس مركز البيانات
- العقد في مراكز البيانات المختلفة
يستخدم الوعي بالرف نفس الشجرة: يضع نظام الملفات الموزعة الموزعة (HDFS) النسخ المتماثلة على أكثر من رف واحد، لذا فإن فقدان مفتاح الرف لا يؤدي إلى فقدان كل نسخة من البيانات معه.
