
机器学习中的高斯核: Python 核方法
 编辑团队
本教程的目的是使数据集线性可分。本教程分为两部分:
- 特征变换
- 使用 TensorFlow 训练核分类器
第一部分,您将了解机器学习中核方法的基本思想;第二部分,您将学习如何训练核分类器。 TensorFlow您将使用成人数据集。该数据集的目标是根据每个家庭的行为,对收入低于和高于 50 万美元的家庭进行分类。
为什么需要核方法?
每个分类器的目标都是正确预测类别。为此,数据集必须是可分的。观察下图,可以很容易地看出,黑线以上的点都属于第一类,其余点属于第二类。然而,如此简单的数据集极其罕见。大多数情况下,数据是不可分的,而不可分的数据会给像逻辑回归这样的简单分类器带来很大的困难。
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

下图展示了一个非线性可分的数据集。如果用直线表示,大部分点都无法被正确分类。
解决这个问题的一种方法是获取数据集,并将其转换到另一个特征图上。这意味着你需要使用一个函数将数据移动到另一个平面,该平面应该是线性可分的。
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
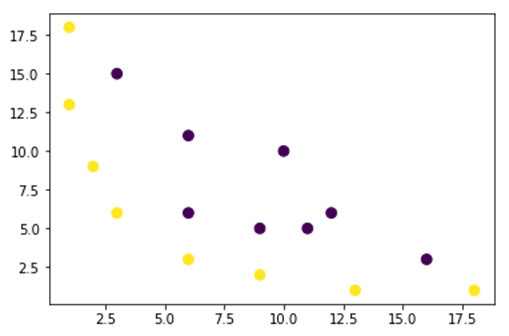
上图中的数据位于二维平面上,不可分离。您可以尝试将这些数据转换到三维空间,也就是创建一个具有三个坐标轴的图形。
在我们的高斯核示例中,我们将应用多项式映射。ping 将我们的数据转换到第三维度。转换数据的公式如下。

在高斯核中定义一个函数 Python 创建新的要素地图。
您可以使用 NumPy的 对上述公式进行编码。下面的每一行都对应映射中的一个项。ping 以及生成它的数组表达式,小图像标记了 2 的平方根因子。
| 公式 | 等效的 NumPy 代码 |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
新地图ping 有 3 个维度和 16 个点。
x_1  = mapping(x, y)
x_1.shape
(3, 16)
现在绘制一个新图,包含三个轴,分别为 x 轴、 y 轴和 z 轴。
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

我们看到有所改善,但如果我们改变图表的方向,就会清楚地看到数据集现在是可分离的。
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

如果您需要处理大型数据集并创建超过两个维度,上述方法将面临巨大挑战。实际上,您需要转换所有数据点,这显然是不可持续的。这将耗费大量时间,并且可能导致计算机内存耗尽。
解决此问题的最常见方法是使用内核。
机器学习中的内核是什么?
其思路是利用更高维度的特征空间,使数据几乎线性可分,如上图所示。
存在许多高维空间,使得数据点可分。例如,我们已经证明多项式映射ping 是一个很好的开始。
我们还证明,对于大量数据,这些转换效率不高。相反,您可以使用机器学习中的核函数来修改数据,而无需迁移到新的特征平面。
核函数的奥妙在于找到一个能够避免高维计算带来的所有麻烦的函数。核函数的结果是一个标量,或者换句话说,我们又回到了一维空间。
找到这个函数后,你可以把它代入标准线性分类器中。
以下示例能更具体地说明核机器学习的概念。假设有两个向量 x1 和 x2。目标是使用多项式映射来创建一个更高维度的向量。ping输出结果等于新特征图的点积。根据上述方法,您需要:
- 将 x1 和 x2 变换到新的维度
- 计算点积:所有内核的共同点
将 x1 和 x2 变换到新的维度
您可以使用上面创建的函数来计算更高的维度。
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
输出
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
计算点积
您可以使用对象点 NumPy的 计算存储在 x_1 中的第一个向量和第二个向量之间的点积。
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
输出结果是 8100。问题在于:你需要将一个新的特征图存储在内存中才能计算点积。如果你的数据集包含数百万条记录,这种方法的计算效率会非常低。
或者,您可以使用多项式核函数来计算点积,而无需变换向量。该函数计算 x1 和 x2 的点积,就好像这两个向量已被变换到更高维度一样。换句话说,核函数计算的是来自另一个特征空间的点积结果。
你可以将多项式核函数写成 Python 如下所示。
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
它是两个向量点积的幂。下面,你返回多项式核的二阶。输出等于另一种方法。这就是核的魔力。
polynomial_kernel(x1, x2, p=2)
8100
核方法的类型
有很多不同的核函数技术可供选择。最简单的是线性核函数。该函数在文本分类方面表现相当不错。其他核函数包括:
- 多项式内核
- 高斯核
下表总结了每种方法的作用以及从业者何时会用到它。
| 核心 | 它计算的是什么 | 典型用途 |
|---|---|---|
| 线性推力器 | 原始特征空间中的普通点积 | 已分离数据和高维文本特征 |
| 多项式 | 点积的 p 次方,用于捕捉特征交互 | 当相互作用已知时,弯曲边界会产生影响。 |
| 高斯(RBF) | 一种基于距离的相似度,随着点之间的距离增大,相似度趋近于零。 | 当边界形状未知时,通常首选的方法是…… |
在 TensorFlow 的示例中,我们将使用随机傅里叶特征。TensorFlow 内置了一个估计器来计算新的特征空间。随机傅里叶特征映射器是对高斯核函数的近似,如下所示。

高斯滤波函数计算更高维空间中数据点之间的相似性。
理论部分完成后,本教程的其余部分将高斯核应用于真实数据集。
使用 TensorFlow 训练高斯核分类器
该算法的目标是对收入高于或低于 50 万的家庭进行分类。
首先,您将评估一个逻辑回归模型,作为基准模型。之后,您将训练一个核分类器,看看是否能获得更好的结果。
您使用成人数据集中的以下变量:
- 年龄
- 工人阶级
- 风车
- 教育
- 教育编号
- 婚姻
- 占用
- 关系
- 种族
- 性别
- 资本收益
- 资本损失
- hours_week
- 祖国
- 标签
在训练和评估模型之前,您需要按以下步骤操作:
- 导入库
- 导入数据
- 准备数据
- 构建逻辑模型:基线模型
- 评估模型
- 构建并评估核分类器
版本说明: 以下所有代码片段均针对 TensorFlow 1.x 版本。TensorFlow 2.0 中移除了提供 real_valued_column、RandomFourierFeatureMapper 和 KernelLinearClassifier 的 tf.contrib 命名空间,而 tf.estimator 本身也在 TensorFlow 2.16 中被移除。在当前版本中,可以使用 tf.keras.layers.experimental.RandomFourierFeatures 层后接一个 Dense 输出层来构建相同的管道,或者使用 scikit-learn 中的 RBFSampler 和 SGDClassifier 组合。
步骤 1)导入库
导入并训练内核模型 人工智能你需要导入TensorFlow, 大熊猫 以及 NumPy。
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
步骤2)导入数据
您从以下位置下载数据: UCI成人数据集页面 并将其作为 pandas DataFrame 导入。
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
现在训练集和测试集已经定义好了,您可以将列标签从字符串更改为整数。TensorFlow 不接受字符串类型的标签。
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
步骤3)准备数据
该数据集包含连续型和类别型特征。最佳实践是对连续型变量的值进行标准化。您可以使用 StandardScaler 函数。 scikit学习此外,您还可以创建一个用户自定义函数,以便更轻松地转换训练集和测试集。请注意,您需要将连续变量和分类变量连接成一个公共数据集,并且该数组的类型应为 float32。
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
转换器函数已准备就绪,因此您可以转换数据集并创建 input_fn 函数。
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
下一步,你将训练逻辑回归。它将为你提供基准准确度。目标是使用不同的算法(即核分类器)超越基准。
步骤4)构建逻辑模型:基线模型
使用对象 real_valued_column 构建特征列。它将确保所有变量都是密集的数字数据。
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
估计器是使用 TensorFlow Estimator API 定义的;您需要提供特征列以及图的保存位置。
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
您将使用大小为 200 的小批量来训练逻辑回归。
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
你可以用 1,000 次迭代来训练模型。
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
步骤5)评估模型
您需要定义 NumPy 输入函数来评估模型。评估过程中,您需要使用整个测试集。
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
你的准确率达到了 82%。在下一节中,你将尝试用核分类器来超越逻辑分类器。
步骤6)构建核分类器
核估计器与传统的线性分类器并没有太大区别,至少在构造方面是如此。其背后的思想是结合显式核映射的强大功能。ping 使用线性分类器。
您需要 TensorFlow 中两个预定义的估计器来训练核分类器:
- 随机傅里叶特征映射器
- 核线性分类器
你在第一节中学到,需要使用核函数将低维数据变换到高维数据。更准确地说,你将使用随机傅里叶特征来近似高斯函数。TensorFlow 1.x 提供了这种映射。ping 作为 RandomFourierFeatureMapper,该模型可以使用估计器 KernelLinearClassifier 进行训练。
要构建模型,您需要遵循以下步骤:
- 设置高维核函数
- 设置 L2 超参数
- 建立模型
- 训练模型
- 评估模型
步骤 A)设置高维核函数
当前数据集包含 14 个特征,你需要将它们转换为一个新的 5,000 维向量。你将使用随机傅里叶特征来实现这种转换。如果你还记得高斯核公式,你会注意到其中有一个标准差参数需要定义。该参数控制分类过程中使用的相似性度量:较小的标准差会使核函数仅将非常接近的点视为相似点,而较大的标准差则会平滑决策边界。
您可以使用以下方法调整 RandomFourierFeatureMapper 中的所有参数:
- 输入维度 = 14
- 输出维度 = 5000
- 标准差 = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
您需要使用之前创建的特征列来构建核映射器:feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
步骤 B)设置 L2 超参数
为了防止过拟合,你使用L2正则化器惩罚损失函数。你将L2超参数设置为0.1,学习率设置为5。
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
步骤 C)构建模型
下一步与线性分类类似。您需要使用内置的估计器 KernelLinearClassifier。请注意,您需要添加之前定义的核映射器并更改模型目录。
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
以下弃用警告在 TensorFlow 1.x 中是预期的,因为 kernel_methods 模块是基于较旧的 tf.contrib.learn 估计器构建的。
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
步骤 D)训练模型
现在核分类器已经构建完成,可以开始训练它了。你选择迭代模型 2,000 次。
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
步骤 E)评估模型
最后但同样重要的是,你要评估模型的性能。你应该能够击败逻辑回归。
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
最终准确率达到 84%,比逻辑回归基准模型高出约 1.6 个百分点(0.83975184 对比 0.82353663)。准确率的提升与计算成本之间存在权衡。您需要考虑这种提升是否值得花费更多时间使用更复杂的分类器,以及它是否对您的业务产生显著影响。
