
PyTor迁移学习教程及示例
 编辑团队
什么是迁移学习?
转移学习 是一种利用训练好的模型来解决另一个相关任务的技术。它是一种 机器学习 这种研究方法将解决特定问题过程中获得的知识存储起来,并利用这些知识来解决另一个不同但相关的问题。通过重用先前任务中收集的信息,这种方法提高了效率。
由于从头开始训练一个网络需要大量数据,因此复用其他网络模型的权重是一种常见的做法。为了缩短训练时间,可以采用现有的网络及其权重,并修改最后一层来解决自身问题。这样做的好处是,最后一层只需少量数据集即可进行训练。
在编写任何 Py 代码之前Torch 代码,了解你的问题属于迁移学习的哪一类很有帮助,因为这决定了你需要多少标记数据。
迁移学习的类型
研究文献将这项技术分为三类。具体哪一类适用于你,取决于问题的哪一方被贴上了标签,而不是你使用的框架。
| 类型 | 源域 | Target 域 | 典型用途 |
|---|---|---|---|
| 感应的 | 标签 | 已贴标签,但任务不同 | 将 ImageNet 主干网重新指向双类异形大战铁血战士问题 |
| 转导 | 标签 | 未标记,相同任务,不同数据分布 | 领域自适应,例如将模型从影棚照片迁移到手机照片。 |
| 无监督 | 未标记 | 未标记 | Cluster降维或降维,因为给每条记录贴标签是不切实际的。 |
本教程中构建的示例是归纳式迁移学习。VGG19 模型携带了标注的 ImageNet 知识,然后将其应用于一个它从未见过的标注二分类问题。
特色trac调整与微调
选择预训练网络后,有两种方法可以对其进行调整。区别仅仅在于允许多少层继续学习。
| 方面 | 特色示例tracTION | 微调 |
|---|---|---|
| 训练层 | 只有被替换的分类器 | 分类器加上部分或全部卷积块 |
| 主干上需要 grad | 假 | 对于正在更新的块,此属性成立。 |
| 所需数据 | 规模较小,通常每类只有几百张图片。 | 更大的,通常有数千个 |
| 培训费用 | 最低配置,运行在 CPU 上 | 性能越高,GPU就越值得拥有。 |
| 典型精度 | 当源图像和目标图像相似时效果很好。 | 通常情况下,当两个域不同时效果会更好。 |
以下步骤使用功能示例trac说明:所有 VGG19 参数都被冻结,只有最终的线性层进行学习。切换到微调模式只需进行一些小改动,即在需要更新的模块中将 requires_grad 设置为 True,并降低学习率,这样借用的权重就不会被破坏。
加载数据集
在你开始使用 Py 进行迁移学习之前Tor首先,你需要了解你将要使用的数据集。在这个迁移学习 Py 中Tor例如,你需要从近 700 张图片中对外星人和铁血战士进行分类。这种方法并不需要大量的训练数据。你可以从以下链接下载数据集: Kaggle:异形大战铁血战士.
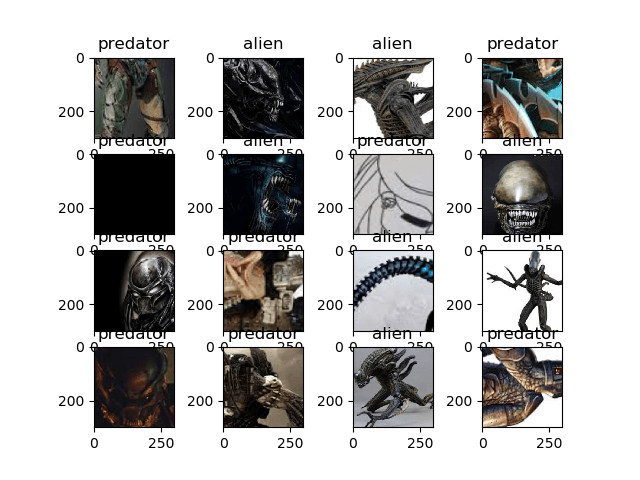
该系列作品数量刻意控制在较小范围内,下面展示其中部分图片。

来源: 异形大战 捕食者 Kaggle
接下来是 PyTor本迁移学习教程将教你如何使用 Py 应用迁移学习。Tor一步一步来。
如何使用迁移学习?
以下是使用 Py 进行深度学习的迁移学习的分步指南。TorCH:
步骤1)加载数据
第一步是加载数据并对图像进行一些转换,使其符合网络的要求。
您将从名为 torchvision.datasets 的文件夹中加载数据。该模块会遍历该文件夹,将数据拆分为训练集和验证集。此处使用的转换流程会裁剪图像中心区域,将其转换为张量,并对其进行归一化处理。 深度学习.
from __future__ import print_function, division
import os
import time
import torch
import torchvision
from torchvision import datasets, models, transforms
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

data_dir = "alien_pred"
input_shape = 224
mean = [0.5, 0.5, 0.5]
std = [0.5, 0.5, 0.5]

#data transformation
data_transforms = {
   'train': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
   'validation': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
}

image_datasets = {
   x: datasets.ImageFolder(
       os.path.join(data_dir, x),
       transform=data_transforms[x]
   )
   for x in ['train', 'validation']
}

dataloaders = {
   x: torch.utils.data.DataLoader(
       image_datasets[x], batch_size=32,
       shuffle=True, num_workers=4
   )
   for x in ['train', 'validation']
}

dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'validation']}

print(dataset_sizes)
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
现在将数据集可视化。可视化步骤从训练数据加载器中获取下一批图像和标签,并使用 Matplotlib 进行显示。
images, labels = next(iter(dataloaders['train']))

rows = 4
columns = 4
fig=plt.figure()
for i in range(16):
   fig.add_subplot(rows, columns, i+1)
   plt.title(class_names[labels[i]])
   img = images[i].numpy().transpose((1, 2, 0))
   img = std * img + mean
   plt.imshow(img)
plt.show()
运行该代码片段会绘制一个 4x4 的训练图片网格,每张图片都以加载器返回的类名作为标题。
步骤2)定义模型
在这个深度学习过程中,您将使用 torchvision 模块中的 VGG19。
您将使用 torchvision.models 加载启用预训练权重的 vgg19 模型。之后,冻结模型层,使其无法训练。然后,将最后一层修改为适合问题的线性层,这里指的是两类问题。损失函数使用 CrossEntropyLoss,优化器使用学习率为 0.001、动量为 0.9 的 SGD,如下面的 Python 代码所示。Torch 迁移学习示例。
## Load the model based on VGG19
vgg_based = torchvision.models.vgg19(pretrained=True)

## freeze the layers
for param in vgg_based.parameters():
   param.requires_grad = False

# Modify the last layer
number_features = vgg_based.classifier[6].in_features
features = list(vgg_based.classifier.children())[:-1] # Remove last layer
features.extend([torch.nn.Linear(number_features, len(class_names))])
vgg_based.classifier = torch.nn.Sequential(*features)

vgg_based = vgg_based.to(device)

print(vgg_based)

criterion = torch.nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(vgg_based.parameters(), lr=0.001, momentum=0.9)
版本说明: 这个 预训练=True 该论点仍然有效,但自 torchvision 0.13 版本以来已被取代。 权重 因此,较新的安装程序会要求提供此参数。 torchvision.models.vgg19(weights=VGG19_Weights.DEFAULT) 否则,将打印弃用警告。两种形式加载相同的 ImageNet 权重。
输出模型结构
打印模型会返回完整的 VGG19 图。阅读分类器代码块的最后一行,确认交换是否成功:现在它生成 2 个输出,而不是之前的 1,000 个 ImageNet 类别。
VGG(
  (features): Sequential(
	(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(1): ReLU(inplace)
	(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(3): ReLU(inplace)
	(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(6): ReLU(inplace)
	(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(8): ReLU(inplace)
	(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(11): ReLU(inplace)
	(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(13): ReLU(inplace)
	(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(15): ReLU(inplace)
	(16): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(17): ReLU(inplace)
	(18): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(19): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(20): ReLU(inplace)
	(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(22): ReLU(inplace)
	(23): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(24): ReLU(inplace)
	(25): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(26): ReLU(inplace)
	(27): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(29): ReLU(inplace)
	(30): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(31): ReLU(inplace)
	(32): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(33): ReLU(inplace)
	(34): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(35): ReLU(inplace)
	(36): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
	(0): Linear(in_features=25088, out_features=4096, bias=True)
	(1): ReLU(inplace)
	(2): Dropout(p=0.5)
	(3): Linear(in_features=4096, out_features=4096, bias=True)
	(4): ReLU(inplace)
	(5): Dropout(p=0.5)
	(6): Linear(in_features=4096, out_features=2, bias=True)
  )
)
步骤3)训练和测试模型
我们将使用其中的一些函数。 PyTorch 教程 帮助我们训练和评估我们的模型。
def train_model(model, criterion, optimizer, num_epochs=25):
   since = time.time()

   for epoch in range(num_epochs):
       print('Epoch {}/{}'.format(epoch, num_epochs - 1))
       print('-' * 10)

       #set model to trainable
       # model.train()

       train_loss = 0

       # Iterate over data.
       for i, data in enumerate(dataloaders['train']):
           inputs , labels = data
           inputs = inputs.to(device)
           labels = labels.to(device)

           optimizer.zero_grad()

           with torch.set_grad_enabled(True):
               outputs  = model(inputs)
               loss = criterion(outputs, labels)

           loss.backward()
           optimizer.step()

           train_loss += loss.item() * inputs.size(0)

           print('{} Loss: {:.4f}'.format(
               'train', train_loss / dataset_sizes['train']))

   time_elapsed = time.time() - since
   print('Training complete in {:.0f}m {:.0f}s'.format(
       time_elapsed // 60, time_elapsed % 60))

   return model

def visualize_model(model, num_images=6):
   was_training = model.training
   model.eval()
   images_so_far = 0
   fig = plt.figure()

   with torch.no_grad():
       for i, (inputs, labels) in enumerate(dataloaders['validation']):
           inputs = inputs.to(device)
           labels = labels.to(device)

           outputs = model(inputs)
           _, preds = torch.max(outputs, 1)

           for j in range(inputs.size()[0]):
               images_so_far += 1
               ax = plt.subplot(num_images//2, 2, images_so_far)
               ax.axis('off')
               ax.set_title('predicted: {} truth: {}'.format(class_names[preds[j]], class_names[labels[j]]))
               img = inputs.cpu().data[j].numpy().transpose((1, 2, 0))
               img = std * img + mean
               ax.imshow(img)

               if images_so_far == num_images:
                   model.train(mode=was_training)
                   return
       model.train(mode=was_training)
最后,在 Py 中进行迁移学习Tor例如,训练过程开始时,训练轮数设置为 25,之后评估网络。在每个训练步骤中,模型接收输入并预测输出。预测结果传递给准则以计算损失,反向传播计算梯度,优化器使用自动微分更新权重。
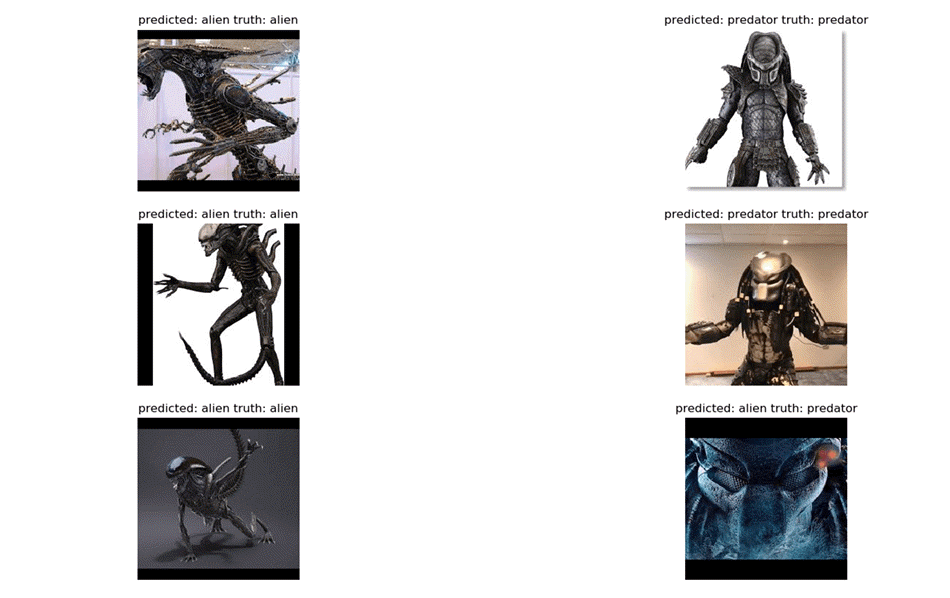
在可视化功能中,使用一批图像对训练好的网络进行测试,以预测标签,并使用 Matplotlib 绘制结果。
vgg_based = train_model(vgg_based, criterion, optimizer_ft, num_epochs=25)

visualize_model(vgg_based)

plt.show()
步骤4)结果
本次运行的准确率为 92%。训练结束时打印的日志显示了最后两个 epoch 的运行损失以及总训练时间。
Epoch 23/24
----------
train Loss: 0.0044
train Loss: 0.0078
train Loss: 0.0141
train Loss: 0.0221
train Loss: 0.0306
train Loss: 0.0336
train Loss: 0.0442
train Loss: 0.0482
train Loss: 0.0557
train Loss: 0.0643
train Loss: 0.0763
train Loss: 0.0779
train Loss: 0.0843
train Loss: 0.0910
train Loss: 0.0990
train Loss: 0.1063
train Loss: 0.1133
train Loss: 0.1220
train Loss: 0.1344
train Loss: 0.1382
train Loss: 0.1429
train Loss: 0.1500
Epoch 24/24
----------
train Loss: 0.0076
train Loss: 0.0115
train Loss: 0.0185
train Loss: 0.0277
train Loss: 0.0345
train Loss: 0.0420
train Loss: 0.0450
train Loss: 0.0490
train Loss: 0.0644
train Loss: 0.0755
train Loss: 0.0813
train Loss: 0.0868
train Loss: 0.0916
train Loss: 0.0980
train Loss: 0.1008
train Loss: 0.1101
train Loss: 0.1176
train Loss: 0.1282
train Loss: 0.1323
train Loss: 0.1397
train Loss: 0.1436
train Loss: 0.1467
Training complete in 2m 47s
然后使用 Matplotlib 将模型的预测结果可视化,如下所示。
常见的迁移学习错误及其解决方法
迁移学习脚本中的大多数错误都是机械性的,而非数学性的。以下列出了导致上述代码无法运行的错误,并解释了每种错误的含义。
- 最后一层尺寸不匹配: 替换后的线性层必须接受原始分类器报告的 in_features,并输出恰好 len(class_names) 个类名。像步骤 2 中那样打印模型是确认这两个数值的最快方法。
- 脊柱从未被冻结: 如果 requires_grad 设置为 True,则 VGG19 的所有参数都会更新,导致 CPU 运行速度极慢。在替换分类器之前,请将其设置为 False。
- 标准化不匹配: transforms.Normalize 中使用的均值和标准差在训练和推理时必须相同,否则预测结果会无缘无故地发生漂移。
- 已弃用的权重参数: 在 torchvision 0.13 及更高版本中,pretrained=True 会引发弃用警告,建议使用 weights 枚举。
- num_workers 在 Windows 以及笔记本: 如果 DataLoader 的 num_workers=4,则需要保护入口点,因此如果 num_workers=4,则应将其设置为 0。 Python 引发生成或序列化错误。
- 在训练模式下进行评估: 在评分之前调用 model.eval(),以便 Dropout 和 BatchNorm 能够确定性地运行,之后再切换回 model.train()。
