
使用 TensorFlow 构建人工神经网络 (ANN) 教程
 编辑团队
⚡ 智能摘要
人工神经网络通过将输入数据逐层传递,使用损失函数对结果进行评分,并通过优化器调整权重来进行学习。本教程将使用 TensorFlow 构建一个人工神经网络,并对 MNIST 数字进行分类。
什么是人工神经网络?
An 人工神经网络 (ANN) 人工神经网络是一种受生物神经网络启发而开发的计算机系统,它基于称为人工神经元的连接单元集合来构建人工大脑。它的设计目标是像人类一样分析和处理信息。人工神经网络具有自学习能力,随着数据的增加,能够产生更好的结果。
下图 trac即对这样的网络进行一次完整的遍历,从原始输入到修正权重的优化器。

人工神经网络 (ANN) 由四个主要对象组成:
- 层数: 所有的学习过程都在各个层中进行。共有三层:1)输入层;2)隐藏层;3)输出层。
- 特色和标签: 网络的输入数据(特征)和网络的输出(标签)
- 损失函数: 用于评估学习阶段绩效的指标
- 优化器: 通过更新网络中的知识来改进学习
神经网络接收输入数据,并将其传递到多个层中。然后,网络使用损失函数评估其性能。损失函数为网络提供掌握知识所需路径的指导。网络借助优化器来改进其知识。
如果你看一下上面的图,你就会明白底层机制。
该程序接收一些输入值,并将它们输入到两个全连接层中。想象一下你遇到一道数学题。你首先会阅读相应的章节来解答它。然后,你将新学到的知识应用到题目中。你很可能得不到理想的分数。神经网络也是如此:它第一次看到数据并进行预测时,结果不会与实际数据完全吻合。
为了提升知识水平,神经网络使用优化器。在这个比喻中,优化器可以理解为重读章节。通过再次阅读,你会获得新的见解。同样地,神经网络使用优化器更新知识,并测试这些新知识,以检查它还需要学习多少。程序会重复这一步骤,直到误差降至最低。
用数学题来类比,就好比你反复阅读课本章节,直到彻底理解课程内容。即使读了很多遍,如果仍然出错,就说明你已经掌握了当前知识的极限。你需要换一本教材或者尝试不同的方法来提高分数。神经网络也是如此。如果误差不再下降,损失曲线趋于平缓,说明当前的网络架构已经无法学习任何新内容。必须对网络进行更好的优化,才能提升其学习能力。
这四个对象直接对应于您在设计网络时配置的组件。
神经网络 Archi质地
人工神经网络架构由以下组件构成:
- 层
- 激活功能
- 损失函数
- 优化
层
每一层都是学习发生的地方。每一层都包含任意数量的神经元,每个神经元都有自己的权重。典型的神经网络通常由密集连接层(也称为全连接层)构成。这意味着所有输入都与输出相连。
典型的神经网络接收一个输入向量和一个包含标签的标量。最简单的设置是二元分类,只有两个类别:0 和 1。
该网络接收输入,将其发送到所有连接的节点,并使用激活函数计算信号。下图放大了单个节点,以便您可以分别查看加权和以及激活步骤。

上图展示了这一概念。第一层存储输入值。第二层,称为隐藏层,接收来自前一层的加权输入。
- 第一个节点是输入值。
- 神经元被分解为输入部分和激活函数。左侧部分接收来自上一层的所有输入。右侧部分是输入经过激活函数处理后的总和。
- 输出值由隐藏层计算得出,用于进行预测。对于分类问题,输出值等于类别数。对于回归问题,仅预测一个值。
激活功能
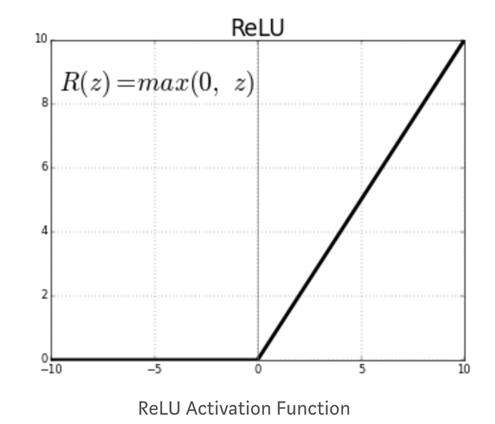
节点的激活函数定义了给定一组输入时的输出。你需要一个激活函数,使网络能够学习非线性模式。ReLU(修正线性单元)是一种常用的激活函数。该函数对所有负值都返回零。
其他激活函数包括:
- 分段线性
- 乙状结肠
- 谭
- 泄漏ReLU
下图显示了为什么 ReLU 是这样描述的:对于每个负输入,曲线在零点处是平坦的,之后呈线性上升。
构建神经网络时要做出的关键决定是:
- 神经网络有多少层
- 每层有多少个隐藏单元
具有很多层和隐藏单元的神经网络可以学习数据的复杂表示,但这会使网络的计算成本非常高。
损失函数
定义隐藏层和激活函数后,需要指定损失函数和优化器。
对于二元分类问题,通常的做法是使用二元交叉熵损失函数。 线性回归您可以使用均方误差。
损失函数是评估优化器性能的重要指标。在训练过程中,该指标将被最小化。您需要根据所处理的问题类型仔细选择此数量。
优化
损失函数是衡量模型性能的指标。优化器通过调整网络权重来降低损失。虽然有多种优化器可供选择,但最常用的是随机梯度下降法。
常规的优化器有:
- Momentum 优化
- 内斯特罗夫加速梯度
- 阿达格勒
- Adam 优化
Archi单凭结构并不能保证模型可用。
神经网络的局限性
以下是神经网络的局限性:
过度拟合
复杂神经网络的一个常见问题是难以泛化到未见过的数据。权重较多的神经网络可以很好地识别训练集中的特定细节,但这往往会导致过拟合。如果数据在组内不平衡(即某些组的数据量不足),网络在训练过程中虽然学习效果很好,但却无法将这些模式泛化到从未见过的数据中。
这其中存在权衡取舍 机器学习 介于优化和泛化之间。
- 优化模型需要找到能够最大限度减少训练集损失的最佳参数。
- 然而,泛化表明模型对于看不见的数据如何表现。
为了防止模型捕捉到训练数据中的特定细节或不必要的模式,可以使用不同的技术。最佳方法是使用数据量充足且均衡的数据集。减少过拟合的技术称为正则化。以下三种技术是传统的入门方法。
| 技术 | 它限制了什么 | 本教程中的典型设置 |
|---|---|---|
| 网络规模 | 层数和隐藏单元数 | 两层隐藏层,分别为 300 和 100 个单位 |
| L1/L2权重正则化 | 权重系数的大小 | l1_regularization_strength 和 l2_regularization_strength 均为 0.01 |
| 退出 | 每个训练步骤中关闭的单元比例 | 掉线率为0.3 |
网络规模
层数过多、隐藏单元过多的神经网络通常非常复杂。降低模型复杂度的一个直接方法是减小模型规模。至于层数,并没有统一的最佳实践。你需要从少量层数开始,逐步增加层数,直到发现模型过拟合为止。
权重正则化
防止过拟合的常用方法是对网络权重添加约束。这种约束迫使网络权重只能取较小的值。该约束被添加到误差损失函数中。正则化有两种类型:
- L1(套索): 成本与权重系数的绝对值成正比。
- L2(山脊): 成本与权重系数的平方成正比。
退出
Dropout 是一种奇特但实用的技术。使用 Dropout 的网络意味着在训练过程中,一些单元会被随机关闭,使其输出信号变为零。假设你有一个权重数组 [0.1, 1.7, 0.7, -0.9]。如果神经网络使用了 Dropout,它将变为 [0.1, 0, 0, -0.9],其中 0 随机分布。控制 Dropout 的参数是 Dropout 率。该率决定了有多少单元会被关闭。通常 Dropout 率介于 0.2 和 0.5 之间。
一个简单的交互式示例使训练循环更容易观察。
TensorFlow 中的神经网络示例
以下是一个人工神经网络的实际应用示例,展示了神经网络如何处理典型的分类问题。有两个输入 x1 和 x2,每个输入都有一个随机值。输出是一个二元类别。目标是根据这两个特征对标签进行分类。为了完成这项任务,神经网络架构定义如下:
- 两个隐藏层
- 第一层有四个完全连接的神经元
- 第二层有两个完全连接的神经元
- 激活函数为 ReLU。
- 添加学习率为 2 的 L0.003 正则化
该网络将以 10 的批次大小,经过 180 个 epoch 的迭代来优化权重。在下面的 ANN 示例动画中,您可以看到权重如何随时间演变,以及网络如何改进分类图。ping.

首先,网络为所有权重分配随机值。
- 使用随机权重(即不进行优化)时,输出损失为 0.453。下图用不同颜色表示该网络。
- 一般来说,橙色代表负值,而蓝色代表正值。
- 数据点具有相同的表示方法:蓝色代表正标签,橙色代表负标签。

在第二层隐藏层中,线条的颜色根据权重的正负而变化。橙色线条代表负权重,蓝色线条代表正权重。
如您所见,在输出图中ping该网络出现了相当多的错误。现在来看看优化后网络的表现。
下图展示了人工神经网络 (ANN) 示例优化后的结果。首先,您可以看到网络已成功学习了如何对数据点进行分类。与之前的图片相比,初始权重为 -0.43,而优化后权重为 -0.95。

这个想法可以推广到具有更多隐藏层和神经元的网络。您可以自行尝试不同的设置。 TensorFlow 游乐场.
下面的步骤演示如何用代码针对真实数据集实现相同的概念。
如何使用 TensorFlow 训练神经网络
以下是训练神经网络的详细步骤。 TensorFlow 使用 API 的估计器 DNNClassifier 的 ANN。
我们将使用 MNIST 数据集来训练你的第一个神经网络。使用 TensorFlow 其实并不复杂。预处理步骤与之前的教程完全相同。具体操作如下:
- 导入数据
- 转换数据
- 构建张量
- 建立模型
- 训练和评估模型
- 改进模型
版本说明: 本教程中的代码针对的是 TensorFlow 1.x Estimator API。tf-estimator 包的最终版本随 TensorFlow 2.15 发布,而 tf.estimator 已在 TensorFlow 2.16 中移除。要在当前版本上运行这些步骤,要么将 TensorFlow 版本锁定为 2.15,要么使用 tf.keras.layers.Dense 和 model.fit() 重建相同的两层网络。
步骤1)导入数据
首先,您需要导入必要的库。您可以使用以下方法导入 MNIST 数据集。 scikit学习 如下面的 TensorFlow 神经网络示例所示。
MNIST 数据集是测试新技术或算法最常用的数据集。它包含一系列 28×28 像素的图像,每张图像上都手写着 0 到 9 的数字。一组经过弹性失真训练的深度卷积网络将测试误差降低至 0.27%。
import numpy as np
import tensorflow as tf
np.random.seed(1337)
最初的演练是手动下载 MNIST 文件,并将 fetch_mldata 指向该文件夹。
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
API说明: mldata.org 已不再在线,并且 fetch_mldata 已在 scikit-learn 0.22 中移除。在当前安装中,请将上述调用替换为 fetch_openml('mnist_784', version=1),这将下载相同的 70,000 个数字,并公开相同的数据和目标属性。
之后,你分割数据并得到两个数据集的形状。
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
步骤2)转换数据
在上一篇教程中,您学习了如何转换数据以限制异常值的影响。在本神经网络教程中,您将使用最小-最大缩放器来转换数据。公式如下:
(X-min_x)/(max_x - min_x)
scikit-learn 已经提供了一个实现此功能的函数:MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
步骤3)构造张量
您现在已经熟悉了创建的方法。 张量 在TensorFlow中,您可以将训练集转换为数值列。
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
步骤4)建立模型
该神经网络架构包含两个隐藏层,第一层有 300 个单元,第二层有 100 个单元。这些数值并非来自公式,而是经验得出的。您可以调整这些数值,并观察它们如何影响网络的准确率。
要构建模型,您需要使用 DNNClassifier 估计器。由于训练集中有十个类别,因此您需要将类别数设置为 10。您应该已经熟悉估计器对象的语法。参数 feature_columns、n_classes 和 model_dir 与之前的教程完全相同。参数 hidden_units 是新增的:它控制神经网络的层数以及每层连接的节点数。在下面的代码中,有两个隐藏层,第一个隐藏层连接 300 个节点,第二个隐藏层连接 100 个节点。
要构建估计器,请使用具有以下参数的 tf.estimator.DNNClassifier:
- 特征列: 定义网络中使用的列。
- hidden_units: 确定隐藏神经元的数量
- n_classes: 确定要预测的类别数量
- model_dir: 定义路径 张量板
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
步骤5)训练并评估模型
您可以使用 NumPy 输入函数来训练和评估模型。
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
输出:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
当前架构在评估集上的准确率约为 96%。
步骤6)改进模型
您可以尝试通过添加正则化参数来改进模型。
这里,估计器使用了一个近端 AdaGrad 优化器,dropout 率为 0.3,L1 和 L2 强度均设置为 0.01。在 TensorFlow 神经网络中,可以通过 train 对象加上优化器名称来访问优化器。TensorFlow 为近端 AdaGrad 优化器提供了一个内置 API。
要为深度神经网络添加正则化,可以使用 tf.train.ProximalAdagradOptimizer 并配合以下参数:
- 学习率: 学习率
- L1正则化: l1正则化强度
- L2正则化: l2正则化强度
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
输出:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
为了减少过拟合而选择的参数值并没有提高模型准确率。你的第一个模型准确率为 96%,而使用 L2 正则化器的模型准确率为 95%。你可以尝试不同的参数值,看看它们对准确率的影响。
