
SAP ХАНА ArchiТектура: Огляд бази даних
 Мейсон Гарсія
⚡ Розумний підсумок
SAP ХАНА ArchiТекстура, ландшафт та розмір формують основу платформи даних у пам'яті, побудованої на SUSE Linux та C++У цій статті пояснюється індексний сервер, механізми сховищ, сховища рядків і стовпців, дельта-злиття та методи визначення розміру обладнання.
Що таке SAP База даних HANA?
SAP HANA — це платформа керування даними, орієнтована на основну пам'ять. База даних працює на SUSE Linux Enterprise Server (SLES) та Red Hat Enterprise Linux (RHEL) та написано мовою C++Він може масштабуватися на кількох машинах для дуже великих робочих навантажень.
Основні переваги SAP ХАНА:
- Надзвичайно швидка продуктивність запитів, оскільки всі дані завантажуються в пам'ять, що усуває повільний дисковий ввід/вивід із критичного шляху.
- Змішане використання OLAP (онлайн-аналітичної обробки) та OLTP (онлайн-обробки транзакцій) в одній базі даних, що спрощує ландшафт даних.
SAP База даних HANA побудована з набору вбудованих механізмів обробки даних. Основним з них є обчислювальний механізм, який взаємодіє з іншими механізмами, такими як реляційний механізм (сховище рядків і стовпців), механізм OLAP, текстовий механізм і механізм обробки графів. Реляційна таблиця зберігається або в сховищі рядків, або в сховищі стовпців, а додаткові механізми обробляють текстові та графічні дані, поки доступна пам'ять.
SAP ХАНА Archiтектура
Дані у сховищі стовпців стискаються за допомогою таких методів, як словникове кодування, кодування довжини рядка, розріджене кодування, кластерне кодування та непряме кодування. Коли досягнуто ліміту основної пам'яті, об'єкти бази даних, які не використовуються (таблиці, представлення тощо), автоматично вивантажуються на диск і перезавантажуються за повторного запиту.
Адміністратори також можуть завантажувати або вивантажувати окрему таблицю вручну, клацнувши правою кнопкою миші на таблиці в SAP Студія HANA і вибір Вивантажити or Навантаження.
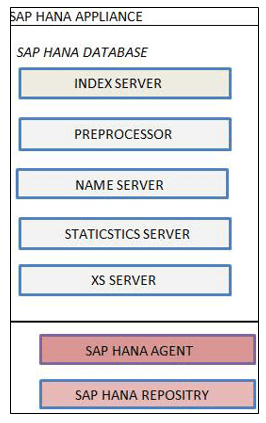
SAP Сервер HANA складається з:
- Сервер індексування
- Сервер препроцесора
- Name Server
- Сервер статистики
- Двигун XS
1. SAP Сервер індексування HANA
Індексний сервер є основним SAP Компонент бази даних HANA:
- Це серце SAP Механізм баз даних HANA.
- Він містить фактичні сховища даних та механізми, які обробляють ці дані.
- Він виконує вхідні SQL- та MDX-інструкції.
Архітектура індексного сервера показана нижче.

SAP Огляд сервера індексування HANA
- Менеджер сеансів і транзакцій: Компонент Сесія керує підключеннями та сесіями для бази даних. Менеджер транзакцій координує та контролює всі транзакції.
- Процесор SQL і MDX: Процесор SQL надсилає запити до відповідного механізму (SQL / SQL Script / R / Calc Engine). Процесор MDX обробляє багатовимірні запити (наприклад, до аналітичного представлення).
- SQL / SQL Script / R / Calc Engine: Виконує SQL, SQL Script, R та обчислювальні моделі на основі даних.
- Сховище: Зберігає керування версіями для SAP Об'єкти метаданих HANA, такі як представлення атрибутів, аналітичні представлення та збережені процедури.
- Шар стійкості: Забезпечує вбудовану можливість аварійного відновлення шляхом запису точок збереження та журналів на том даних на диску.
2. Сервер препроцесора
Сервер препроцесора використовується аналізом тексту. Вінtracts та готує дані з текстового вмісту, коли викликається функція пошуку.
3. Сервер імен
Сервер імен містить інформацію про весь системний ландшафт. У розподіленому розгортанні він tracks кожен запущений компонент та розташування даних між вузлами, щоб запити можна було направляти на правильний сервер.
4. Сервер статистики
Сервер статистики збирає дані про стан, розподіл ресурсів, споживання та продуктивність для SAP Система HANA. Примітка: у HANA SPS 7 та пізніших версіях вбудована служба статистики працює всередині індексного сервера, а не як окремий процес.
5. XS-сервер
Сервер XS розміщує механізм XS Engine, який дозволяє зовнішнім програмам та розробникам використовувати SAP База даних HANA через HTTP. Сам XS Engine діє як легкий HTTP-сервер, що дозволяє клієнтам на базі браузера та REST безпосередньо взаємодіяти з HANA.
SAP Хана Пейзаж
«HANA» означає Високопродуктивний аналітичний пристрій і постачається як комбінована апаратно-програмна платформа.
- Сучасне обладнання пропонує набагато більше ядер процесора, оперативної пам'яті та пропускної здатності сховища, ніж були розроблені для використання застарілими серверами баз даних.
- SAP HANA використовує це, keeping всі робочі дані в основній пам'яті, що усуває вузьке місце дискового вводу/виводу, яке обмежує традиційні бази даних.
На діаграмі нижче підсумовано SAP Інновації апаратного та програмного забезпечення HANA.

SAP HANA підтримує два реляційні сховища даних: Магазин рядків та Колонний магазин.
Магазин рядків
Сховище рядків поводиться як традиційна база даних (Oracle, SQL Server). Ключова відмінність полягає в тому, що всі рядки знаходяться в основній пам'яті в SAP HANA, тоді як традиційна база даних зберігає їх переважно на диску.
Колонний магазин
Стовпцеве сховище зберігає дані в пам'яті у стовпцевому вигляді. Тут зберігаються таблиці стовпців, і механізм балансує хорошу продуктивність запису з оптимізованою продуктивністю читання. На діаграмі нижче показано дві структури, які досягають цього балансу.

Основне сховище
Основне сховище містить основну частину даних. Для економії пам'яті та пришвидшення пошуку застосовуються такі методи стиснення, як словникове кодування, кластерне кодування, розріджене кодування та кодування по довжині рядка.
- Зміна стиснутих даних безпосередньо в основній пам'яті є дорогою, тому записи не спрямовані на основну пам'ять.
- Натомість кожна зміна записується в окрему область під назвою Delta зберіганняЗчитування може здійснюватися як в основному, так і в дельта-сховищі.
Дані можна завантажувати або вивантажувати вручну за допомогою Завантаження в пам'ять та Вивантажити з пам'яті опції, показані нижче.

Delta зберігання
Delta Сховище оптимізовано для запису та використовує легше стиснення. Усі незафіксовані зміни в таблиці стовпців зберігаються тут. Коли зміни потрібно об'єднати назад в основне сховище, виконайте команду Delta Злиття операція від SAP Студія HANA.

- Дельта-злиття переміщує зміни, зібрані в дельта-сховищі, до основного сховища.
- Після об'єднання новий вміст основного сховища зберігається на диску, а стиснення перераховується.
Як дані переміщуються з Delta до основного сховища

Буфер, організований за рядками, називається L1-Delta розташовується перед кожною таблицею стовпців, тому таблиця стовпців може обробляти високопродуктивні операції запису.
- Користувач виконує UPDATE або INSERT для таблиці.
- Дані спочатку потрапляють у L1-Delta (незафіксовані дані).
- Після фіксації дані переміщуються в стовпцево-орієнтований L2-Delta буфера.
- Коли L2-Delta заповнено або виконується злиття, дані записуються в основне сховище.
Таким чином, сховище у стовпцях оптимізоване як для запису (через дельту L1 та L2), так і для читання (через основну пам'ять). Після обробки дані зберігаються на диску рівнем збереження.
Приклад таблиці на основі рядків:

Одна й та сама логічна таблиця зберігається на диску по-різному залежно від типу сховища. У сховищі рядків рядки записуються послідовно:

У сховищі стовпців значення з одного стовпця зберігаються разом:

Оскільки значення стовпців мають спільний тип даних і часто повторюються, макет стовпців надзвичайно добре стискається — що є головною перевагою сховища стовпців щодо пам'яті.

SAP Розмір HANA
Визначення розміру – це процес визначення апаратних ресурсів – оперативної пам’яті, дискового простору та процесора – необхідних для SAP Система HANA. Пам'ять є найважливішим фактором, процесор — другим, а диск походить від перших двох.
В SAP Під час впровадження HANA вибір правильного розміру сервера для робочого навантаження є одним із найважливіших завдань. Порівняно з традиційною СУБД, визначення розміру HANA відрізняється у трьох аспектах:
- Основна пам'ять: зумовлені метаданими, а також обсягом транзакційних та аналітичних даних, що зберігаються в пам'яті.
- Процесор: оцінюється, а не вимірюється, на основі прогнозованих запитів та моделей навантаження.
- Диск: розмірений для збереження даних та обсягів журналів, а не для даних онлайн-запитів.
Процесор і пам'ять сервера застосунків залишаються незмінними порівняно з попередньою базою даних, оскільки HANA замінює лише рівень бази даних.
SAP пропонує кілька способів розрахунку правильного розміру:
- Визначення розміру за допомогою звіту ABAP (код транзакції) ST03 дані та звіт /SDF/HDB_SIZING).
- Визначення розміру за допомогою скрипта бази даних для систем, що не використовують ABAP.
- Визначення розмірів за допомогою SAP Швидкий розмірник інструмент на SAP Торгова площа послуг.
Коли використовується інструмент Швидкий розмір, вимога відображається у форматі нижче.

