
Підручник з лінійної регресії з TensorFlow [Приклади]
 Евелін Кларк
⚡ Розумний підсумок
Лінійна регресія в TensorFlow моделює зв'язок між числовими ознаками та безперервним цільовим значенням. Цей покроковий посібник навчає предиктор цін на житло в Бостоні трьома окремими способами, використовуючи Pandas, NumPy та власні вхідні конвеєри TensorFlow з оцінювачем LinearRegressor.
Що таке лінійна регресія?
Linear Regression – це підхід у статистиці для моделювання зв'язків між двома змінними. Це моделювання здійснюється між скалярною відповіддю та однією або кількома пояснювальними змінними. Зв'язок з однією пояснювальною змінною називається простою лінійною регресією, а з кількома пояснювальними змінними – множинною лінійною регресією.
TensorFlow надає інструменти для повного контролю над обчисленнями. Це робиться за допомогою API низького рівня. Крім того, TensorFlow оснащено широким набором API для виконання багатьох завдань навчання за допомогою машини алгоритми. Це високорівневий API, і TensorFlow називає їх оцінювачами.
- API низького рівняПобудувати архітектуру та оптимізувати модель з нуля. Це складно для початківця.
- API високого рівняВизначте алгоритм. Він зручний для користувача. TensorFlow надає набір інструментів під назвою оцінювач конструювати, тренувати, оцінювати та робити прогнози.
У цьому підручнику ви будете використовувати тільки оцінювачіОбчислення швидші та легші у реалізації. У першій частині пояснюється, як використовувати оптимізатор градієнтного спуску для навчання лінійної регресії в TensorFlow. У другій частині ви використовуватимете набір даних Boston для прогнозування ціни будинку за допомогою оцінювача TensorFlow.
Як навчити модель лінійної регресії
Перш ніж ми почнемо навчати модель, давайте розглянемо, що насправді являє собою лінійна регресія.
Уявіть, що у вас є дві змінні, x та y, і ваше завдання — передбачити значення y, знаючи значення x. Якщо ви побудуєте графік даних, то побачите позитивний зв'язок між вашою незалежною змінною x та вашою залежною змінною y, як показано на діаграмі розсіювання нижче.

Ви можете помітити, що якщо x=1, то y буде приблизно дорівнювати 6, а якщо x=2, то y буде близько 8.5.
Це не дуже точний метод і схильний до помилок, особливо з набором даних, що містить сотні тисяч точок.
Лінійна регресія обчислюється за допомогою рівняння. Змінна y пояснюється однією або багатьма коваріантами. У вашому прикладі є лише одна залежна змінна. Якщо вам потрібно написати це рівняння, воно буде таким:

З:
 – це зміщення. Тобто, якщо x=0, y=
 вага, пов'язана з x
 – це залишок, або помилка моделі. Він включає те, що модель не може дізнатися з даних
Уявіть, що ви відповідаєте моделі та знаходите наступне рішення для:
- = 3.8
- = 2.78
Ви можете підставити ці числа в рівняння, і воно стане:
y= 3.8 + 2.78x
Тепер у вас є кращий спосіб знаходити значення для y. Тобто, ви можете замінити x будь-яким значенням, щоб передбачити y. На зображенні нижче ми замінили x у рівнянні всіма значеннями з набору даних і побудували графік результату.

Червона лінія представляє підібране значення, тобто значення y для кожного значення x. Вам не потрібно бачити значення x, щоб передбачити y; для кожного x існує значення, яке належить червоній лінії. Ви також можете передбачити для значень x, більших за 2.
Якщо ви хочете розширити лінійну регресію на більше коваріат, ви можете зробити це, додавши більше змінних до моделі. Різниця між традиційним аналізом і лінійною регресією полягає в тому, що лінійна регресія розглядає, як y реагуватиме на кожну змінну x, взяту незалежно.
Розглянемо приклад. Уявіть, що ви хочете передбачити продажі магазину морозива. Набір даних містить різну інформацію, таку як погода (дощова, сонячна, хмарна) та інформацію про клієнтів (зарплата, стать, сімейний стан).
Традиційний аналіз намагатиметься передбачити продаж, скажімо, обчислюючи середнє значення для кожної змінної та намагаючись оцінити продаж для різних сценаріїв. Це призведе до поганих прогнозів та обмежить аналіз обраним сценарієм.
Якщо ви використовуєте лінійну регресію, ви можете написати таке рівняння:
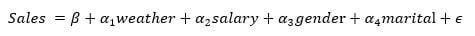
Алгоритм знайде найкраще рішення для ваг; це означає, що він спробує мінімізувати вартість, яка є різницею між підібраною лінією та точками даних.
Як працює алгоритм
На діаграмі нижче підсумовано цикл, який повторює алгоритм: вибір ваг, прогнозування y, вимірювання похибки та корекція ваг.

Алгоритм вибере випадкове число для кожного  та
 і замініть значення x, щоб отримати прогнозоване значення y. Якщо набір даних містить 100 спостережень, алгоритм обчислює 100 прогнозованих значень.
Ми можемо обчислити похибку, зазначив  , моделі, що є різницею між прогнозованим значенням і реальним значенням. Додатна похибка означає, що модель недооцінює прогноз y, а від'ємна похибка означає, що модель переоцінює прогноз y.

Ваша мета — мінімізувати квадрат похибки. Алгоритм обчислює середнє значення квадратичної похибки. Цей крок називається мінімізацією похибки. Для лінійної регресії це Середня квадратична помилка, також називається MSE. Математично це:

де:
 це ваги, отже
 відноситься до прогнозованого значення
- y — справжні значення
- m – кількість спостережень
 відноситься до прогнозованого значення
Зверніть увагу, що  означає, що він використовує транспонування матриць. The
 є математичним записом середнього значення.
Мета — знайти найкращого  що мінімізує MSE.
Якщо середня похибка велика, це означає, що модель працює погано, а ваги вибрано неправильно. Для корекції ваг потрібно використовувати оптимізатор. Традиційний оптимізатор називається Градієнтний спуск.
Градієнтний спуск бере похідну та зменшує або збільшує вагу. Якщо похідна додатна, вага зменшується. Якщо похідна від'ємна, вага збільшується. Модель оновлює ваги та перераховує похибку. Цей процес повторюється, доки похибка більше не змінюється. Кожен прохід називається ітераціяКрім того, градієнти множаться на швидкість навчання, яка вказує на швидкість навчання.
Якщо швидкість навчання занадто мала, алгоритму знадобиться дуже багато часу для збіжності, оскільки це вимагає набагато більше ітерацій. Якщо швидкість навчання занадто висока, алгоритм може ніколи не зійтися. Крива втрат нижче відображає залежність похибки від кількості ітерацій для цього набору даних.

З наведеного вище зображення видно, що модель повторює процес приблизно 20 разів, перш ніж знайти стабільне значення для ваг, таким чином досягаючи найнижчої похибки.
Зверніть увагу, що похибка не дорівнює нулю, а стабілізується навколо 5. Це означає, що модель допускає типову похибку 5. Якщо ви хочете зменшити похибку, вам потрібно додати до моделі більше інформації, наприклад, більше змінних, або використовувати інші оцінки.
Ви пам'ятаєте перше рівняння:

Кінцеві ваги становлять 3.8 та 2.78. У відео нижче показано, як градієнтний спуск оптимізує функцію втрат для знаходження цих ваг.
Як тренувати лінійну регресію за допомогою TensorFlow
Тепер, коли ви краще розумієте, що відбувається за капотом, ви готові використовувати API оцінювача, наданий TensorFlow, щоб навчити свою першу лінійну регресію за допомогою TensorFlow.
Примітка до версії: Наведений нижче робочий процес оцінки був написаний для TensorFlow 1.x та ранніх версій 2.x. TensorFlow позначив tf.estimator та tf.feature_column API повністю застаріли у версії 2.12, а оцінювачі були видалені у версії 2.16. У поточній інсталяції запустіть цей код у TensorFlow 1.15 або 2.x-with-tf.compat.v1 середовище або перенести його до Keras, де tf.keras.layers.Dense(1) плюс шари попередньої обробки замінюють лінійний регресор та стовпці ознак. Концепції — ознаки, мітки, пакети, епохи, MSE та градієнтний спуск — залишаються без змін.
Ви використовуватимете Бостонський набір даних, який містить такі змінні.
| Змінна | Опис |
| крим | Рівень злочинності на душу населення по містах |
| zn | частка житлової землі, зонованої для ділянок понад 25,000 XNUMX кв. |
| інд | частка акрів нероздрібного бізнесу на місто. |
| nox | концентрація оксидів азоту |
| rm | середня кількість кімнат на житло |
| вік | Частка квартир, які займають власники, побудованих до 1940 року |
| відстань | зважені відстані до п’яти центрів зайнятості Бостона |
| податок | ставка податку на повну вартість майна за 10,000 XNUMX доларів США |
| ptratio | Співвідношення учнів/вчителів за містами |
| медв | Середня вартість будинків, які займають власники, у тисячах доларів |
Ви створите три різні набори даних:
| набору даних | мета | формувати |
| Навчання | Тренуйте модель і отримайте ваги | 400, 10 |
| Оцінка | Оцініть продуктивність моделі на невидимих даних | 100, 10 |
| Прогнозуйте | Використовуйте модель для прогнозування вартості будинку на основі нових даних | 6, 10 |
Мета полягає у використанні особливостей набору даних для прогнозування вартості будинку.
У другій частині посібника ви дізнаєтеся, як використовувати TensorFlow трьома різними способами імпорту даних:
- З пандами
- З numpy
- Тільки TensorFlow
Зверніть увагу, що всі три варіанти дають однакові результати.
Ви дізнаєтеся, як використовувати високорівневий API для побудови, навчання та оцінки моделі лінійної регресії TensorFlow. Якби ви використовували низькорівневий API, вам довелося б вручну визначити:
- Функція втрат
- Оптимізатор: градієнтний спуск
- Множення матриць
- Граф і тензор
Це нудно та складніше для початківця.
Рішення Pandas
Вам потрібно імпортувати необхідні бібліотеки для навчання моделі.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Крок 1) Імпортуйте дані за допомогою Панди.
Ви визначаєте назви стовпців та зберігаєте їх у COLUMNS. Ви можете використовувати pd.read_csv() для імпорту даних.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Спрямовуйте кожен виклик на CSV-файли, які ви завантажили раніше.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Ви можете роздрукувати форму даних.
print(training_set.shape, test_set.shape, prediction_set.shape)
Вихід
(400, 10) (100, 10) (6, 10)
Зверніть увагу, що мітка, тобто ваша y, включена до набору даних. Тому вам потрібно визначити два інші списки: один, що містить лише ознаки, а інший – лише назву мітки. Ці два списки підкажуть вашому оцінювачу, які ознаки є в наборі даних і яка назва стовпця є міткою.
Це робиться за допомогою наведеного нижче коду.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Крок 2) Перетворіть дані
Вам потрібно конвертувати числові змінні у відповідний формат. TensorFlow надає метод для конвертації неперервної змінної: tf.feature_column.numeric_column().
На попередньому кроці ви визначили список ознак, які потрібно включити до моделі. Тепер ви можете використовувати цей список для перетворення їх у числові дані. Якщо ви хочете виключити ознаки з вашої моделі, можете видалити одну або кілька змінних зі списку FEATURES, перш ніж створювати feature_cols.
Зверніть увагу, що ви будете використовувати Python Використання спискового розуміння за допомогою списку FEATURES для створення нового списку з назвою feature_cols. Це допоможе вам уникнути дев'ятиразового написання tf.feature_column.numeric_column(). Списокове розуміння — це швидший та зрозуміліший спосіб створення нових списків.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Крок 3) Визначте оцінку
На цьому кроці вам потрібно визначити оцінку. TensorFlow надає шість попередньо створених оцінок, три для завдань класифікації та три для завдань регресії TensorFlow:
- Регресор
- DNNRegressor
- Лінійний регресор
- Лінійний комбінований регресор DNN
- Класифікатор
- DNNClassifier
- Лінійний класифікатор
- Лінійний комбінований класифікатор DNN
У цьому підручнику ви будете використовувати лінійний регресор. Щоб отримати доступ до цієї функції, вам потрібно використовувати tf.estimator.
Для функції потрібні два аргументи:
- feature_columns: містить змінні, які потрібно включити до моделі
- model_dir: шлях для зберігання графа, збереження параметрів моделі тощо
TensorFlow автоматично створить папку з назвою train у вашому робочому каталозі. Вам потрібно використовувати цей шлях для доступу TensorBoard, як показано в прикладі регресії TensorFlow нижче.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
Вихід
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Найскладніша частина TensorFlow полягає у способі завантаження моделі. TensorFlow розроблений для роботи з паралельними обчисленнями та дуже великими наборами даних. Через обмеження ресурсів машини неможливо завантажувати в модель усі дані одночасно. Для цього потрібно щоразу завантажувати пакет даних. Зверніть увагу, що мова йде про величезні набори даних з мільйонами або більше записів. Якщо ви не додасте пакет, ви отримаєте помилку пам'яті.
Наприклад, якщо ваші дані містять 100 спостережень і ви визначаєте розмір пакета 10, це означає, що модель бачитиме 10 спостережень для кожної ітерації (10*10).
Коли модель перегляне всі дані, вона завершує одну епоху. Епоха визначає, скільки разів ви хочете, щоб модель бачила дані. Краще встановити для цього кроку значення «нічого» та дозволити моделі виконати певну кількість ітерацій.
Друга інформація, яку слід додати, це те, чи потрібно перетасовувати дані перед кожною ітерацією. Під час навчання важливо перетасовувати дані, щоб модель не вивчила певний шаблон набору даних. Якщо модель вивчить деталі основного шаблону даних, їй буде важко узагальнити прогноз для невидимих даних. Це називається перенавчанням. Модель добре працює на навчальних даних, але не може правильно передбачити для невидимих даних.
TensorFlow спрощує виконання цих двох кроків. Коли дані надходять до конвеєра, він знає, скільки спостережень йому потрібно (пакет) і чи потрібно перетасувати дані.
Щоб вказати TensorFlow, як завантажувати модель, можна використовувати pandas_input_fn. Цьому об'єкту потрібно п'ять параметрів:
- x: дані функції
- y: дані мітки
- розмір_партії: партія. За замовчуванням 128
- num_epoch: кількість епох, за замовчуванням 1
- перетасувати: перетасувати дані чи ні. За замовчуванням, Немає
Вам потрібно багато разів передавати дані моделі, тому ви визначаєте функцію для повторення цього процесу. Назвіть цю функцію get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Звичайним методом оцінки ефективності моделі є:
- Тренуйте модель
- Оцінити модель на іншому наборі даних
- Зробіть прогноз
Оцінювач TensorFlow надає три різні функції для легкого виконання цих трьох кроків.
Крок 4) Тренуйте модель
Ви можете використовувати метод навчання оцінки для підбору моделі. Оцінці навчання потрібен input_fn та певна кількість кроків. Ви можете використовувати функцію, створену вище, для передачі даних моделі. Потім ви даєте моделі ітерацію 1000 разів. Зверніть увагу, що ви не вказуєте кількість епох; ви дозволяєте моделі ітеруватися 1000 разів. Якщо встановити кількість епох на 1, то модель ітеруватиме чотири рази, оскільки в навчальному наборі є 400 записів, а розмір пакета становить 128:
- 128 рядів
- 128 рядів
- 128 рядів
- 16 рядів
Тому простіше встановити кількість епох на нуль та визначити кількість ітерацій, як показано в прикладі класифікації TensorFlow нижче.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
Вихід
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Ви можете перевірити TensorBoard за допомогою такої команди:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Крок 5) Оцініть свою модель
Ви можете оцінити відповідність вашої моделі тестовому набору за допомогою коду нижче:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
Вихід
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Ви можете роздрукувати втрату за допомогою коду нижче:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
Вихід
Loss: 3215.895996
Модель має втрату 3215. Ви можете перевірити зведену статистику, щоб отримати уявлення про те, наскільки велика похибка.
training_set['medv'].describe()
Вихід
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
З наведеної вище зведеної статистики ви знаєте, що середня ціна будинку становить 22 тисячі, з мінімальною ціною 5 тисяч і максимальною 50 тисяч. Оскільки заявлене збиток є середньоквадратичною похибкою, типова похибка у вихідних одиницях приблизно дорівнює квадратному кореню з 32.16, що становить близько 5.7 тисячі доларів.
Крок 6) Зробіть прогноз
Нарешті, ви можете скористатися методом прогнозування TensorFlow для оцінки вартості шести будинків у Бостоні.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Щоб вивести приблизні значення, можна скористатися цим кодом:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Вихід
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Модель прогнозує такі значення:
| будинок | Прогнозування |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Зверніть увагу, що ми не знаємо справжньої вартості цих шести будинків. У навчальному посібнику з глибокого навчання ви спробуєте перевершити лінійну модель.
Рішення NumPy
У цьому розділі пояснюється, як навчати модель, використовуючи оцінювач NumPy для передачі даних. Метод той самий, за винятком того, що ви використовуватимете оцінювач numpy_input_fn.
Зчитати ті самі три CSV-файли, але зберегти лише необроблені масиви NumPy з розширенням .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Крок 1) Імпортуйте дані
Перш за все, вам потрібно розрізнити змінні ознаки з мітки. Вам потрібно зробити це для навчальних даних та даних оцінки. Швидше визначити функцію для розділення даних.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Ви можете використовувати функцію, щоб відокремити мітку від характеристик поїзда та оцінити набори даних.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Вам потрібно виключити останній стовпець набору даних прогнозування, оскільки він містить лише NaN.
x_predict = prediction_set_n[:, :-2]
Підтвердіть форму масиву. Зверніть увагу, що мітка не повинна мати другого виміру, тобто (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
Вихід
(400, 9) (400,) (6, 9)
Ви можете побудувати стовпці ознак наступним чином:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Оцінювач визначається, як і раніше: ви вказуєте стовпці ознак та місце для збереження графіка.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
Вихід
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Ви можете використовувати оцінювач NumPy для передачі даних моделі, а потім для її навчання. Зверніть увагу, що ми заздалегідь визначаємо функцію input_fn для зручності читання.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
Вихід
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Ви повторюєте той самий крок з іншою вхідною функцією для оцінки вашої моделі.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
Вихід
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Зрештою, ви можете обчислити прогноз. Він має бути схожим на результат Pandas.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Вихід
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
Рішення TensorFlow
Останній розділ присвячено чистому TensorFlow рішення. Цей метод трохи складніший за два інших.
Зверніть увагу, що якщо ви використовуєте Jupyter ноутбук, вам потрібно перезавантажити та очистити ядро, щоб запустити цей сеанс.
TensorFlow створив чудовий інструмент для передачі даних у конвеєр. У цьому розділі ви самостійно створите функцію input_fn.
Крок 1) Визначте шлях і формат даних
Спочатку ви оголошуєте дві змінні зі шляхом до CSV-файлів. Зверніть увагу, що у вас є два файли: один для навчального набору, а інший для тестового.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Потім вам потрібно визначити стовпці, які ви хочете використовувати з CSV-файлу. Ми використовуватимемо їх усі. Після цього вам потрібно оголосити тип кожної змінної.
Змінні з плаваючою комою визначаються як [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Крок 2) Визначте функцію input_fn
Функцію можна розбити на три частини:
- Імпортуйте дані
- Створіть ітератор
- Споживайте дані
Нижче наведено загальний код для визначення функції. Код буде пояснено пізніше.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Імпортуйте дані
Для CSV-файлу метод набору даних зчитує рядки за раз. Щоб створити набір даних, потрібно використовувати об'єкт TextLineНабір даних. Ваш набір даних має заголовок, тому вам потрібно використовувати skip(1), щоб пропустити перший рядок. На цьому етапі ви лише зчитуєте дані та виключаєте заголовок з конвеєра. Щоб завантажувати модель, вам потрібно відокремити ознаки від мітки. Метод, який використовується для застосування будь-якого перетворення до даних, - це map.
Цей метод викликає функцію, яку ви створите, щоб вказати, як перетворити дані. Коротко кажучи, вам потрібно передати дані в TextLineОб'єкт набору даних, виключити заголовок та застосувати перетворення, яке надається функцією.
Code пояснення
- tf.data.TextLineНабір_даних(файл_даних): цей рядок зчитує файл CSV
- .skip(1): пропускає заголовок
- .map(parse_csv)): розбирає записи в тензори
Вам потрібно визначити функцію для передачі інструкцій об'єкту карти. Ви можете викликати цю функцію parse_csv.
Ця функція аналізує CSV-файл за допомогою методу tf.decode_csv та оголошує ознаки й мітку. Ознаки можна оголосити як словник або кортеж. Ви використовуєте метод словника, оскільки він зручніший.
Code пояснення
- tf.decode_csv(value, record_defaults= RECORDS_ALL): метод decode_csv використовує вихідні дані TextLineНабір даних для зчитування CSV-файлу. record_defaults вказує TensorFlow на типи стовпців. У TensorFlow 2.x цей символ знаходиться у tf.io.decode_csv.
- dict(zip(COLUMNS, columns)): заповнює словник усіма стовпцями extracпід час обробки цих даних
- features.pop('medv'): виключає цільову змінну зі змінних feature та створює змінну label
Набору даних потрібні додаткові елементи для ітеративного живлення тензорів. Дійсно, вам потрібно додати метод repeat, щоб набір даних міг необмежено довго живлення моделі. Якщо ви не додасте цей метод, модель виконає ітерацію лише один раз, а потім викличе помилку, оскільки в конвеєр більше не надходять дані.
Після цього ви можете контролювати розмір пакета за допомогою методу batch. Це означає, що ви повідомляєте набору даних, скільки даних ви хочете передавати в конвеєр для кожної ітерації. Якщо ви встановите великий розмір пакета, модель буде повільною.
Крок 3) Створіть ітератор
Тепер ви готові до другого кроку: створіть ітератор для повернення елементів у наборі даних.
Найпростішим способом створення оператора є метод make_one_shot_iterator.
Після цього ви можете створювати функції та мітки з ітератора.
Крок 4) Споживайте дані
Ви можете перевірити, що відбувається з функцією input_fn. Вам потрібно викликати функцію в сеансі, щоб використовувати дані. Ви намагаєтеся з розміром пакета, що дорівнює 1.
Зверніть увагу, що він друкує ознаки зі словника та мітку як масив.
Він покаже перший рядок CSV-файлу. Ви можете спробувати запустити цей код багато разів з різними розмірами пакетів.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
Вихід
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Крок 5) Визначте стовпець ознак
Вам потрібно визначити числові стовпці наступним чином:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Зверніть увагу, що вам потрібно об'єднати всі змінні в одному відрі.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Крок 6) Побудуйте модель
Ви можете навчити модель за допомогою оцінювача LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
Вихід
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Вам потрібно використовувати a лямбда-функція щоб ви могли записати аргументи для функції input_fn. Якщо ви не використовуєте лямбда-функцію, ви не зможете навчити модель.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
Вихід
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Ви можете оцінити відповідність вашої моделі тестовому набору за допомогою коду нижче:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
Вихід
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Останній крок – прогнозування значення цілі на основі значення матриці ознак. Ви можете написати словник зі значеннями, які ви хочете передбачити. Ваша модель має дев'ять ознак, тому вам потрібно надати значення для кожної з них. Модель надасть прогноз для кожної з них.
У наведеному нижче коді ви записуєте значення кожної функції, яка міститься у CSV-файлі df_predict.
Вам потрібно написати нову функцію input_fn, оскільки в наборі даних немає мітки. Ви можете скористатися API from_tensors з об'єкта Dataset.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Зрештою, ви друкуєте прогнози.
for pred in enumerate(pred_results):
print(pred)
Вихід
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Усі три конвеєри повертають однакові шість прогнозів, що підтверджує, що вибір між Pandas, NumPy та власним набором даних TensorFlow є питанням зручності, а не точності.
