
Хеш-таблиця в структурі даних: Python Приклад
 Сара Чен
⚡ Розумний підсумок
Хеш-таблиця в структурах даних зберігає значення як пари ключ-значення, використовуючи хеш-функцію для зіставлення кожного ключа з індексом для швидкого пошуку. У цьому ресурсі пояснюються хеш-функції, колізії, ланцюжки, зондування, операції та... Python приклади, включаючи вбудований словник.
Що таке хешування?
Хеш — це значення фіксованої довжини, яке генерується за допомогою математичної формули. Хеш-значення використовуються для стиснення даних, криптології тощо. В індексації даних хеш-значення використовуються, оскільки вони мають фіксований розмір довжини незалежно від значень, які використовувалися для їх створення. Завдяки цьому хеш-значення займають мінімум місця порівняно з іншими значеннями різної довжини.
Хеш-функція використовує математичний алгоритм для перетворення ключа в хеш. Зіткнення виникає, коли хеш-функція створює те саме значення хеш-функції для кількох ключів.
Що таке хеш-таблиця?
A ХЕШ-ТАБЛИЦЯ це структура даних, яка зберігає значення за допомогою пари ключів і значень. Кожному значенню присвоюється унікальний ключ, який генерується за допомогою хеш-функції.
Ім'я ключа використовується для доступу до пов'язаного з ним значення. Це робить пошук значень у хеш-таблиці дуже швидким, незалежно від кількості елементів у хеш-таблиці.
Хеш-функції
Наприклад, якщо ми хочемо зберігати записи про співробітників, і кожен працівник унікально ідентифікується за допомогою номера працівника.
Ми можемо використовувати номер працівника як ключ і призначити дані працівника як значення.
Вищевказаний підхід потребує додаткового вільного простору порядку (м * н2) де змінна m є розміром масив, а змінна n – кількість цифр для номера працівника. Цей підхід створює проблему місця для зберігання.
Хеш-функція вирішує вищезгадану проблему, отримуючи номер співробітника та використовуючи його для генерації цілочисельного значення хеш-функції, фіксованих цифр та оптимізації місця для зберігання. Мета хеш-функції — створити ключ, який буде використовуватися для посилання на значення, яке ми хочемо зберегти. Функція приймає значення для збереження, а потім використовує алгоритм для обчислення значення ключа.
Нижче наведено приклад простої хеш-функції
h(k) = k1 % m
ТУТ,
- h(k) — хеш-функція, яка приймає параметр k. Параметр k — це значення, для якого ми хочемо обчислити ключ.
- k1 % m — алгоритм нашої хеш-функції, де k1 — значення, яке ми хочемо зберегти, а m — розмір списку. Ми використовуємо оператор модуля для обчислення ключа.
Приклад
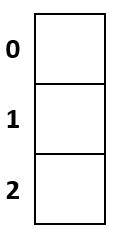
Припустімо, що у нас є список із фіксованим розміром 3 і наступними значеннями
[1,2,3]
Ми можемо використати наведену вище формулу, щоб обчислити позиції, які має займати кожне значення.
На наступному зображенні показано доступні індекси в нашій хеш-таблиці.
Крок 1) Обчисліть позицію, яку буде займати перше значення, таким чином
h(1) = 1 % 3
= 1
Значення 1 займе простір на індекс 1
Крок 2) Обчисліть позицію, яку займе друге значення
h(2) = 2 % 3
= 2
Значення 2 займе простір на індекс 2
Крок 3) Обчисліть позицію, яку займе третє значення.
h(3) = 3 % 3
= 0
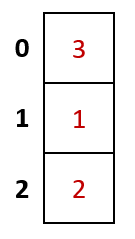
Значення 3 займе простір на індекс 0
Кінцевий результат
Наша заповнена хеш-таблиця тепер буде виглядати наступним чином.
Якості хорошої хеш-функції
Хороша хеш-функція повинна мати такі якості.
- Формула для генерації хешу має використовувати значення даних, які зберігатимуться в алгоритмі.
- Хеш-функція повинна генерувати унікальні хеш-значення навіть для вхідних даних, які мають однакову кількість.
- Функція повинна мінімізувати кількість колізій. Колізії виникають, коли одне й те саме значення генерується для кількох значень.
- Значення мають бути рівномірно розподілені між усіма можливими хешами.
Зіткнення
Колізія виникає, коли алгоритм генерує той самий хеш для кількох значень.
Давайте розглянемо приклад.
Припустимо, що ми маємо наступний список значень
[3,2,9,11,7]
Припустимо, що розмір хеш-таблиці дорівнює 7, і ми використаємо формулу (k1 % m), де m – розмір хеш-таблиці.
У наведеній нижче таблиці показано хеш-значення, які будуть згенеровані.
| ключ | Хеш-алгоритм (k1 % m) | Хеш-значення |
|---|---|---|
| 3 | 3% 7 | 3 |
| 2 | 2% 7 | 2 |
| 9 | 9% 7 | 2 |
| 11 | 11% 7 | 4 |
| 7 | 7% 7 | 0 |
Як ми бачимо з наведених вище результатів, значення 2 і 9 мають однакове хеш-значення, і ми не можемо зберігати більше одного значення в кожній позиції.
Дана проблема може бути вирішена або за допомогою ланцюжків, або зондування. У наступних розділах детально розглядаються ланцюжки та зондування.
Прикування
Зв’язування — це техніка, яка використовується для вирішення проблеми зіткнення за допомогою пов’язаних списків, кожен з яких має унікальні індекси.
На наступному зображенні показано, як виглядає ланцюжковий список
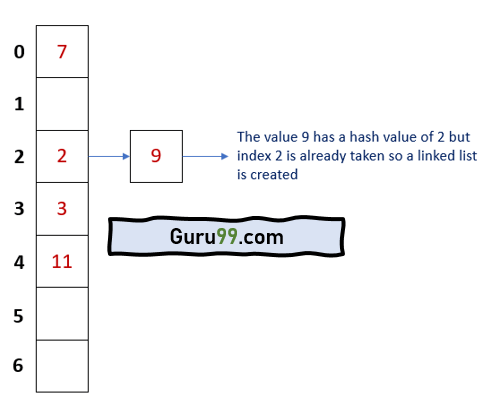
І 2, і 9 займають той самий індекс, але вони зберігаються як пов’язані списки. Кожен список має унікальний ідентифікатор.
Переваги ланцюжкових списків
Нижче наведено переваги ланцюжкових списків:
- Ланцюгові списки мають кращу продуктивність під час вставки даних, оскільки порядок вставки O(1).
- Немає необхідності змінювати розмір хеш-таблиці, яка використовує ланцюжковий список.
- Він може легко вмістити велику кількість цінностей, якщо є вільний простір.
Зондування
Інша техніка, яка використовується для вирішення зіткнень, - зондування. Під час використання методу зондування, якщо відбувається зіткнення, ми можемо просто піти далі та знайти порожній слот для збереження нашого значення.
Методи зондування наступні:
| Метод | Опис |
|---|---|
| Лінійне зондування | Як випливає з назви, цей метод шукає порожні слоти лінійно, починаючи з позиції, де сталося зіткнення, і рухаючись вперед. Якщо кінець списку досягнуто, але вільний слот не знайдено. Зондування починається на початку списку. |
| Квадратичне зондування | Цей метод використовує квадратичні поліноміальні вирази для пошуку наступного вільного місця. |
| Double Хешування | Ця техніка використовує вторинний алгоритм хеш-функції для пошуку наступного вільного доступного слота. |
Використовуючи наведений вище приклад, хеш-таблиця після використання зондування виглядатиме так:

Операції з хеш-таблицею
Ось Operaфункції, які підтримуються хеш-таблицями:
- вставка - це Operation використовується для додавання елемента до хеш-таблиці
- Пошук - це Operation використовується для пошуку елементів у хеш-таблиці за допомогою ключа
- видалення - це Operation використовується для видалення елементів із хеш-таблиці
Операція введення даних
Операція вставки використовується для збереження значень у хеш-таблиці. Коли нове значення зберігається в хеш-таблиці, йому присвоюється номер індексу. Номер індексу обчислюється за допомогою хеш-функції. Хеш-функція вирішує будь-які колізії, які виникають під час обчислення номера індексу.
Операція пошуку даних
Операція пошуку використовується для пошуку значень у хеш-таблиці за допомогою номера індексу. Операція пошуку повертає значення, пов’язане з номером індексу пошуку. Наприклад, якщо ми зберігаємо значення 6 під індексом 2, операція пошуку з індексом номер 2 поверне значення 6.
Операція видалення даних
Операція видалення використовується для видалення значення з хеш-таблиці. Щоб видалити Operaція здійснюється за допомогою номера індексу. Після видалення значення номер індексу стає вільним. Його можна використовувати для зберігання інших значень за допомогою операції вставки.
Реалізація хеш-таблиці з Python Приклад
Давайте розглянемо простий приклад обчислення хеш-значення ключа
def hash_key( key, m):
    return key % m


m = 7

print(f'The hash value for 3 is {hash_key(3,m)}')
print(f'The hash value for 2 is {hash_key(2,m)}')
print(f'The hash value for 9 is {hash_key(9,m)}')
print(f'The hash value for 11 is {hash_key(11,m)}')
print(f'The hash value for 7 is {hash_key(7,m)}')
Хеш-таблиця Code Пояснення
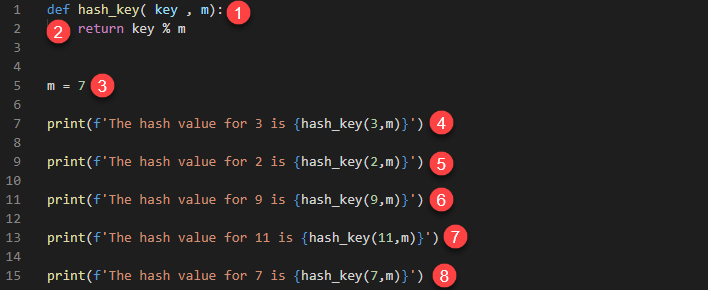
ТУТ,
- Визначає функцію hash_key, яка приймає параметри key і m.
- Використовує просту операцію модуля для визначення хеш-значення
- Визначає змінну m, яка ініціалізується значенням 7. Це розмір нашої хеш-таблиці
- Обчислює та друкує хеш-значення 3
- Обчислює та друкує хеш-значення 2
- Обчислює та друкує хеш-значення 9
- Обчислює та друкує хеш-значення 11
- Обчислює та друкує хеш-значення 7
Виконання наведеного вище коду дає такі результати.
The hash value for 3 is 3
The hash value for 2 is 2
The hash value for 9 is 2
The hash value for 11 is 4
The hash value for 7 is 0
Python Приклад словника
Python поставляється з вбудованим типом даних під назвою Dictionary. Прикладом хеш-таблиці є словник. Він зберігає значення за допомогою пари ключів і значень. Хеш-значення автоматично генеруються для нас, а будь-які зіткнення вирішуються для нас у фоновому режимі.
У наступному прикладі показано, як можна використовувати тип даних словника в пітон 3
employee = {
    'name': 'John Doe',
    'age': 36,
    'position': 'Business Manager.'
}

print (f"The name of the employee is {employee['name']}")
employee['position'] = 'Software Engineer'
print (f"The position of {employee['name']} is {employee['position']}")
employee.clear()

print (employee)
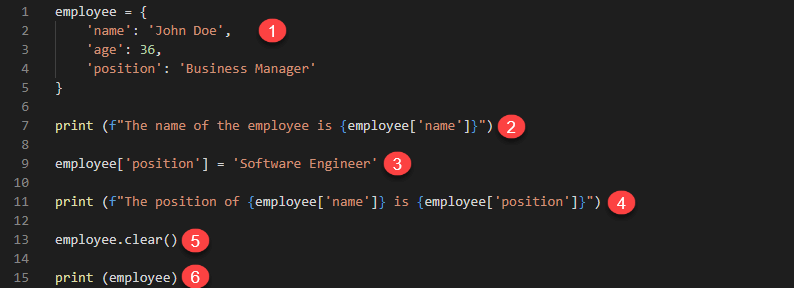
ТУТ,
- Визначає словникову змінну службовця. Ім’я ключа використовується для зберігання значення John Doe, вік – 36, а посада – значення Business Manager.
- Отримує значення імені ключа та друкує його в терміналі
- Оновлює значення ключової позиції до значення Software Engineer
- Друкує значення назви та позиції клавіш
- Видаляє всі значення, які зберігаються в нашому словнику змінної службовця
- Друкує значення працівника
Запуск наведеного вище коду дає такі результати.
The name of the employee is John Doe.
The position of John Doe is a Software Engineer.
{}
Аналіз складності
Хеш-таблиці мають середню часову складність O (1) у найкращому випадку. Найгірша часова складність – O(n). Найгірший сценарій має місце, коли багато значень генерують один і той самий хеш-ключ, і нам доводиться вирішувати колізію шляхом тестування.
Програми реального світу
У реальному світі хеш-таблиці використовуються для зберігання даних
- Бази даних
- Асоціативні масиви
- набори
- Кеш пам'яті
Переваги хеш-таблиць
Ось плюси/переваги використання хеш-таблиць:
- Хеш-таблиці мають високу продуктивність під час пошуку даних, вставки та видалення існуючих значень.
- Часова складність хеш-таблиць є постійною незалежно від кількості елементів у таблиці.
- Вони дуже добре працюють навіть при роботі з великими наборами даних.
Недоліки хеш-таблиць
Ось мінуси використання хеш-таблиць:
- Ви не можете використовувати нульове значення як ключ.
- Зіткнень неможливо уникнути під час генерації ключів за допомогою. хеш-функції. Колізії виникають, коли генерується ключ, який уже використовується.
- Якщо функція хешування має багато колізій, це може призвести до зниження продуктивності.
