
Створіть і вставте INDEX Cassandra
 Редакційна колегія
⚡ Розумний підсумок
Створити та додати індекс Cassandra дає змогу фільтрувати стовпці, які не є частиною первинного ключа. На цій сторінці розглядаються команди CREATE INDEX та DROP INDEX, правила іменування, доступні типи індексів та випадки, коли індекс є неправильною відповіддю.
Cassandra Створити індекс
Команда «Створити індекс» створює індекс на вказаний користувачем стовпець. Якщо дані для стовпця, який потрібно проіндексувати, уже існують, Cassandra створює індекси даних під час виконання оператора «create index».
- Після створення індексу Cassandra автоматично індексує нові дані, коли дані вставляються.
- Індекс не можна створити на первинному ключі, оскільки первинний ключ уже проіндексовано.
- Підтримуються індекси для стовпців колекцій з використанням форми KEYS, VALUES або ENTRIES, залежно від того, що потрібно шукати.
- Без індексації на колонці, Cassandra не можна фільтрувати цей стовпець, якщо він не є первинним ключем.
Ось чому для фільтрації стовпців у Cassandra, індекси потрібно створити.
синтаксис
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Приклад
Ось знімок, на якому намагалися відфільтрувати стовпець «dept» без створення індексу. У відповідь була повернена помилка.

Ось знімок, на якому створено індекс у стовпці dept.

CREATE INDEX DeptIndex ON University.Student (dept);
Ось знімок, на якому буде успішно відфільтровано стовпець «dept».

SELECT * FROM University.Student WHERE dept = 'CS';
Ім'я індексу необов'язкове. Його пропуск дозволяє Cassandra генерувати його автоматично, що важливо, коли індекс пізніше доведеться видалити.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Індекс падіння
Команда «Скинути індекс» видаляє вказаний індекс. Якщо ім’я індексу не вказано під час створення індексу, тоді ім’я індексу буде TableName_ColumnName_idx.
- Якщо індекс не існує, він поверне помилку, якщо не використано IF EXISTS, який поверне no-op.
- Ви повинні вказати назву простору ключів разом з назвою індексу, інакше індекс буде шукатися в поточному просторі ключів.
синтаксис
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Приклад
Ось знімок виконаної команди «Drop index», яка видаляє індекс DeptIndex.
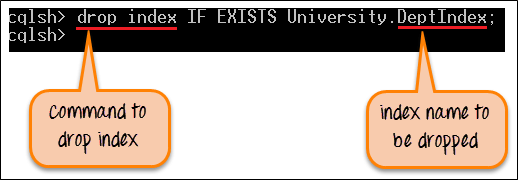
DROP INDEX IF EXISTS University.DeptIndex;
Після успішного виконання команди DeptIndex буде видалено з простору ключів. Тепер дані не можна фільтрувати за стовпцем dept.
Щоб підтвердити, які індекси існують перед видаленнямping по-перше, опишіть таблицю та прочитайте визначення індексу внизу виводу.
DESCRIBE TABLE University.Student;
Типи індексів у Cassandra
Наведена вище команда створює стандартний вторинний індекс, але існують три різні механізми, які поводяться дуже по-різному.
| тип | Як ми можемо допомогти | Найкраще для |
|---|---|---|
| Вторинний індекс | Кожен вузол індексує лише свої локальні дані, тому запит без ключа розділу повинен звертатися до кожного вузла. | Стовпці помірної кардинальності, запитувані разом із ключем розділу. |
| Індекс SASI | Приєднаний індекс, що підтримує зіставлення префіксів та суфіксів LIKE, а також числові діапазони. | Шаблони текстового пошуку. Поки що позначено як експериментальні, тому перевірте перед використанням у виробничій сфері. |
| Індекс прикріпленого сховища (SAI) | Введено в Cassandra 5.0, що дозволяє спільно використовувати одну структуру індексу між стовпцями з меншими накладними витратами на запис. | Сучасна заміна для обох вищезазначених Cassandra 5 кластерів. |
Індексація стовпця колекції використовує модифікатор, який вказує, яку частину індексувати.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
Функція VALUES шукає елементи набору або списку, KEYS шукає ключі мап, а ENTRIES зіставляє пару ключ-значення. Індексування колекцій детальніше розглядається в Cassandra колекції навчальний посібник.
Коли не слід використовувати індекс у Cassandra
Вторинний індекс зручний, але він не є реляційним індексом, і його використання в неправильному місці є поширеною причиною повільних кластерів. Чотири ситуації вимагають іншого підходу.
- Дуже висока кардинальність. Індексація чогось близького до унікального, наприклад, адреси електронної пошти, означає, що майже кожен розділ містить один відповідний рядок, тому запит розходиться по всьому кластеру, щоб повернути один запис.
- Дуже низька кардинальність. Індексація прапорця з двох значень, такого як активний або неактивний, створює величезні розділи індексу, а зчитування одного значення повертає половину таблиці.
- Часто оновлювані колонки. Кожна зміна записує запис індексу та надгробок для старого, тому накопичення надгробків з часом погіршує читання.
- Запити без ключа розділу. Без нього координатор повинен зв'язатися з кожним вузлом та об'єднати результати, що не масштабується при додаванні вузлів.
Довговічною альтернативою є друга таблиця, ключ якої відповідає стовпцю, який потребує пошуку, і яка записується одночасно з першою. Це відповідає принципу «спочатку запит», описаному в Cassandra правила моделі даних, і він зберігає кожне зчитування в одному розділі на одному вузлі.
Як робоче правило, індекс відповідає стовпцю помірної кардинальності, який запитується разом із відомим ключем розділу. Будь-що поза цим описом краще обслуговується спеціально створеною таблицею.
