
Фази компілятора з прикладом, процесом та кроками
 Кайя Серулеан
⚡ Розумний підсумок
Фази компілятора описують, як компілятор перетворює вихідний код на машинний код через шість етапів: лексичний аналіз, синтаксичний аналіз, семантичний аналіз, генерація проміжного коду, оптимізація коду та генерація коду, що підтримується керуванням таблицею символів та обробкою помилок протягом усього процесу.
Які фази проектування компілятора?
компілятор працює в різних фазах, кожна фаза перетворює вихідну програму з одного представлення в інше. Кожна фаза отримує вхідні дані з попередньої стадії та передає її на наступну фазу компілятора.
У компіляторі є 6 фаз. Кожен із цих етапів допомагає перетворити мову високого рівня на машинний код. Фази компілятора:
- Лексичний аналіз
- Синтаксичний аналіз
- Семантичний аналіз
- Генератор проміжного коду
- Code оптимізатор
- Code generator
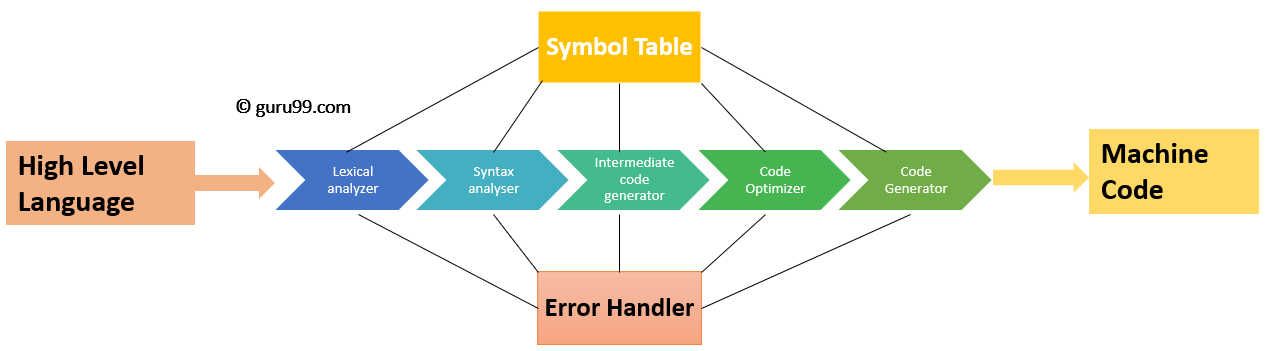
Усі ці фази перетворюють вихідний код шляхом поділу на токени, створення дерев синтаксичного аналізу та оптимізації вихідного коду різними етапами.
Етап 1: лексичний аналіз
Лексичний аналіз - це перша фаза, коли компілятор сканує вихідний код. Цей процес можна виконувати зліва направо, символ за символом, і групувати ці символи в маркери.
Тут потік символів із вихідної програми групується у значущі послідовності за допомогою ідентифікації токенів. Він вносить відповідні квитки в таблицю символів і передає цей маркер до наступної фази.
Основними функціями цієї фази є:
- Визначте лексичні одиниці у вихідному коді
- Класифікуйте лексичні одиниці за такими класами, як константи, зарезервовані слова, і вводьте їх у різні таблиці. Він ігноруватиме коментарі у вихідній програмі
- Визначте лексему, яка не є частиною мови
Приклад:
х = у + 10
Жетони
| X | ідентифікатор |
| = | Оператор призначення |
| Y | ідентифікатор |
| + | Оператор додавання |
| 10 | Номер |
Фаза 2: Синтаксичний аналіз
Аналіз синтаксису — це виявлення структури коду. Він визначає, чи відповідає текст очікуваному формату. Основна мета цього етапу — переконатися, що вихідний код, написаний програмістом, правильний чи ні.
Синтаксичний аналіз базується на правилах, заснованих на конкретній мові програмування, шляхом побудови дерева розбору за допомогою токенів. Він також визначає структуру вихідної мови та граматику чи синтаксис мови.
Ось список завдань, які виконуються на цьому етапі:
- Отримайте лексеми з лексичного аналізатора
- Перевіряє, чи є вираз синтаксично правильним
- Повідомити про всі синтаксичні помилки
- Побудуйте ієрархічну структуру, яка відома як дерево аналізу
Приклад
Будь-який ідентифікатор/число є виразом
Якщо x — ідентифікатор, а y+10 — вираз, то x= y+10 — оператор.
Розглянемо дерево розбору для наступного прикладу
(a+b)*c
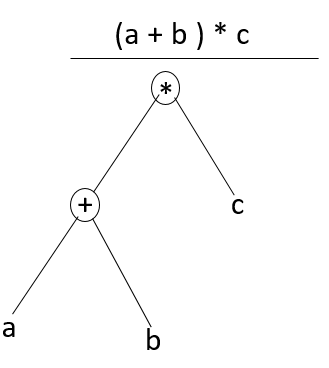
У дереві аналізу
- Внутрішній вузол: запис з операторським файлом і два файли для дітей
- Листок: записи з 2/більше полів; один для токена та інша інформація про токен
- Переконайтеся, що компоненти програми поєднуються один з одним
- Збирає інформацію про тип і перевіряє сумісність типів
- Перевірки операндів дозволені вихідною мовою
Фаза 3: семантичний аналіз
Семантичний аналіз перевіряє семантичну узгодженість коду. Він використовує синтаксичне дерево попередньої фази разом із таблицею символів, щоб перевірити, що заданий вихідний код є семантично узгодженим. Він також перевіряє, чи код передає належне значення.
Semantic Analyzer перевірить типи на невідповідності, несумісні операнди, функцію, викликану з неправильними аргументами, неоголошену змінну тощо.
Функції етапу семантичного аналізу:
- Допомагає зберігати зібрану інформацію про тип і зберігати її в таблиці символів або синтаксичному дереві
- Дозволяє виконувати перевірку типу
- У разі невідповідності типу, коли немає точних правил корекції типу, які задовольняють бажану операцію, відображається семантична помилка
- Збирає інформацію про тип і перевіряє сумісність типів
- Перевіряє, чи вихідна мова дозволяє операнди чи ні
Приклад
float x = 20.2;
float y = x*30;
У наведеному вище коді семантичний аналізатор приведе ціле число 30 до 30.0 з плаваючою точкою перед множенням
Фаза 4: Проміжна Code Покоління
Після завершення фази семантичного аналізу компілятор генерує проміжний код для цільової машини. Він являє собою програму для деяких ABS.tracт машина.
Проміжний код знаходиться між мовою високого рівня та мовою машинного рівня. Цей проміжний код має бути згенерований таким чином, щоб його було легко перевести в цільовий машинний код.
Функції на середньому рівні Code покоління:
- Він має бути згенерований із семантичного представлення вихідної програми
- Зберігає значення, обчислені під час процесу перекладу
- Допомагає вам перекласти проміжний код на цільову мову
- Дозволяє підтримувати пріоритет вихідної мови
- Він містить правильну кількість операндів інструкції
Приклад
Наприклад,
total = count + rate * 5
Проміжним кодом за допомогою методу адресного коду є:
t1 := int_to_float(5)
t2 := rate * t1
t3 := count + t2
total := t3
Фаза 5: Code Оптимізація
Наступним етапом є оптимізація коду або проміжний код. На цьому етапі видаляється непотрібний рядок коду та впорядковується послідовність операторів, щоб прискорити виконання програми без зайвих витрат ресурсів. Основна мета цього етапу — удосконалити проміжний код, щоб створити код, який працює швидше та займає менше місця.
Основними функціями цієї фази є:
- Це допомагає вам знайти компроміс між швидкістю виконання та компіляції
- Покращує час виконання цільової програми
- Генерує спрощений код у проміжному представленні
- Видалення недоступного коду та позбавлення від невикористаних змінних
- Видалення операторів, які не змінюються, із циклу
приклад:
Розглянемо наступний код
a = intofloat(10)
b = c * a
d = e + b
f = d
Може стати
b =c * 10.0
f = e+b
Фаза 6: Code Покоління
Code Генерація – це остання та завершальна фаза компілятора. Вона отримує вхідні дані з фаз оптимізації коду та в результаті створює код сторінки або об'єктний код. Метою цієї фази є виділення пам'яті та генерація переміщуваного машинного коду.
Він також виділяє місця пам’яті для змінної. Інструкції в проміжному коді перетворюються на машинні інструкції. Ця фаза перетворює оптимізований або проміжний код на цільову мову.
Цільовою мовою є машинний код. Таким чином, усі місця пам’яті та регістри також вибираються та розподіляються під час цієї фази. Код, створений цією фазою, виконується для отримання вхідних даних і генерування очікуваних результатів.
Приклад
a = b + 60.0
Можливо, було б переведено на реєстри.
MOVF a, R1
MULF #60.0, R2
ADDF R1, R2
Управління таблицею символів
Таблиця символів містить запис для кожного ідентифікатора з полями для атрибутів ідентифікатора. Цей компонент полегшує компілятору пошук запису ідентифікатора та швидке його отримання. Таблиця символів також допоможе вам керувати обсягом. Таблиця символів і обробник помилок взаємодіють з усіма фазами та відповідно оновлюють таблицю символів.
Процедура обробки помилок
У процесі проектування компілятора помилка може виникнути на всіх наведених нижче етапах:
- Лексичний аналізатор: Неправильно написані лексеми
- Синтаксичний аналізатор: відсутні дужки
- Генератор проміжного коду: невідповідні операнди для оператора
- Code Оптимізатор: Коли оператор недоступний
- Code Generator: Коли пам'ять заповнена або належні регістри не виділені
- Таблиці символів: помилка кількох оголошених ідентифікаторів
Найпоширенішими помилками є недійсна послідовність символів під час сканування, недійсні послідовності токенів у типі, помилка області та синтаксичний аналіз під час семантичного аналізу.
Помилка може виникнути на будь-якій із зазначених вище фаз. Після виявлення помилок на етапі потрібно впоратися з помилками, щоб продовжити процес компіляції. Про ці помилки потрібно повідомити обробнику помилок, який обробляє помилку для виконання процесу компіляції. Як правило, про помилки повідомляється у формі повідомлення.
