
Перетворення агрегатора в Informatica з прикладом
 Девід Картер
⚡ Розумний підсумок
Агрегаторне перетворення в Informatica – це активний об'єкт, який виконує такі обчислення, як сума, середнє значення та підрахунок по групі рядків, зберігаючи ці рядки в агрегатному кеші, доки кожна група не буде завершена.
Що таке трансформація агрегатора?
Агрегаторне перетворення — це активне перетворення, яке виконує агрегатні обчислення, такі як сума, середнє значення та кількість.
Наприклад, якщо ви хочете розрахувати суму зарплат усіх співробітників по відділах, ви можете скористатися перетворенням Агрегатор.
Агреговані операції виконуються над групою рядків, тому для зберігання всіх цих записів і виконання обчислень потрібен тимчасовий заповнювач.
Для цього використовується кеш агрегатора. Це тимчасова основна пам'ять, виділена для перетворення агрегатора для виконання таких операцій, і вона зберігається у двох частинах: кеш індексів зберігає значення груп, а кеш даних зберігає дані рядків, що агрегуються.
Трансформація є активною, оскільки вона змінює кількість рядків у конвеєрі. До нього можуть входити кілька тисяч записів співробітників, а виходити з нього лише один рядок на відділ.
Як використовувати агрегаторне перетворення в Informatica
У цьому прикладі ми розрахуємо суму зарплат відділу. Для цього нам потрібен новий стовпець для зберігання цієї суми. Тож, перш за все, підготуємо нову рубрику.
Крок 1) Створіть нову цільову таблицю бази даних, наприклад, «sum_sal_deptwise», використовуючи наведений нижче скрипт. Ви побачите нову цільову таблицю бази даних, створену в розділі Targetпапку на наступному кроці.
Завантажте наведений вище файл Create_table_sal_deptwise.txt
Крок 2) Створіть новий картаping «m_sum_sal_deptwise» (або «розмір_продажу_в_глибині»).
Щоб створити нову картуping, нам потрібна вихідна таблиця (EMP) та цільова таблиця (sum_sal_deptwise) у Mapping Дизайнер, тому нам потрібно
- Імпортуйте цільову таблицю «sum_sal_deptwise» на картуping.
- Імпортуйте вихідну таблицю «emp».
Обидва визначення тепер відображаються на полотні, як показано нижче.
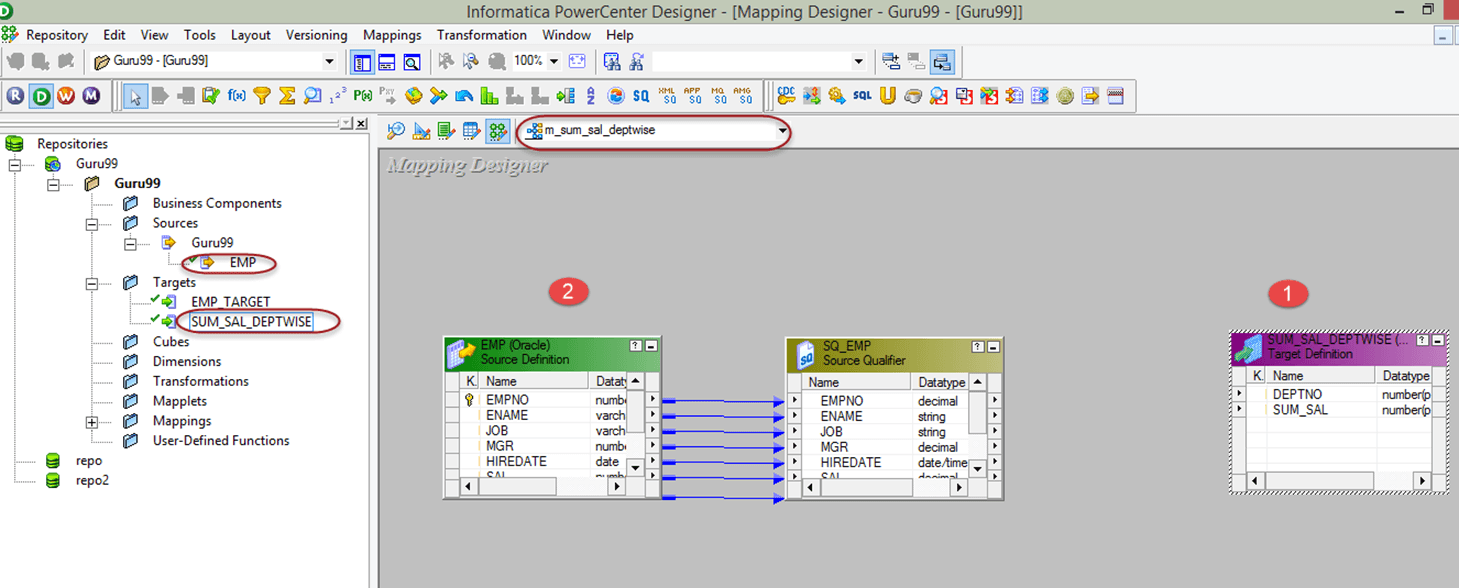
Крок 3) На картіping,
- Від Кваліфікатор джерела, видаліть стовпці empno, ename, job, mgr, hiredate та comm, залишивши лише стовпці deptno та sal.
- Створіть нове перетворення агрегатора за допомогою меню панелі інструментів, як показано на знімку екрана. Після натискання на значок агрегатора буде створено нове перетворення агрегатора.
Новий об'єкт AGGTRANS з'являється поруч із обрізаним кваліфікатором джерела.

Крок 4) Перетягніть стовпці SAL та DEPTNO з кваліфікатора джерела (SQ_EMP) до перетворення агрегатора. Тепер ці два порти пов'язані в AGGTRANS.

Крок 5) Double- клацніть перетворення Агрегатор, щоб відкрити його властивості, а потім
- Додайте новий порт у трансформацію
- Перейменуйте порт на SUM_SAL
- Змініть тип даних цього нового порту на подвійний
- Зробіть цей порт вихідним портом, встановивши прапорець вихідного порту
- Клацніть параметр виразу
На вкладці «Порти» тепер перелічені SAL, DEPTNO та новий вихідний порт SUM_SAL.

Крок 6) У вікні редактора виразів
- Додайте вираз sum(SAL); вам потрібно написати цей вираз самостійно.
- Натисніть кнопку «ОК», це поверне вікно «Редагувати трансформації».
Редактор виразів відображає агрегатний вираз, призначений SUM_SAL.

Крок 7) У вікні «Редагувати трансформації» виберіть опцію «Групувати за», встановивши прапорець навпроти стовпця «номер відділу», і натисніть кнопку «ОК». Вибравши «Групувати за» навпроти стовпця «номер відділу», ми даємо вказівку Informatica групувати зарплати за номером відділу.

Крок 8) Зв'яжіть стовпці deptno та sum_sal з перетворення Aggregator з цільовою таблицею. Картаping потім завершено від джерела до цілі.

Тепер збережіть картуping і виконати його після створення нового Сесія для цієї картиpingЦільова таблиця міститиме суму зарплат за відділами. Таким чином, ми можемо використовувати перетворення Агрегатор для обчислення агрегованих результатів.
Групування за портами в трансформації агрегатора
Наведений вище крок позначив окремий порт як «Групувати за», що перетворило підсумок по всій компанії на один підсумок для кожного відділу. Будь-який вхідний, вхідний/вихідний, вихідний або змінний порт можна позначити таким самим чином.
Три правила керують набором результатів:
- Один ряд на групу. Коли значення групуються, служба інтеграції створює один рядок для кожної унікальної комбінації групи за портами.
- Без групування, один рядок. Якщо порт не позначено, весь вхідний рядок розглядається як одна група, і для всіх вхідних рядків повертається один рядок.
- Останній ряд перемагає. Поряд із агрегованим результатом, служба інтеграції зазвичай передає останній отриманий рядок у групі, якщо функція, така як FIRST, не називає інший рядок.
Якщо позначено кілька портів, порядок портів визначає групуping порядок, і порядок може змінити результат. Групаping від DEPTNO, а потім JOB не те саме, що й grouping за JOB, а потім за DEPTNO, оскільки значення другого стовпця не обов'язково унікальні.
Властивості трансформації агрегатора
Вкладка «Властивості» вікна «Редагувати перетворення» містить налаштування, які визначають, де зберігається кеш і який його обсяг використовується. Вони перелічені в таблиці нижче.
| Установка | Що воно контролює |
|---|---|
| Каталог кешу | Локальний каталог, у якому служба інтеграції створює файли індексу та кешу даних. За замовчуванням використовується змінна процесу $PMCacheDir, встановлена в Workflow Manager. |
| TracРівень | Обсяг деталей, що записуються до журналу сеансу для цього перетворення. |
| Відсортований вхід | Оголошує, що вхідні дані вже відсортовані групою за портами. Виберіть це лише тоді, коли картаping дійсно надає відсортовані дані. |
| Розмір кешу даних агрегатора | Розмір кешу даних. Значення за замовчуванням становить 2 000 000 байт, а параметр «Автоматично» дозволяє службі інтеграції визначити його розмір. |
| Розмір кешу індексу агрегатора | Розмір кешу індексу. Значення за замовчуванням становить 1 000 000 байт, а параметр «Автоматично» дозволяє службі інтеграції визначити його розмір. |
| Обсяг трансформації | Застосовує логіку до кожної транзакції або до всіх вхідних даних. All Input скидає межі вхідних транзакцій. |
Коли ввімкнено інкрементну агрегацію, служба інтеграції записує резервну копію файлів кешу під час кожного запуску, тому каталог кешу має містити два набори файлів, а не один.
Правила агрегатних виразів та поради щодо продуктивності
Агрегований вираз може поєднувати агрегатну функцію з умовними реченнями та неагрегованими функціями, що робить можливими умовні суми та підрахунки в межах одного порту. Два правила обмежують те, що можна записати.
- Один рівень вкладеності. Тільки одна агрегатна функція може бути вкладена всередину іншої, і внутрішній вираз обчислюється першим.
- Без змішування. Трансформація може містити однорівневі функції або вкладені функції, але ніколи обидва варіанти. Якщо вона містить обидва, конструктор позначає картуping недійсний, тому розділіть логіку між двома перетвореннями агрегатора.
Що стосується налаштування, то основну роботу виконують три параметри:
- Відсортований вхід. Коли рядки надходять відсортованим за групами за портами, кожну групу можна звільнити, щойно надходить її останній рядок, таким чином кешується набагато менше даних, і сеанс виконується швидше. Відсортований вхід не можна поєднувати з інкрементальною агрегацією.
- Інкрементальна агрегація. Нові вихідні рядки передаються через картуping та поєднується з історичним кешем замість перерахунку історії, що підходить для щонічного завантаження на поточний підсумок.
- Фільтруйте заздалегідь. Рядки, які ніколи не враховуватимуться в підсумку, слід видаляти перед агрегатором, або в запиті кваліфікатора джерела, або в Трансформація фільтра, оскільки кожен рядок, який досягає агрегатора, витрачає кеш-пам'ять. Це одна зі стандартних перевірок під час налаштування продуктивності.
