
SAP HANA Archi구조: 데이터베이스 개요
 편집 팀
⚡ 스마트 요약
SAP HANA Archi구조, 레이아웃 및 크기 조정은 SUSE Linux 기반의 인메모리 데이터 플랫폼의 토대를 형성합니다. C++이 문서에서는 인덱스 서버, 스토리지 엔진, 행 및 열 저장소, 델타 병합, 하드웨어 크기 조정 방법에 대해 설명합니다.
SAP HANA 데이터베이스?
SAP HANA는 메인 메모리 중심의 데이터 관리 플랫폼입니다. 이 데이터베이스는 SUSE Linux Enterprise Server(SLES)에서 실행됩니다. Red Hat Enterprise Linux (RHEL)로 작성되었으며 다음 언어로 작성되었습니다. C++매우 큰 작업 부하를 처리하기 위해 여러 대의 머신으로 확장할 수 있습니다.
주요 장점 SAP 하나:
- 모든 데이터가 메모리에 로드되므로 디스크 I/O와 같은 느린 작업이 핵심 경로에서 제거되어 쿼리 성능이 매우 빠릅니다.
- 동일한 데이터베이스에서 OLAP(온라인 분석 처리)와 OLTP(온라인 트랜잭션 처리)를 혼합하여 사용함으로써 데이터 환경을 단순화합니다.
SAP HANA 데이터베이스는 메모리 내 처리 엔진 세트로 구성됩니다. 계산 엔진이 핵심 엔진이며, 관계형 엔진(행 및 열 저장소), OLAP 엔진, 텍스트 엔진, 그래프 엔진과 같은 다른 엔진들과 상호 작용합니다. 관계형 테이블은 행 저장소 또는 열 저장소에 저장되며, 추가 엔진들은 사용 가능한 메모리에 따라 텍스트 및 그래프 데이터를 처리합니다.
SAP HANA Archi강의
컬럼 스토어의 데이터는 사전 인코딩, 런 길이 인코딩, 희소 인코딩, 클러스터 인코딩, 간접 인코딩 등의 기술을 사용하여 압축됩니다. 메인 메모리 용량이 한계에 도달하면 사용하지 않는 데이터베이스 객체(테이블, 뷰 등)는 자동으로 디스크로 언로드되고, 다시 요청될 때 재로드됩니다.
관리자는 테이블을 마우스 오른쪽 버튼으로 클릭하여 개별 테이블을 수동으로 로드하거나 언로드할 수도 있습니다. SAP 하나 스튜디오 선택 부리다 or 하중.
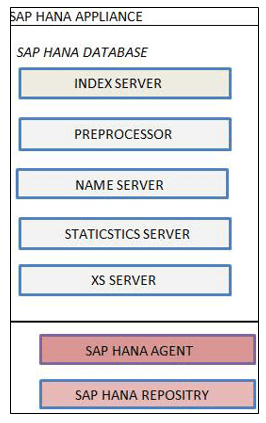
SAP HANA 서버는 다음으로 구성됩니다.
- 인덱스 서버
- 전처리기 서버
- 이름 서버
- 통계 서버
- XS 엔진
1. SAP HANA 인덱스 서버
인덱스 서버는 메인 서버입니다. SAP HANA 데이터베이스 구성 요소:
- 그것은 심장부입니다 SAP HANA 데이터베이스 엔진.
- 여기에는 실제 데이터 저장소와 데이터를 처리하는 엔진이 포함되어 있습니다.
- 이 프로그램은 들어오는 SQL 및 MDX 문을 실행합니다.
아래는 인덱스 서버 아키텍처입니다.

SAP HANA 인덱스 서버 개요
- 세션 및 트랜잭션 관리자: 세션 구성 요소는 데이터베이스 연결 및 세션을 관리합니다. 트랜잭션 관리자는 모든 트랜잭션을 조정하고 제어합니다.
- SQL 및 MDX 프로세서: SQL 프로세서는 적절한 엔진(SQL/SQL 스크립트/R/계산 엔진)으로 쿼리를 보냅니다. MDX 프로세서는 다차원 쿼리(예: 분석 뷰에 대한 쿼리)를 처리합니다.
- SQL/SQL 스크립트/R/계산 엔진: 데이터를 대상으로 SQL, SQL 스크립트, R 및 계산 모델을 실행합니다.
- 저장소: 버전 관리를 유지합니다. SAP HANA 메타데이터 객체에는 속성 뷰, 분석 뷰 및 저장 프로시저 등이 있습니다.
- 지속성 계층: 디스크의 데이터 볼륨에 세이브포인트와 로그를 기록하여 내장된 재해 복구 기능을 제공합니다.
2. 전처리 서버
전처리 서버는 텍스트 분석에서 사용됩니다. 예를 들면 다음과 같습니다.tracts는 검색 기능이 호출될 때 텍스트 콘텐츠에서 데이터를 준비합니다.
3. 네임 서버
네임 서버는 전체 시스템 환경에 대한 정보를 보유합니다. 분산 배포 환경에서는 tracks는 실행 중인 모든 구성 요소와 노드 간 데이터 위치를 파악하여 쿼리를 올바른 서버로 라우팅할 수 있도록 합니다.
4. 통계 서버
통계 서버는 상태, 리소스 할당, 사용량 및 성능 데이터를 수집합니다. SAP HANA 시스템. 참고: HANA SPS 7 이상에서는 내장 통계 서비스가 독립 실행형 프로세스가 아닌 인덱스 서버 내에서 실행됩니다.
5. XS 서버
XS 서버는 XS 엔진을 호스팅하며, 이를 통해 외부 애플리케이션과 개발자가 XS 데이터를 사용할 수 있습니다. SAP HTTP를 통한 HANA 데이터베이스 통신. XS 엔진 자체는 경량 HTTP 서버 역할을 하여 브라우저 기반 클라이언트와 REST 클라이언트가 HANA와 직접 통신할 수 있도록 합니다.
SAP 하나 조경
“HANA”는 다음을 의미합니다. 고성능 분석 기기 하드웨어와 소프트웨어가 결합된 플랫폼으로 제공됩니다.
- 최신 하드웨어는 기존 데이터베이스 서버가 사용하도록 설계된 것보다 훨씬 더 많은 CPU 코어, RAM 및 스토리지 대역폭을 제공합니다.
- SAP HANA는 이를 키(kee)를 통해 활용합니다.ping 모든 작업 데이터가 메인 메모리에 저장되므로 기존 데이터베이스의 한계였던 디스크 I/O 병목 현상이 사라집니다.
아래 그림은 요약을 보여줍니다. SAP HANA 하드웨어 및 소프트웨어 혁신.

SAP HANA는 두 가지 관계형 데이터 저장소를 지원합니다. 행 저장소 컬럼 저장소.
행 저장소
로우 스토어는 기존 데이터베이스처럼 작동합니다.Oracle(SQL Server와 같은 방식). 주요 차이점은 모든 행이 메인 메모리에 저장된다는 점입니다. SAP HANA는 기존 데이터베이스와 달리 데이터를 주로 디스크에 저장합니다.
컬럼 저장소
컬럼 스토어는 메모리에 데이터를 컬럼 형태로 저장합니다. 컬럼 테이블이 저장되며, 엔진은 우수한 쓰기 성능과 최적화된 읽기 성능 사이의 균형을 유지합니다. 아래 다이어그램은 이러한 균형을 달성하는 두 가지 구조를 보여줍니다.

메인 스토리지
메인 스토리지는 대부분의 데이터를 저장합니다. 메모리 사용량을 줄이고 검색 속도를 높이기 위해 사전 인코딩, 클러스터 인코딩, 희소 인코딩, 런 길이 인코딩과 같은 압축 방식이 적용됩니다.
- 메인 스토리지에 저장된 압축 데이터를 직접 수정하는 것은 비용이 많이 들기 때문에 쓰기 작업은 메인 스토리지를 대상으로 하지 않습니다.
- 대신 모든 변경 사항은 별도의 영역에 기록됩니다. Delta 스토리지읽기 작업은 메인 스토리지 또는 델타 스토리지 모두에 접근할 수 있습니다.
데이터는 수동으로 로드하거나 언로드할 수 있습니다. 메모리에 로드 메모리에서 언로드 아래에 옵션이 나와 있습니다.

Delta 스토리지
Delta 이 저장소는 쓰기 작업에 최적화되어 있으며 압축률이 낮습니다. 컬럼 테이블에 대한 커밋되지 않은 모든 변경 사항은 여기에 저장됩니다. 변경 사항을 메인 저장소로 병합해야 하는 경우, 다음 명령을 실행하세요. Delta 병합 에서 작동 SAP 하나 스튜디오.

- 델타 병합은 델타 저장소에 수집된 변경 사항을 메인 저장소로 이동시킵니다.
- 병합 후 새로운 주 저장소 콘텐츠가 디스크에 저장되고 압축률이 다시 계산됩니다.
데이터는 어떻게 이동하나요? Delta 메인 저장소로

행 단위로 구성된 버퍼라고 합니다. L1-Delta 모든 컬럼 테이블 앞에 위치하기 때문에 컬럼 테이블은 높은 처리량의 쓰기 작업을 처리할 수 있습니다.
- 사용자가 해당 테이블에 대해 UPDATE 또는 INSERT 작업을 실행합니다.
- 데이터가 먼저 L1에 도달합니다.Delta (미확정 데이터).
- 데이터가 커밋되면 컬럼 지향형 L2-디렉터리로 이동됩니다.Delta 버퍼.
- L2일 때-Delta 메인 스토리지가 가득 차거나 병합이 실행되면 데이터가 메인 스토리지에 기록됩니다.
따라서 컬럼 스토리지는 쓰기 최적화(L1 및 L2 델타를 통해)와 읽기 최적화(메인 스토리지를 통해)를 모두 제공합니다. 처리가 완료되면 데이터는 영구 저장 계층을 통해 디스크에 저장됩니다.
행 기반 테이블의 예:

동일한 논리 테이블이 저장소 유형에 따라 디스크에 저장되는 방식이 다릅니다. 행 저장소(Row Store)에서는 행이 연속적으로 기록됩니다.

컬럼 스토어에서는 같은 컬럼의 값들이 함께 저장됩니다.

컬럼 값들이 데이터 형식을 공유하고 자주 반복되기 때문에 컬럼 레이아웃은 압축률이 매우 뛰어납니다. 이것이 바로 컬럼 스토어의 주요 메모리 절약 장점입니다.

SAP HANA 사이징
사이징이란 시스템에 필요한 하드웨어 리소스(RAM, 디스크, CPU)를 결정하는 과정입니다. SAP HANA 시스템에서 가장 중요한 요소는 메모리이고, 그다음은 CPU이며, 디스크는 앞의 두 요소에 따라 결정됩니다.
안에 SAP HANA 구현에서 비즈니스 워크로드에 적합한 서버 크기를 선택하는 것은 가장 중요한 작업 중 하나입니다. 기존 DBMS와 비교했을 때 HANA의 서버 크기 조정은 다음 세 가지 영역에서 차이가 있습니다.
- 메인 메모리: 메타데이터와 메모리에 저장된 거래 및 분석 데이터의 양에 따라 좌우됩니다.
- CPU : 측정값이 아닌 추정값이며, 예측된 쿼리 및 부하 패턴을 기반으로 합니다.
- 디스크: 데이터 영속성 및 로그 볼륨을 고려하여 크기가 조정되었으며, 온라인 쿼리 데이터를 위한 크기가 아닙니다.
HANA는 데이터베이스 계층만 대체하기 때문에 애플리케이션 서버의 CPU와 메모리 사용량은 이전 데이터베이스와 비교하여 변경되지 않습니다.
SAP 정확한 크기를 계산하는 여러 가지 방법을 제공합니다.
- ABAP 리포트를 사용한 크기 조정(트랜잭션 코드) ST03 데이터 및 보고서 /SDF/HDB_SIZING).
- ABAP 시스템이 아닌 경우 데이터베이스 스크립트를 사용하여 크기를 조정합니다.
- 사이즈를 사용하여 SAP 퀵 사이저 도구 SAP 서비스 마켓플레이스.
퀵 사이저 도구를 사용하면 요구 사항이 아래와 같은 형식으로 표시됩니다.

