
R을 이용한 다중 선형 회귀 분석: 단순 회귀 및 단계적 회귀 분석 예제
 에블린 클라크
⚡ 스마트 요약
R에서 단순 및 다중 선형 회귀 모델을 사용하여 연속형 결과 변수를 최소 제곱법으로 적합시킨 예측 변수들의 가중 합으로 나타냅니다. 이 가이드에서는 lm() 함수, 계수 읽기, 요인 예측 변수, 잔차 진단, 예측 및 자동 변수 선택에 대해 다룹니다.
머신러닝에서 선형 회귀의 역할
선형 회귀는 가장 오래된 지도 학습 방법 중 하나입니다. 기계 학습 알고리즘은 여전히 대부분의 분석가들이 가장 먼저 찾는 모델입니다. 초기 머신러닝 응용 프로그램 중 하나는 바로 이것이었습니다. 스팸 필터.
머신러닝의 다른 일반적인 응용 분야는 다음과 같습니다.
- 이메일에서 원치 않는 스팸 메시지 식별
- 타겟 광고를 위한 고객 행동 세분화
- 신용카드 사기 거래 감소
- 가정 및 사무용 건물의 에너지 사용 최적화
- 얼굴 인식
지도 학습
In 지도 학습, 알고리즘에 제공하는 훈련 데이터에는 레이블이 포함됩니다.
분류 지도 학습은 아마도 가장 널리 사용되는 기법일 것입니다. 연구자들이 처음으로 다룬 분류 작업 중 하나는 스팸 필터였습니다. 학습의 목표는 이메일이 스팸인지 정상 이메일(ham)인지 예측하는 것입니다. 학습 단계를 거치면 기계는 이메일의 종류를 감지할 수 있게 됩니다.
회귀 머신러닝 분야에서 연속적인 값을 예측하는 데 일반적으로 사용됩니다. 회귀 분석 작업은 특정 값(예: 특정 변수)을 예측할 수 있습니다. 종속 변수 세트를 기반으로 독립 변수 (예측 변수 또는 회귀 변수라고도 함) 예를 들어 선형 회귀는 주가, 일기 예보, 매출 등을 예측할 수 있습니다.
몇 가지 기본적인 지도 학습 알고리즘은 다음과 같습니다.
- 선형 회귀
- 로지스틱 회귀
- 가장 가까운 이웃
- 지원 벡터 머신 (SVM)
- 의사결정 트리와 랜덤 포레스트
- 신경망
비지도 학습
In 비지도 학습, 훈련 데이터는 레이블이 지정되지 않았습니다. 시스템은 참조 없이 학습을 시도합니다. 아래는 비지도 학습 알고리즘 목록입니다.
- K-평균
- 계층 적 Cluster 분석
- 기대 극대화
- 시각화 및 차원 감소
- 주요 구성 요소 분석
- 커널 PCA
- 로컬 선형 임베딩
이러한 배경 지식을 바탕으로, 이 튜토리얼의 나머지 부분에서는 R을 사용하여 회귀 모델을 단계별로 구축합니다.
R의 단순 선형 회귀
선형 회귀 분석은 간단한 질문에 대한 답을 제시합니다. 즉, 하나의 목표 변수와 여러 예측 변수 사이의 정확한 관계를 측정할 수 있는가 하는 것입니다.
가장 간단한 확률 모델은 직선 모델입니다.

어디에
- y = 종속변수
- x = 독립변수
-
 = 무작위 오류 구성 요소
-
 = 가로채기
-
 = x의 계수
다음 플롯을 고려해보세요.
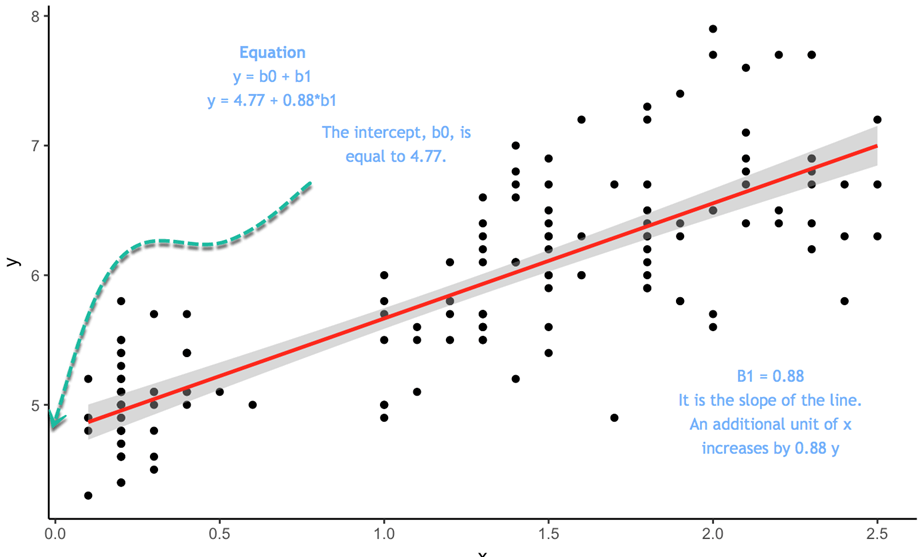
방정식은 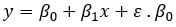 이 방정식에서 절편은 4.77이므로 x가 0일 때 y의 적합값은 4.77입니다. 기울기는 x가 변할 때 y가 어떤 비율로 변하는지를 나타냅니다.
최적의 값을 추정하려면 
 , 당신은 일반 최소 제곱 (OLS). 이 방법은 오차 제곱의 합, 즉 예측된 y값과 실제 y값 사이의 수직 거리를 최소화하는 매개변수를 찾으려고 합니다. 차이점은 다음과 같이 알려져 있습니다. 오차항.
모델을 추정하기 전에 산점도를 그려서 y와 x 사이의 선형 관계가 타당한지 여부를 확인할 수 있습니다.
산포도
단순 선형 회귀의 개념을 설명하기 위해 매우 간단한 데이터 세트를 사용할 것입니다. 미국 여성의 평균 키와 몸무게를 가져옵니다. 데이터 세트에는 15개의 관측치가 포함되어 있습니다. 키가 가중치와 양의 상관관계가 있는지 측정하려고 합니다.
library(ggplot2)
path <- 'https://raw.githubusercontent.com/guru99-edu/R-Programming/master/women.csv'
df <-read.csv(path)
ggplot(df,aes(x=height, y =  weight))+
geom_point()
출력:

산점도는 키가 커질수록 몸무게가 증가하는 일반적인 경향을 보여줍니다. 다음 단계에서는 키가 1단위 증가할 때마다 몸무게가 얼마나 증가하는지 측정할 것입니다.
최소 제곱 추정치
간단한 OLS 회귀에서 다음을 계산합니다.  간단합니다. 이 튜토리얼에서는 공식을 유도하는 것이 아니라, 단지 공식을 제시할 뿐입니다.
추정하려는 항목: 
OLS 회귀의 목적은 다음 방정식을 최소화하는 것입니다.

어디에
 실제 값이고
 예측값입니다.
솔루션 is 
참고  x의 평균값을 의미합니다.
솔루션  is

R에서는 cov() 및 var() 함수를 사용하여 추정할 수 있습니다. 평균() 함수를 사용하여 추정할 수 있습니다. 
beta <- cov(df$height, df$weight) / var (df$height)
beta
출력:
##[1] 3.45
alpha <- mean(df$weight) - beta * mean(df$height)
alpha
출력:
## [1] -87.51667
베타 계수는 키가 1인치 증가할 때마다 평균 몸무게가 3.45파운드 증가한다는 것을 의미합니다.
선형 방정식을 손으로 어림하는 것은 유익하지만 비실용적입니다. R 이 문서에서는 lm() 함수를 제공하여 이러한 작업을 수행하도록 하며, 다음 섹션부터 이 함수를 사용하게 될 것입니다. 실제 프로젝트에서는 단일 예측 변수 모델을 적합시키는 경우는 거의 없으며, 회귀 분석 작업에는 일반적으로 여러 추정 변수가 동시에 사용됩니다.
R의 다중 선형 회귀
회귀 분석의 실제 응용에서는 단순한 직선 모델보다 더 복잡한 모델을 사용합니다. 두 개 이상의 독립 변수를 포함하는 확률 모델을 회귀 모델이라고 합니다. 다중 회귀 모델. 이 모델의 일반적인 형태는 다음과 같습니다.

행렬 표기법으로 모델을 다시 작성할 수 있습니다.

종속변수 y는 이제 k개의 독립변수의 함수입니다. 계수의 값  독립변수의 기여도를 결정합니다.
 .
무작위 오류에 대해 가정한 내용을 간략하게 소개합니다.  OLS 중:
- 평균은 0과 같습니다.
- 다음과 같은 분산

- 정규 분포
- 무작위 오류는 독립적입니다(확률적 의미에서).

당신은 해결해야합니다 , 예측된 y 값과 실제 y 값 사이의 제곱 오차의 합을 최소화하는 회귀 계수의 벡터입니다.
폐쇄형 솔루션은 다음과 같습니다.

와:
- 를 나타냅니다 바꾸어 놓다 행렬 X의
 를 나타냅니다 가역 행렬
 를 나타냅니다 가역 행렬
아래 예제에서는 내장된 mtcars 데이터셋을 사용합니다. 목표는 여러 특징을 이용하여 연비(mpg)를 예측하는 것입니다.
R의 연속변수
지금은 연속 변수만 사용하고 범주형 기능은 제쳐두겠습니다. 변수 am은 변속기가 수동이면 1, 자동이면 0의 값을 취하는 이진 변수입니다. vs도 이진 변수입니다.
library(dplyr)
df <- mtcars %>%
select(-c(am, vs, cyl, gear, carb))
glimpse(df)
출력:
## Observations: 32
## Variables: 6
## $ mpg  <dbl> 21.0, 21.0, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19....
## $ disp <dbl> 160.0, 160.0, 108.0, 258.0, 360.0, 225.0, 360.0, 146.7, 1...
## $ hp   <dbl> 110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, ...
## $ drat <dbl> 3.90, 3.90, 3.85, 3.08, 3.15, 2.76, 3.21, 3.69, 3.92, 3.9...
## $ wt   <dbl> 2.620, 2.875, 2.320, 3.215, 3.440, 3.460, 3.570, 3.190, 3...
## $ qsec <dbl> 16.46, 17.02, 18.61, 19.44, 17.02, 20.22, 15.84, 20.00, 2...
lm() 함수를 사용하여 매개변수를 계산할 수 있습니다. 이 함수의 기본 구문은 다음과 같습니다.
lm(formula, data, subset)
Arguments:
	-formula: The equation you want to estimate
	-data: The dataset used
	-subset: Estimate the model on a subset of the dataset
방정식은 다음과 같은 형태임을 기억하세요.

R에서
- = 기호는 ~로 대체됩니다.
- 각 x는 변수 이름으로 대체됩니다.
- 상수를 삭제하려면 수식 끝에 -1을 추가하세요.
예:
키와 수익을 기준으로 개인의 체중을 추정하려고 합니다. 방정식은 다음과 같습니다

R의 방정식은 다음과 같이 작성됩니다.
y ~ X1+ X2+…+Xn # 절편 있음
예를 들면 다음과 같습니다.
- 무게 ~ 키 + 수익
귀하의 목표는 일련의 변수를 기반으로 갤런당 마일을 추정하는 것입니다. 추정할 방정식은 다음과 같습니다.

첫 번째 선형 회귀를 추정하고 결과를 Fit 객체에 저장합니다.
model <- mpg ~ disp + hp + drat + wt + qsec
fit <- lm(model, df)
fit
Code 설명
- model <- mpg ~ disp + hp + drat + wt + qsec: 추정할 모델을 저장합니다.
- lm(model, df): 데이터 프레임 df를 사용하여 모델을 추정합니다.
##
## Call:
## lm(formula = model, data = df)
##
## Coefficients:
## (Intercept)         disp           hp         drat           wt
##    16.53357      0.00872     -0.02060      2.01577     -4.38546
##        qsec
##     0.64015
출력은 적합도의 질에 대한 충분한 정보를 제공하지 않습니다. summary() 함수를 사용하여 계수의 유의도, 자유도 및 잔차의 모양과 같은 더 자세한 정보에 액세스할 수 있습니다.
summary(fit)
출력:
## return the p-value and coefficient
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5404 -1.6701 -0.4264  1.1320  5.4996
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 16.53357   10.96423   1.508  0.14362
## disp         0.00872    0.01119   0.779  0.44281
## hp          -0.02060    0.01528  -1.348  0.18936
## drat         2.01578    1.30946   1.539  0.13579
## wt          -4.38546    1.24343  -3.527  0.00158 **
## qsec         0.64015    0.45934   1.394  0.17523
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.558 on 26 degrees of freedom
## Multiple R-squared:  0.8489, Adjusted R-squared:  0.8199
## F-statistic: 29.22 on 5 and 26 DF, p-value: 6.892e-10
위 표 출력에서 추론
- 표는 무게와 연비 사이에 강한 음의 상관관계가 있고, drat에 대해서는 양의 상관계수가 있음을 보여줍니다.
- 변수 wt만이 mpg에 통계적 영향을 미칩니다. 통계적으로 가설을 테스트하려면 다음을 사용합니다.
- H0: 통계적 영향 없음
- H1: 예측 변수가 y에 의미 있는 영향을 미칩니다.
- p 값이 0.05보다 낮으면 변수가 통계적으로 유의하다는 것을 나타냅니다.
- 조정된 R제곱: 예측 변수의 개수를 고려하여 모델이 설명하는 y의 분산 비율입니다. 여기서는 0.8199이므로, 모델은 mpg의 분산 중 약 82%를 설명합니다. R제곱은 항상 0에서 1 사이의 값을 가지며, 값이 높을수록 좋습니다.
당신은 분산 분석 anova() 함수를 사용하여 각 특징이 분산에 미치는 효과를 추정하는 테스트를 실시합니다.
anova(fit)
출력:
## Analysis of Variance Table
##
## Response: mpg
##           Df Sum Sq Mean Sq  F value   Pr(>F)
## disp       1 808.89  808.89 123.6185 2.23e-11 ***
## hp         1  33.67   33.67   5.1449 0.031854 *
## drat       1  30.15   30.15   4.6073 0.041340 *
## wt         1  70.51   70.51  10.7754 0.002933 **
## qsec       1  12.71   12.71   1.9422 0.175233
## Residuals 26 170.13    6.54
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
모델 성능을 추정하는 보다 일반적인 방법은 다양한 측정값에 대한 잔차를 표시하는 것입니다.
플롯() 함수를 사용하여 네 개의 그래프를 표시할 수 있습니다.
– 잔차 대 적합치
– 정규 QQ 플롯: 이론적인 사분위수와 표준화된 잔차
– 척도-위치: 적합치 대 표준화 잔차의 제곱근
– 잔차 vs 레버리지: 레버리지 vs 표준화 잔차
plot(fit) 앞에 par(mfrow = c(2, 2)) 코드를 추가하세요. 이 코드를 추가하지 않으면 R에서 다음 그래프를 표시하려면 Enter 키를 누르라는 메시지가 나타납니다.
par(mfrow = c(2, 2))
Code 설명
- (mfrow=c(2,2)): XNUMX개의 그래프가 나란히 있는 창을 반환합니다.
- 처음 2개는 행 수를 추가합니다.
- 두 번째 2는 열 수를 추가합니다.
- (mfrow=c(3,2))라고 쓰면: 3행 2열 창이 생성됩니다.
plot(fit)
출력:

lm() 함수는 유용한 정보가 많이 포함된 리스트를 반환합니다. 생성한 fit 객체 뒤에 $ 기호와 원하는 정보를 입력하여 해당 정보에 접근할 수 있습니다.tract.
– 계수: `fit$coefficients`
– 잔차: `fit$residuals`
– 적합치: `fit$fitted.values`
R의 요인 회귀
마지막 모델 추정에서는 연속 변수에 대해서만 mpg를 회귀합니다. 모델에 요인변수를 추가하는 것은 간단합니다. 모델에 am 변수를 추가합니다. 변수가 연속형이 아닌 요인 수준인지 확인하는 것이 중요합니다.
df <- mtcars %>%
    mutate(cyl = factor(cyl),
        vs = factor(vs),
        am = factor(am),
        gear = factor(gear),
        carb = factor(carb))
model <- mpg ~ .
summary(lm(model, df))
출력:
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5087 -1.3584 -0.0948  0.7745  4.6251
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 23.87913   20.06582   1.190   0.2525
## cyl6        -2.64870    3.04089  -0.871   0.3975
## cyl8        -0.33616    7.15954  -0.047   0.9632
## disp         0.03555    0.03190   1.114   0.2827
## hp          -0.07051    0.03943  -1.788   0.0939 .
## drat         1.18283    2.48348   0.476   0.6407
## wt          -4.52978    2.53875  -1.784   0.0946 .
## qsec         0.36784    0.93540   0.393   0.6997
## vs1          1.93085    2.87126   0.672   0.5115
## am1          1.21212    3.21355   0.377   0.7113
## gear4        1.11435    3.79952   0.293   0.7733
## gear5        2.52840    3.73636   0.677   0.5089
## carb2       -0.97935    2.31797  -0.423   0.6787
## carb3        2.99964    4.29355   0.699   0.4955
## carb4        1.09142    4.44962   0.245   0.8096
## carb6        4.47757    6.38406   0.701   0.4938
## carb8        7.25041    8.36057   0.867   0.3995
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.833 on 15 degrees of freedom
## Multiple R-squared:  0.8931, Adjusted R-squared:  0.779
## F-statistic:  7.83 on 16 and 15 DF,  p-value: 0.000124
R은 첫 번째 요인 수준을 기본 그룹으로 사용합니다. 다른 그룹의 계수를 기본 그룹과 비교해야 합니다.
R에서의 선형 회귀 분석의 가정
최소제곱법은 다음 다섯 가지 조건이 충족될 때만 신뢰할 수 있는 계수와 p값을 생성합니다. plot(fit) 명령이 생성하는 네 가지 진단 그래프는 바로 이러한 조건을 확인하기 위해 존재합니다.
- 선형성 : 각 예측 변수와 y 사이의 관계는 선형입니다. 확인해 보세요. 잔차 대 적합값 그래프를 그려보면 곡선이 보이는데, 이는 변환이나 다항식 항이 필요하다는 의미입니다.
- 독립: 오차항들은 서로 상관관계가 없습니다. 시간 순서대로 정렬된 데이터는 종종 이 조건을 만족하지 못하는데, car 패키지의 durbinWatsonTest() 함수를 사용하여 이를 확인할 수 있습니다.
- 동질성 : 오차 분산은 적합값 전체에 걸쳐 일정합니다. 깔때기 모양은 규모-위치 그래프가 위반을 나타냅니다.
- 잔차의 정규성: 오차는 정규 분포를 따릅니다. 점들은 대각선 상에 위치해야 합니다. 일반 QQ 음모.
- 다중공선성 없음: 예측 변수들은 서로 거의 동일하지 않습니다. 분산팽창계수(VIF)가 5를 넘으면 일반적으로 경고 신호입니다.
library(car)
vif(fit)           # variance inflation factors
shapiro.test(residuals(fit))   # normality of residuals
위반 사항이 항상 모델을 무효화하는 것은 아니지만, p값에 대한 신뢰도를 변화시키므로 계수를 보고하기 전에 위반 사항을 확인해야 합니다.
R에서 선형 회귀 모델을 사용하여 예측하는 방법
모델을 적합시키는 것은 작업의 절반에 불과합니다. predict() 함수는 적합된 계수를 새로운 관측치에 적용합니다.
predict(object, newdata, interval = "none", level = 0.95)
arguments:
-object: The model returned by lm()
-newdata: A data frame whose columns match the predictors used in the formula
-interval: "none", "confidence" for the mean response, or "prediction" for a single new case
-level: The confidence level, 0.95 by default
다음 세 단계를 따르세요.
- 새로운 사례들을 데이터프레임으로 생성합니다. 열 이름은 수식의 예측 변수 이름과 정확히 일치해야 하며, 요인 수준은 훈련 데이터와 일치해야 합니다.
- predict() 함수를 호출하세요. 학습된 객체와 새로운 데이터프레임을 전달합니다.
- 간격을 추가하세요. 평균 응답에 대한 불확실성을 알고 싶을 때는 "신뢰도"를 선택하고, 개별 차량 한 대에 대한 범위를 알고 싶을 때는 "예측"을 선택하세요.
new_cars <- data.frame(wt = c(2.5, 3.2), hp = c(110, 175))
fit_final <- lm(mpg ~ wt + hp, data = mtcars)

predict(fit_final, newdata = new_cars)
predict(fit_final, newdata = new_cars, interval = "prediction")
결과를 읽어보세요. 무게가 2.5파운드이고 출력이 110마력인 자동차의 연비는 대략 24.1mpg로 예측됩니다. 예측 구간은 항상 신뢰 구간보다 넓은데, 이는 예측 구간이 적합된 선의 불확실성에 더해 단일 관측값의 불확실성까지 포함하기 때문입니다.
예측의 정확성을 유지하는 두 가지 규칙이 있습니다. 첫째, 훈련 예측기의 범위를 벗어나는 예측은 절대 하지 마십시오. 직선 그래프는 해당 범위에서 근거가 없기 때문입니다. 둘째, 모델이 이전에 학습하지 않은 데이터를 사용하여 항상 예측을 평가하십시오. 그렇지 않으면 보고된 오차가 실제보다 낙관적으로 나타날 수 있습니다.
R에서 선형 회귀와 로지스틱 회귀 비교
분석가들은 결과값이 연속적이지 않을 때 종종 lm() 함수를 사용합니다. 아래 표는 그 경계를 보여줍니다.
| 기준 | 선형 회귀 | 로지스틱 회귀 |
|---|---|---|
| 응답 변수 | 끊임없는 | 이진 또는 범주형 |
| 예측 출력 | 임의의 실수 | 0과 1 사이의 확률 |
| 견적 | 일반 최소 제곱 | 최대 가능성 |
| 사이즈 측정 | R제곱, RMSE | AIC, 편차, 정확도 |
| R 함수 | lm(수식, 데이터) | glm(formula, data, family = “binomial”) |
결과가 찬성 또는 반대 결정인 경우, 다음 단계로 넘어갑니다. 일반화 선형 모델 0과 1을 통과하는 직선을 억지로 그리는 대신에.
R에서의 단계적 선형 회귀
이 튜토리얼의 마지막 부분에서는 단계적 회귀 알고리즘. 이 알고리즘의 목적은 모델에서 잠재적 후보를 추가 및 제거하고 종속 변수에 상당한 영향을 미치는 후보를 유지하는 것입니다. 이 알고리즘은 데이터 세트에 많은 예측 변수 목록이 포함되어 있을 때 의미가 있습니다. 독립 변수를 수동으로 추가 및 제거할 필요가 없습니다. 단계적 회귀는 모델에 맞는 최상의 후보를 선택하도록 구축되었습니다.
실제로 어떻게 작동하는지 살펴보겠습니다. 교육적인 예시를 위해 연속 변수만 포함된 mtcars 데이터셋을 사용합니다. 분석을 시작하기 전에 상관 행렬을 사용하여 데이터 간의 관계를 살펴보는 것이 좋습니다. GGally 라이브러리는 ggplot2의 확장 기능입니다.
라이브러리에는 행렬에 있는 모든 변수의 상관 관계 및 분포와 같은 요약 통계를 표시하는 다양한 기능이 포함되어 있습니다. 우리는 ggscatmat 함수를 사용할 것이지만, 다음을 참고할 수 있습니다. 소품 GGally 라이브러리에 대한 자세한 내용을 확인하세요.
ggscatmat()의 기본 구문은 다음과 같습니다.
ggscatmat(df, columns = 1:ncol(df), corMethod = "pearson")
arguments:
-df:  A matrix of continuous variables
-columns: Pick up the columns to use in the function. By default, all columns are used
-corMethod: Define the function to compute the correlation between variable. By default, the algorithm uses the Pearson formula
모든 변수 간의 상관관계를 표시하고 단계적 회귀 분석의 첫 번째 단계에 가장 적합한 변수를 결정합니다. 변수와 종속 변수인 mpg 사이에는 강한 상관관계가 있습니다.
library(GGally)
df <- mtcars %>%
	select(-c(am, vs, cyl, gear, carb))
ggscatmat(df, columns = 1: ncol(df))
출력:

단계별 회귀 단계별 예
변수 선택은 모델 적합에 중요한 부분이며, 단계적 회귀 분석은 이러한 탐색을 자동으로 수행합니다. 데이터 세트에서 가능한 선택지가 몇 개나 있는지 추정하려면 다음을 계산합니다.  k는 예측 변수의 수입니다. 독립변수의 수가 많을수록 가능성의 양은 더 커집니다. 그렇기 때문에 자동 검색이 필요합니다.
CRAN에서 olsrr 패키지를 설치해야 합니다. 이 패키지는 아직 Anaconda에서 사용할 수 없습니다. 따라서 명령줄에서 직접 설치합니다.
install.packages("olsrr")
적합 기준(예: R-제곱, 조정된 R-제곱, 베이지안 기준)을 사용하여 가능성의 모든 하위 집합을 표시할 수 있습니다. AIC 기준이 가장 낮은 모델이 최종 모델이 됩니다.
library(olsrr)
model <- mpg~.
fit <- lm(model, df)
test <- ols_all_subset(fit)
plot(test)
Code 설명
- MPG ~.: 추정할 모델을 구성합니다.
- lm(모델, 자유도): OLS 모델을 실행합니다
- ols_all_subset(적합): 관련 통계 정보를 사용하여 그래프를 작성합니다.
- 플롯(테스트): 그래프 그리기
출력:

선형 회귀 모델은 다음을 사용합니다. t- 검정 독립 변수가 종속 변수에 미치는 통계적 영향을 추정하기 위해 단계적 회귀 분석을 사용합니다. 연구자들은 일반적으로 최대 임계값을 10%로 설정하며, p값이 낮을수록 통계적 연관성이 강함을 나타냅니다. 단계적 회귀 분석은 이러한 검정을 기반으로 후보 예측 변수를 추가하고 제거하는 방식으로 구성됩니다. 알고리즘은 다음과 같이 작동합니다.

- 1단계: y에 대한 각 예측변수를 개별적으로 회귀합니다. 즉, y의 x_1, y의 x_2를 x_n으로 회귀합니다. 저장 P-값이 정의된 임계값(기본적으로 0.1)보다 낮은 p-값으로 회귀 변수를 유지합니다. 임계값보다 유의성이 낮은 예측 변수가 최종 모델에 추가됩니다. 입력 임계값보다 낮은 p-값을 갖는 변수가 없으면 알고리즘이 중지되고 상수만 있는 최종 모델이 생성됩니다.
- 2단계: p-값이 가장 낮은 예측 변수를 사용하고 별도로 하나의 변수를 추가합니다. 상수, 0.1단계의 가장 좋은 예측 변수, 세 번째 변수를 회귀시킵니다. 진입 임계값보다 값이 낮은 새로운 예측 변수를 단계별 모델에 추가합니다. p-값이 1보다 낮은 변수가 없으면 알고리즘이 중지되고 예측 변수가 하나만 있는 최종 모델이 생성됩니다. XNUMX단계 가장 좋은 예측 변수의 유의성을 확인하기 위해 단계별 모델을 회귀시킵니다. 제거 임계값보다 높으면 단계별 모델에 보관합니다. 그렇지 않으면 제외합니다.
- 3단계: 새로운 최상의 단계적 모델에서 2단계를 복제합니다. 알고리즘은 입력 값에 따라 단계적 모델에 예측 변수를 추가하고 제외 임계값을 충족하지 않으면 단계적 모델에서 예측 변수를 제외합니다.
- 알고리즘은 변수를 추가하거나 제외할 수 없을 때까지 계속 진행됩니다.
olsrr 패키지의 ols_stepwise() 함수를 사용하여 알고리즘을 수행할 수 있습니다.
ols_stepwise(fit, pent = 0.1, prem = 0.3, details = FALSE)

arguments:
-fit:  Model to fit. Need to use `lm()`before to run `ols_stepwise()
-pent: Threshold of the p-value used to enter a variable into the stepwise model. By default, 0.1
-prem: Threshold of the p-value used to exclude a variable into the stepwise model. By default, 0.3
-details: Print the details of each step
⚠️ 포장 주의사항: olsrr의 최근 버전에서는 이러한 함수의 이름이 변경되었습니다. 사용하세요. ols_step_all_possible() ols_all_subset() 대신에 ols_step_both_p() ols_stepwise() 대신 사용합니다. 인자와 출력은 변경되지 않습니다.
그 전에 알고리즘의 단계를 보여드리겠습니다. 아래는 종속변수와 독립변수가 포함된 표입니다.
| 종속 변수 | 독립 변수 |
|---|---|
| MPG | Disp |
| hp | |
| 드래트 | |
| wt | |
| q초 |
스타트
우선, 알고리즘은 각 독립 변수에 대해 개별적으로 모델을 실행하는 것으로 시작됩니다. 표는 각 모델에 대한 p-값을 보여줍니다.
## [[1]]
##  (Intercept)         disp
## 3.576586e-21 9.380327e-10
##
## [[2]]
##  (Intercept)           hp
## 6.642736e-18 1.787835e-07
##
## [[3]]
##  (Intercept)         drat
## 0.1796390847 0.0000177624
##
## [[4]]
##  (Intercept)           wt
## 8.241799e-19 1.293959e-10
##
## [[5]
## (Intercept)        qsec
##  0.61385436  0.01708199
모델을 입력하기 위해 알고리즘은 가장 낮은 p-값을 갖는 변수를 유지합니다. 위의 출력에서 는 다음과 같습니다.
1단계
첫 번째 단계에서 알고리즘은 wt 및 기타 변수에 대해 독립적으로 mpg를 실행합니다.
## [[1]]
##  (Intercept)           wt         disp
## 4.910746e-16 7.430725e-03 6.361981e-02
##
## [[2]]
##  (Intercept)           wt           hp
## 2.565459e-20 1.119647e-06 1.451229e-03
##
## [[3]]
##  (Intercept)           wt         drat
## 2.737824e-04 1.589075e-06 3.308544e-01
##
## [[4]]
##  (Intercept)           wt         qsec
## 7.650466e-04 2.518948e-11 1.499883e-03
각 변수는 최종 모델에 포함될 수 있는 잠재적 후보입니다. 그러나 알고리즘은 p값이 더 낮은 변수만 유지합니다. 결과적으로 hp의 p값이 qsec보다 약간 낮으므로 hp가 최종 모델에 포함됩니다.
2단계
알고리즘은 첫 번째 단계를 반복하지만 이번에는 최종 모델에 두 개의 독립 변수를 사용합니다.
## [[1]]
##  (Intercept)           wt           hp         disp
## 1.161936e-16 1.330991e-03 1.097103e-02 9.285070e-01
##
## [[2]]
##  (Intercept)           wt           hp         drat
## 5.133678e-05 3.642961e-04 1.178415e-03 1.987554e-01
##
## [[3]]
##  (Intercept)           wt           hp         qsec
## 2.784556e-03 3.217222e-06 2.441762e-01 2.546284e-01
나머지 후보 중 어느 것도 진입 임계값보다 낮은 p값을 갖지 않습니다. 알고리즘은 여기서 멈추고, 이것이 최종 모델입니다.
##
## Call:
## lm(formula = mpg ~ wt + hp, data = df)
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -3.941 -1.600 -0.182  1.050  5.854
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 37.22727    1.59879  23.285  < 2e-16 ***
## wt          -3.87783    0.63273  -6.129 1.12e-06 ***
## hp          -0.03177    0.00903  -3.519  0.00145 **
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.593 on 29 degrees of freedom
## Multiple R-squared:  0.8268, Adjusted R-squared:  0.8148
## F-statistic: 69.21 on 2 and 29 DF,  p-value: 9.109e-12
ols_stepwise() 함수를 사용하면 결과를 비교할 수 있습니다.
stp_s <-ols_stepwise(fit, details=TRUE)
출력:
이 알고리즘은 두 단계 후에 해법을 찾고 위의 수동 풀이와 동일한 결과를 반환합니다.
따라서 최종 모델은 두 개의 예측 변수와 하나의 절편으로 설명됩니다. 즉, 연비는 총 마력과 무게 모두와 음의 상관관계를 갖습니다.
## You are selecting variables based on p value...
## 1 variable(s) added....
## Variable Selection Procedure
##  Dependent Variable: mpg
##
##  Stepwise Selection: Step 1
##
##  Variable wt Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.868       RMSE                3.046
## R-Squared               0.753       Coef. Var          15.161
## Adj. R-Squared          0.745       MSE                 9.277
## Pred R-Squared          0.709       MAE                 2.341
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##		ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     847.725         1        847.725    91.375    0.0000
## Residual       278.322        30          9.277
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.285         1.878                 19.858    0.000    33.450    41.120
##          wt    -5.344         0.559       -0.868    -9.559    0.000    -6.486    -4.203
## ----------------------------------------------------------------------------------------
## 1 variable(s) added...
## Stepwise Selection: Step 2
##
##  Variable hp Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.909       RMSE                2.593
## R-Squared               0.827       Coef. Var          12.909
## Adj. R-Squared          0.815       MSE                 6.726
## Pred R-Squared          0.781       MAE                 1.901
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##			ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     930.999         2        465.500    69.211    0.0000
## Residual       195.048        29          6.726
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.227         1.599                 23.285    0.000    33.957    40.497
##          wt    -3.878         0.633       -0.630    -6.129    0.000    -5.172    -2.584
##          hp    -0.032         0.009       -0.361    -3.519    0.001    -0.050    -0.013
## ----------------------------------------------------------------------------------------
## No more variables to be added or removed.
R에서의 선형 회귀 분석: 핵심 내용 및 함수 참조
- 선형 회귀 분석은 간단한 질문에 대한 답을 제시합니다. 즉, 하나의 목표 변수와 여러 예측 변수 사이의 정확한 관계를 측정할 수 있는가 하는 것입니다.
- 최소제곱법은 제곱 오차의 합, 즉 예측된 y 값과 실제 y 값 사이의 수직 거리를 최소화하는 매개변수를 찾습니다.
- 두 개 이상의 독립 변수를 포함하는 확률 모델을 다중 회귀 모델이라고 합니다.
- 단계별 선형 회귀 알고리즘의 목적은 모델에서 잠재적 후보를 추가하거나 제거하고 종속 변수에 큰 영향을 미치는 후보를 유지하는 것입니다.
- 변수 선택은 모델을 적합시키는 데 중요한 부분이며, 단계적 회귀 분석은 이러한 탐색을 자동으로 수행합니다.
이 튜토리얼에서 사용된 모든 함수는 아래에 나열되어 있습니다.
| 도서관 | 목표 | 함수 | 인수 |
|---|---|---|---|
| 기지 | 선형 회귀 계산 | lm() | 수식, 데이터 |
| 기지 | 모델 요약 | 요약() | 맞게 |
| 기지 | Extract 계수 | lm()$계수 | |
| 기지 | Extract 잔차 | lm()$잔차 | |
| 기지 | Extract 적합값 | lm()$fitted.values | |
| 올스르르 | 단계적 회귀 분석 실행 | ols_단계별() | 적합도, pent = 0.1, prem = 0.3, details = 거짓 |
주의 사항모델을 적합시키기 전에 범주형 변수를 요인형 변수로 변환하는 것을 잊지 마세요.
