
Python 예제와 함께 sort() 나열
 편집 팀
⚡ 스마트 요약
Python `list sort()` 함수는 리스트의 요소를 기본적으로 오름차순으로 정렬하거나 `reverse` 매개변수를 사용하여 내림차순으로 정렬합니다. 또한 선택적 `key function` 함수를 사용하면 길이, 튜플 필드 또는 사용자 정의 함수와 같은 사용자 지정 기준으로 정렬할 수 있습니다.
sort() 메소드는 무엇입니까? Python?
sort() 함수는 Python 리스트를 오름차순 또는 내림차순으로 정렬하는 데 도움이 됩니다. 숫자 리스트, 튜플, 문자열 리스트를 정렬하는 데 사용할 수 있습니다. 별도의 리스트를 생성하지 않고 원본 리스트를 수정하거나 정렬합니다.
Sort 메소드의 구문 Python
정렬 함수의 구문은 다음과 같습니다.
List.sort(key=…, reverse=…)
정렬 함수에는 다음과 같은 두 개의 선택적 매개변수가 있습니다.
- 키:- 정렬 기준에 따라 기능을 정렬하는 데 사용됩니다.
- Reverse: – 이 함수는 true 또는 false 값을 받습니다. true인 경우, 이 사용자 지정 함수는 목록을 내림차순으로 정렬합니다.
Sort 메서드를 사용하여 목록을 오름차순으로 정렬 Python
In Python, 정렬 기능은 기본적으로 모든 목록을 오름차순으로 정렬합니다. 오름차순 목록은 왼쪽에 가장 낮은 값이 있고 오른쪽에 가장 높은 값이 있습니다.
예:
Python 암호:
base_list=["Google","Reliance","Guru99","Content","Syntax"]
base_list.sort()
print("the base list after sorting is",base_list)
출력:
the base list after sorting is ['Content', 'Google', 'Guru99', 'Reliance', 'Syntax']
Code 설명 :
- 위 목록은 무작위로 정의된 문자열 목록입니다.
- 정렬 기능 Python 왼쪽에 가장 낮은 단어 길이, 오른쪽에 가장 높은 단어 길이를 사용하여 무작위 목록을 오름차순으로 정렬하는 데 도움이 됩니다.
목록을 내림차순으로 정렬
정렬 기능을 사용하면 목록을 내림차순으로 정렬할 수도 있습니다. 순서로 정의할 수 있습니다. 여기서 목록은 가장 높은 값으로 시작하고 가장 낮은 값으로 끝납니다.
목록을 내림차순으로 정렬하려면 정렬 함수의 reverse 매개변수를 true로 지정합니다.
아래 예시를 살펴보겠습니다.
Python 암호:
base_list=[100,600,400,8000,50]
base_list.sort()
print("the base list after sorting is",base_list)
# Reverse Order
base_list.sort(reverse=True)
print("the base list after REVERSE sorting is",base_list)
출력:
the base list after sorting is [50, 100, 400, 600, 8000]
the base list after REVERSE sorting is [8000, 600, 400, 100, 50]
참고: 런타임 오류를 방지하려면 reverse 매개변수에 "True"라는 단어를 할당할 때 대문자 "T"로 시작하는지 확인하세요.
Sort 메서드를 사용하여 튜플 목록 정렬 Python
Python 튜플 순서가 지정된 시퀀스를 따르는 불변 요소의 컬렉션입니다. Python의 정렬 함수는 사용자 정의된 함수와 람다 표현식을 사용하여 튜플 목록을 정렬하는 데 사용할 수 있습니다.
사용자 지정 함수는 이름 없이 람다 표현식으로 생성할 수 있습니다. 람다 표현식의 구문은 다음과 같습니다.
구문 :
Lambda arguments: expression
위 구문은 아래 Python 코드와 동일합니다.
def name (arguments):
return expression
다음은 주요 매개변수를 사용하는 정렬 함수가 튜플의 요소를 정렬하는 데 어떻게 도움이 되는지 보여주는 튜플 및 사용자 정의 함수의 예입니다.
Python 암호:
base_list = [('Alto', 2020, 500),('MSFT', 2022, 300),('Guru99', 2019, 1070)]
def get_key(base_list):
    return base_list[2]
base_list.sort(key=get_key,reverse=True)
print("The change in base list is as follows",base_list)
출력:
The change in the base list is as follows [('Guru99', 2019, 1070), ('Alto', 2020, 500), ('MSFT', 2022, 300)]
Code 설명 :
- 튜플을 내림차순으로 정렬하려면 reverse 매개변수를 true로 정의합니다.
- 사용자 정의된 함수는 튜플의 두 번째 요소를 사용합니다.
- 이는 정렬 기능의 키로 활용됩니다.
람다 표현식을 사용하는 아래 예를 살펴보겠습니다.
Python 암호:
base_list = [('Alto', 2020, 500),
('MSFT', 2022, 300),
('Guru99', 2019, 1070)]
base_list.sort(key=lambda base_list:base_list[2],reverse=True)
print("The change in base list is as follows",base_list)
출력:
The change in the base list is as follows [('Guru99', 2019, 1070), ('Alto', 2020, 500), ('MSFT', 2022, 300)]
설명 :
- 람다 식은 키를 튜플의 두 번째 요소로 사용하여 튜플의 요소를 높은 수준에서 낮은 수준으로 정렬하는 데 도움이 됩니다.
- 프로그램은 튜플의 두 번째 요소의 가장 높은 값을 확인합니다.
Len을 주요 매개변수로 사용하여 목록 항목 정렬
`Len`은 항목의 길이를 판별하는 내장 함수입니다. 판별된 길이는 정렬 함수의 인덱싱에 사용할 수 있습니다. 이를 위해 `Len` 값을 변수에 할당합니다. Python 정렬 함수의 주요 매개변수입니다.
다음 Python 코드는 정렬 함수와 함께 Len 함수를 사용하는 방법을 보여줍니다.
Python Code:
base_list=["Alto", "Guru99", "Python", "Google", "Java"]
base_list.sort(key=len)
print("The sorted list based on length:",base_list)
출력:
The sorted list based on length: ['Alto', 'Java', 'Guru99', 'Python', 'Google']
Code 설명 :
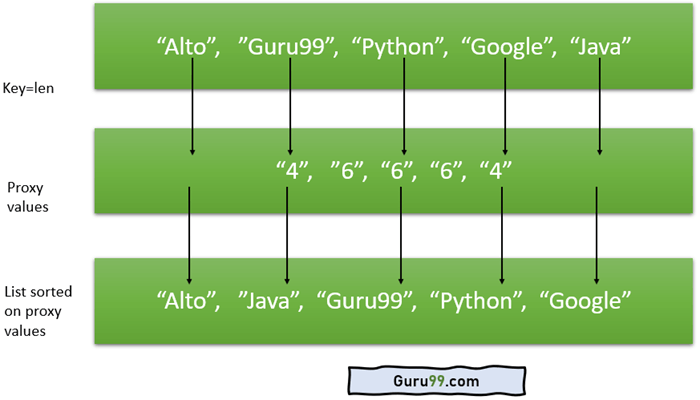
- 요소의 길이는 목록을 오름차순으로 정렬하기 위한 key 매개변수의 인덱스가 됩니다.
- Len 함수는 기본 목록에 있는 각 요소의 길이를 추정합니다.
- 가장 짧은 요소는 왼쪽에, 가장 큰 요소는 오른쪽에 유지됩니다.
- 여기서 'alto'와 'java'라는 단어는 길이가 4이며, 목록에서 맨 앞에 위치하고 그 뒤에 다른 단어들이 이어집니다. Guru길이가 6인 99입니다.
이 예시는 아래와 같이 정렬 함수의 reverse 매개변수 개념을 설명합니다.
Python Code:
base_list=["Alto", "Guru99", "Python", "Google", "Java"]
base_list.sort(key=len,reverse=True)
print("The sorted list based on length:",base_list)
출력:
The sorted list based on length: ['Guru99', 'Python', 'Google', 'Alto', 'Java']
사용자 정의 함수를 주요 매개변수로 사용하여 목록 항목 정렬
리스트를 정렬하기 위해 사용자 정의 함수를 주요 매개변수로 사용할 수도 있습니다. 다음은 예시입니다.
Python Code:
base_list = [{'Example':'Python','year':1991},{'Example':'Alto','year':2014},{'Example':'Guru99', 'year':1995},
{'Example':'Google','year':1985},{'Example':'Apple','year':2007},{'Example':'Emails','year':2010},]
def get_year(element):
    return element['year']
base_list.sort(key=get_year)
print("The base list after sorting using explicit criteria",base_list)
출력:
The base list after sorting using explicit criteria [{'Example': 'Google', 'year': 1985}, {'Example': 'Python', 'year': 1991}, {'Example': 'Guru99', 'year': 1995}, {'Example': 'Apple', 'year': 2007}, {'Example': 'Emails', 'year': 2010}, {'Example': 'Alto', 'year': 2014}]
Code 설명 :
- 연도를 반환하는 사용자 정의 함수가 생성됩니다.
- key 매개변수는 사용자 정의 함수를 기준으로 사용합니다.
- 정렬 기능은 "연도" 요소의 값을 기준으로 목록을 오름차순으로 정렬합니다.
정렬 방법과 정렬 방법의 차이점 Python
위의 예제들을 살펴본 후에는 두 정렬 도구를 직접 비교해 보는 것이 도움이 될 것입니다. 차이점을 정리하기 전에, `Sorted` 메서드의 구문을 먼저 이해해 보겠습니다.
Python 구문 :
sorted (list_name, reverse=…., key=..)
Code 설명 :
- sorted 함수는 목록을 오름차순 또는 내림차순으로 정렬합니다.
- 이 함수는 세 개의 매개변수를 허용하며, 그 중 두 매개변수는 선택적 유형이고 하나의 매개변수는 필수 유형입니다.
- Sorted 메소드를 사용하는 경우 매개변수 list_name이 필요합니다.
- Sorted 메서드는 모든 유형의 반복 가능한 목록을 입력으로 사용할 수 있습니다.
- 정렬된 방법에서 주요 매개변수와 역 매개변수는 선택적 매개변수입니다. Python.
다음은 sort 및 sorted 함수를 사용하는 예입니다. Python:
Python 암호:
#Use of the Sorted method
Base_list=[11,10,9,8,7,6]
print("the original list is",Base_list)
New_list=sorted(Base_list)
print("the New list using sorted method is",New_list)
#Use of the Sort method
Base_list=[11,10,9,8,7,6]
print("the original list is",Base_list)
New_list=Base_list.sort()
print("the New list using sort method is",New_list)
출력:
the original list is [11, 10, 9, 8, 7, 6]
the new list using the sorted method is [6, 7, 8, 9, 10, 11]
the original list is [11, 10, 9, 8, 7, 6]
the new list using the sort method is None
Code 설명 :
- 원본 목록은 정렬된 함수에 대한 필수 매개변수로 전달됩니다.
- Sorted 메서드는 원래 목록 외에 새 목록을 반환합니다.
- sorted 메소드에 추가 매개변수가 전달되지 않으므로 새 목록은 기본적으로 오름차순으로 정렬됩니다.
- 정렬 기능은 새로운 목록을 만들지 않습니다.
주요 유사점과 차이점에 대한 내용은 다음과 같습니다.
| 정렬된 기능 | 정렬 기능 |
|---|---|
| 정렬된 함수 Python list_name을 필수 매개변수로 사용하는 내장 함수입니다. | 정렬 기능은 원본 목록을 매개변수로 사용하지 않습니다. |
| Sorted 메서드는 새 목록을 반환합니다. | 정렬 함수가 새 목록을 반환하지 않습니다. |
| 반복 가능한 목록에는 정렬된 함수를 사용해야 합니다. | 반복할 수 없는 목록에는 정렬 기능을 사용해야 합니다. |
| 원본 목록을 수정하지 않으며 원본 데이터를 유지할 수 있습니다. | 정렬 기능은 원래 기능을 수정하므로 메모리 공간을 덜 차지합니다. |
정렬 방법 또는 정렬 방법을 언제 활용합니까?
인종 데이터를 정렬해야 하는 예를 들어 보겠습니다. 프로그램은 경주를 완료하는 데 걸린 턱받이 번호와 시간(초)을 사용합니다.
Python 암호:
from collections import namedtuple
Base = namedtuple('Runner', 'bibnumber duration')
blist = []
blist.append(Base('8567', 1500))
blist.append(Base('5234', 1420))
blist.append(Base('2344', 1600))
blist.append(Base('2342', 1490))
blist.append(Base('23444', 1620))
blist.append(Base('6674', 1906))
print("original list",blist)
blist.sort(key=lambda x: getattr(x, 'duration'))
top_five_result = blist[:5]
print("Results using sort function",top_five_result)
r_blist=sorted(blist,key=lambda x: getattr(x, 'duration'))
top_five_result = r_blist[:5]
print("Results using sorted function",top_five_result)
출력:
original list [Runner(bibnumber='8567', duration=1500), Runner(bibnumber='5234', duration=1420), Runner(bibnumber='2344', duration=1600), Runner(bibnumber='2342', duration=1490), Runner(bibnumber='23444', duration=1620), Runner(bibnumber='6674', duration=1906)]

Results using sort function [Runner(bibnumber='5234', duration=1420), Runner(bibnumber='2342', duration=1490), Runner(bibnumber='8567', duration=1500), Runner(bibnumber='2344', duration=1600), Runner(bibnumber='23444', duration=1620)]

Results using sorted function [Runner(bibnumber='5234', duration=1420), Runner(bibnumber='2342', duration=1490), Runner(bibnumber='8567', duration=1500), Runner(bibnumber='2344', duration=1600), Runner(bibnumber='23444', duration=1620)]
Code 설명 :
- 기본 목록은 sort 함수와 sorted 함수를 모두 사용하여 정렬됩니다.
- 정렬 기능을 적용하면 기본 목록이 손실됩니다.
- 정렬 기능은 원본 데이터 세트에 적용되어서는 안 됩니다. 원본 데이터 세트의 복사본 버전이 있는 경우 사용해야 합니다.
- Sorted 함수는 원래 목록을 유지합니다. 이를 재정의하지 않습니다.
- 이것은 더 나은 것을 제공합니다 trac효율성과 효과적인 데이터 관리.
