
뚜렷이 구별됨 PostgreSQL: 선택, 주문 기준 및 한도(예)
 편집 팀
⚡ 스마트 요약
뚜렷이 구별됨 PostgreSQL DISTINCT는 SELECT 문과 함께 사용하여 중복된 행을 제거하고 고유한 값만 반환합니다. 이 과정에서는 SELECT 구문, SQL Shell 및 pgAdmin 사용법, 단일 및 다중 열에 대한 DISTINCT 사용 방법, DISTINCT와 GROUP BY의 차이점을 다룹니다.
SELECT 문을 사용하여 테이블에서 데이터를 검색할 수 있습니다.
구문 :
SELECT [column names] FROM [table_name]
여기
- 열 이름: 값을 가져오려는 열의 이름입니다.
- 에서: FROM 절은 SELECT 문에 사용할 하나 이상의 소스 테이블을 정의합니다.
- 테이블_이름: 조회하려는 기존 테이블의 이름입니다.
DISTINCT에서 무엇이 특별한가요? PostgreSQL?
The DISTINCT 절에서 PostgreSQL `SELECT DISTINCT`는 SELECT 문과 함께 사용하여 결과 집합에서 중복된 행을 제거합니다. 열에 반복되는 값이 있는 경우, `SELECT DISTINCT`는 고유한 값만 반환합니다.ping 중복 항목 그룹마다 한 행씩 표시됩니다. 이는 고객의 고유한 도시 또는 제품 카테고리와 같이 중복 없이 고유한 항목 목록을 원하는 경우에 유용합니다.
DISTINCT는 SELECT 문에 나열된 모든 열을 평가하여 행이 고유한지 여부를 결정합니다. PostgreSQL 또한 DISTINCT ON 옵션을 사용하면 지정된 표현식의 각 고유 값에 대해 첫 번째 행을 반환합니다. DISTINCT를 ORDER BY와 조합하여 표시되는 행을 제어하고 LIMIT와 조합하여 결과 개수를 제한할 수 있습니다.
PostgreSQL SQL 셸의 Select 문
단계 1) "tutorials"라는 테이블에는 "id"와 "tutorial_name"이라는 두 개의 열이 있습니다. 이 테이블을 쿼리해 보겠습니다. 다음 쿼리를 사용하여 테이블의 데이터를 나열하세요.
SELECT id,tutorial_name FROM tutorials;

알림: 쿼리하려는 테이블이 포함된 데이터베이스에 연결하려면 `\c` 명령어를 사용하십시오. 이 예에서는 `guru99` 데이터베이스에 연결되었습니다.
단계 2) 특정 테이블의 모든 열을 보려면 별표(*) 와일드카드 문자를 사용할 수 있습니다. 이렇게 하면 모든 가능성을 확인하여 모든 열을 반환합니다.
SELECT * FROM tutorials;

튜토리얼 테이블의 모든 기록을 표시합니다.
단계 3) ORDER 절을 사용하여 특정 열을 기준으로 테이블의 데이터를 정렬할 수 있습니다. ORDER 절은 A~Z 순서로 데이터를 구성합니다.
SELECT * FROM tutorials ORDER BY id;

"ORDER BY" 문 다음에 "DESC"를 사용하여 Z에서 A로 정렬할 수 있습니다.
SELECT * FROM tutorials ORDER BY id DESC;
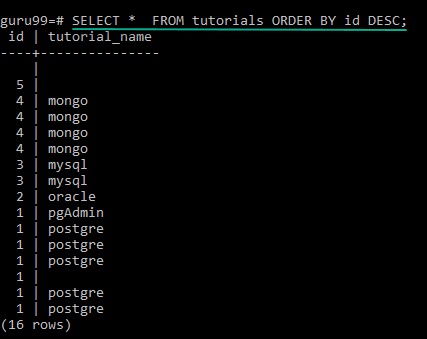
단계 4) SELECT DISTINCT에서 PostgreSQL 절을 사용하여 결과에서 중복 행을 제거할 수 있습니다. 각 중복 그룹에 대해 하나의 행을 유지합니다.
Syntax:
SELECT DISTINCT column_1 FROM table_name;
PostgreSQL에서 고유한 ID 값을 선택하는 쿼리를 사용하여 테이블에서 고유한 ID 값을 가져오는 방법을 알아보겠습니다. PostgreSQL:
SELECT DISTINCT(id) FROM tutorials;

단계 5) 당신은을 사용할 수 있습니다 PostgreSQL LIMIT 절은 SELECT 쿼리가 반환하는 레코드 수를 제한합니다.
SELECT * FROM tutorials LIMIT 4;

PostgreSQL pgAdmin에서 선택문
단계 1) 객체 트리에서:
- 테이블을 마우스 오른쪽 버튼으로 클릭하세요.
- 스크립트를 선택하세요.
- '스크립트 선택'을 클릭하세요.

단계 2) 오른쪽 패널에는 다음과 같은 내용이 있습니다.
- 필요한 경우 SELECT 쿼리를 수정하세요.
- 번개 아이콘을 클릭하세요.
- 출력 결과를 확인하세요.

여러 열에서 서로 다름
SELECT DISTINCT 절은 둘 이상의 열에 적용될 수도 있습니다. DISTINCT 뒤에 여러 열을 나열하면, PostgreSQL 해당 열들의 조합을 하나의 단위로 간주하고, 그 조합 전체가 중복되는 행을 제거합니다.
Syntax:
SELECT DISTINCT column_1, column_2 FROM table_name;
예를 들어, tutorials 테이블에서 tutorial_name과 id의 고유한 조합을 반환하려면 다음과 같이 합니다.
SELECT DISTINCT tutorial_name, id FROM tutorials;
이 경우, tutorial_name과 id가 모두 일치하는 다른 행만 제거됩니다. 두 행이 tutorial_name은 같지만 id 값이 다르면, 해당 조합이 고유하기 때문에 두 행 모두 유지됩니다. 이 동작을 기억하는 것이 중요합니다. DISTINCT는 여러 열이 선택된 경우 특정 열 하나만 중복 제거하는 것이 아니라, 선택된 모든 열을 한꺼번에 중복 제거합니다.
DISTINCT와 GROUP BY의 차이점 PostgreSQL
DISTINCT와 GROUP BY 모두 중복 값을 제거할 수 있지만, 목적은 서로 다릅니다.
- DISTINCT 결과에서 중복되지 않는 행만 반환하며, 중복 제거된 목록만 필요한 경우에 가장 적합합니다.
- GROUP BY 값을 공유하는 행들을 그룹화하여 COUNT, SUM, 또는 기타 집계 함수를 적용할 수 있도록 합니다. AVG 각 그룹별로.
예를 들어, 아래 두 쿼리는 모두 고유 ID 값을 반환합니다.
SELECT DISTINCT id FROM tutorials;
SELECT id FROM tutorials GROUP BY id;
고유한 값만 나열하는 경우에는 DISTINCT를 사용하고, 각 그룹별로 계산이 필요한 경우(예: 각 ID를 공유하는 튜토리얼 수 계산)에는 GROUP BY를 사용하세요. 간단한 쿼리에서는 두 방법 모두 비슷한 성능을 보이지만, 집계가 필요한 경우에는 GROUP BY를 사용해야 합니다.
컨닝 페이퍼
SELECT [column names] FROM [table_name] [clause]
다음은 다양한 매개변수입니다.
- 열 이름: 값을 가져오려는 열의 이름입니다.
- 에서: FROM 절은 SELECT 문에 사용할 하나 이상의 소스 테이블을 정의합니다.
- 테이블_이름: 조회하려는 기존 테이블의 이름입니다.
다양한 조항은 다음과 같습니다:
| 명령 | 기술설명 |
|---|---|
| * | 테이블의 모든 행에 대한 레코드를 가져옵니다. |
| DISTINCT | 뚜렷이 구별됨 PostgreSQL 결과에서 중복된 항목을 제거하는 데 도움이 됩니다. |
| 주문 | 열을 기준으로 행을 정렬합니다. 기본 정렬 순서는 오름차순입니다. 내림차순으로 정렬하려면 DESC 키워드를 사용하십시오. |
| 제한 | 제한 PostgreSQL 쿼리에서 반환되는 레코드 수를 제한합니다. |
