
Matriks Korelasi Pearson & Spearman di R dengan Contoh
 Evelyn Clarke
⚡ Ringkasan Cerdas
Korelasi Pearson dan Spearman di R mengukur seberapa kuat dua variabel bergerak bersama, menggunakan fungsi `cor()` untuk pasangan tunggal dan matriks korelasi untuk banyak pasangan. Panduan ini menambahkan pengujian signifikansi dengan `Hmisc` dan memvisualisasikan hasilnya dengan peta panas GGally.
Korelasi Bivariat pada R
Hubungan Bivariat menggambarkan hubungan -atau korelasi- antara dua variabel di R. Dalam tutorial ini, kita akan membahas konsep korelasi dan menunjukkan bagaimana korelasi dapat digunakan untuk mengukur hubungan antara dua variabel di R.
Korelasi dalam Pemrograman R
Ada dua metode utama untuk menghitung korelasi antara dua variabel dalam Pemrograman R:
- Pearson: Korelasi parametrik
- Spearman: Korelasi non-parametrik
Matriks Korelasi Pearson di R
Metode korelasi Pearson biasanya digunakan sebagai pemeriksaan utama hubungan antara dua variabel.
The koefisien korelasi, yang ditulis r, mengukur kekuatan linear Hubungan antara dua variabel x dan y. Hubungan ini dihitung sebagai berikut:
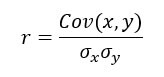
dengan
 adalah simpangan baku dari x
 adalah simpangan baku dari y
 adalah simpangan baku dari x
 adalah simpangan baku dari y
Korelasinya berkisar antara -1 dan 1.
- Nilai r yang mendekati atau sama dengan 0 menunjukkan sedikit atau tidak ada hubungan linier antara x dan y.
- Semakin dekat r ke 1 atau -1, semakin kuat hubungan liniernya.
Anda dapat menguji apakah r berbeda dari nol dengan statistik t di bawah ini, dengan membandingkannya dengan distribusi Student dengan n – 2 derajat kebebasan:
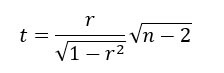
Korelasi Peringkat Spearman di R
Korelasi peringkat mengurutkan observasi berdasarkan peringkat dan menghitung tingkat kesamaan antar peringkat. Korelasi peringkat memiliki keunggulan karena tahan terhadap outlier dan tidak terkait dengan distribusi data. Korelasi peringkat juga merupakan pilihan yang tepat untuk variabel ordinal.
Korelasi peringkat Spearman, yang ditulis rho, juga berkisar dari -1 hingga 1, dan nilai yang mendekati salah satu ekstrem menunjukkan hubungan monotonik yang kuat. Perhitungannya adalah sebagai berikut:
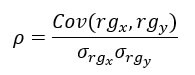
Pembilangnya adalah kovariansi antara peringkat x dan y, dan penyebutnya adalah hasil perkalian simpangan baku keduanya.
Di R, keduanya dihitung dengan fungsi cor(), yang menerima tiga argumen: x, y, dan method.
cor(x, y, method)
kasus:
- x: Vektor pertama
- y: Vektor kedua
- metode: Rumus yang digunakan untuk menghitung korelasi. Tiga nilai string:
- “pearson”
- “kendal”
- "pendekar tombak"
Argumen opsional dapat ditambahkan jika vektor mengandung nilai yang hilang: use = “complete.obs”
Kami akan menggunakan dataset BudgetUK. Dataset ini melaporkan alokasi anggaran rumah tangga Inggris antara tahun 1980 dan 1982. Terdapat 1519 observasi dengan sepuluh fitur, di antaranya:
- makanan: berbagi makanan, berbagi belanja
- bahan bakar: membagi pengeluaran bahan bakar
- kain: pembagian anggaran untuk belanja pakaian
- berjalan: berbagi pengeluaran alkohol
- wtrans: berbagi pengeluaran transportasi
- lebih buruk lagi: bagian pembelanjaan barang lainnya
- totexp: total pengeluaran rumah tangga dalam pound
- penghasilan: total pendapatan bersih rumah tangga
- usia: usia rumah tangga
- anak-anak: jumlah anak
Example
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/british_household.csv"
data <- read.csv(PATH) %>%
    filter(income < 500) %>%
    mutate(log_income = log(income),
           log_totexp = log(totexp),
           children_fac = factor(children, order = TRUE, labels = c("No", "Yes"))) %>%
    select(-c(X, X.1, children, totexp, income))
glimpse(data)
Code Penjelasan
- Pertama-tama kita mengimpor data dan melihatnya dengan fungsi sekilas() dari perpustakaan dplyr.
- Tiga rumah tangga melaporkan pendapatan 500 atau lebih, jadi filter(pendapatan < 500) menghapus mereka dan jumlah baris turun dari 1,519 menjadi 1,516.
- Ini adalah praktik umum untuk mengonversi variabel moneter dalam log. Hal ini membantu mengurangi dampak outlier dan mengurangi kemiringan dalam kumpulan data.
Keluaran:
## Observations: 1,516
## Variables: 10
## $ wfood        <dbl> 0.4272, 0.3739, 0.1941, 0.4438, 0.3331, 0.3752, 0...
## $ wfuel        <dbl> 0.1342, 0.1686, 0.4056, 0.1258, 0.0824, 0.0481, 0...
## $ wcloth       <dbl> 0.0000, 0.0091, 0.0012, 0.0539, 0.0399, 0.1170, 0...
## $ walc         <dbl> 0.0106, 0.0825, 0.0513, 0.0397, 0.1571, 0.0210, 0...
## $ wtrans       <dbl> 0.1458, 0.1215, 0.2063, 0.0652, 0.2403, 0.0955, 0...
## $ wother       <dbl> 0.2822, 0.2444, 0.1415, 0.2716, 0.1473, 0.3431, 0...
## $ age          <int> 25, 39, 47, 33, 31, 24, 46, 25, 30, 41, 48, 24, 2...
## $ log_income   <dbl> 4.867534, 5.010635, 5.438079, 4.605170, 4.605170,...
## $ log_totexp   <dbl> 3.912023, 4.499810, 5.192957, 4.382027, 4.499810,...
## $ children_fac <ord> Yes, Yes, Yes, Yes, No, No, No, No, No, No, Yes, ...
Kita dapat menghitung koefisien korelasi antara variabel pendapatan dan makanan dengan metode “pearson” dan “spearman”.
cor(data$log_income, data$wfood, method = "pearson")
Keluaran:
## [1] -0.2466986
cor(data$log_income, data$wfood, method = "spearman")
Keluaran:
## [1] -0.2501252
Sebelum menerapkan hal ini pada setiap pasangan variabel, ada baiknya kita menetapkan terlebih dahulu bagaimana sebuah koefisien tunggal harus dibaca.
Cara Menginterpretasikan Koefisien Korelasi
Koefisien hanya berguna setelah Anda dapat menjelaskan artinya. Pita di bawah ini adalah pembacaan konvensional, dan tandanya dibaca terpisah dari kekuatannya.
| Nilai absolut dari r | Kekuatan hubungan |
|---|---|
| 0.00 untuk 0.19 | Sangat lemah atau tidak ada sama sekali |
| 0.20 untuk 0.39 | Lemah |
| 0.40 untuk 0.59 | Moderat |
| 0.60 untuk 0.79 | Kuat |
| 0.80 untuk 1.00 | Sangat kuat |
Oleh karena itu, nilai -0.2467 yang dihitung sebelumnya antara log_income dan wfood menunjukkan hubungan negatif yang lemah: rumah tangga yang lebih kaya menghabiskan porsi anggaran mereka yang sedikit lebih kecil untuk makanan.
Tiga peringatan berlaku untuk setiap koefisien.
- Korelasi bukanlah sebab akibat. Nilai r yang kuat menunjukkan bahwa kedua variabel bergerak bersamaan, bukan berarti salah satu menyebabkan yang lain. Variabel ketiga yang tidak terukur sering kali memengaruhi keduanya.
- Pearson hanya melihat garis lurus. Hubungan berbentuk U yang sempurna menghasilkan nilai r mendekati nol. Selalu plot data sebelum mempercayai angka tersebut.
- Ukuran lebih penting daripada signifikansi. Dengan 1,516 pengamatan, koefisien 0.06 dapat signifikan secara statistik namun tetap tidak bermakna secara praktis.
Cara Menguji Signifikansi Korelasi dengan cor.test()
Fungsi cor() mengembalikan koefisien dan tidak ada yang lain. Untuk pasangan tunggal, cor.test() menambahkan nilai p dan interval kepercayaan dalam satu panggilan.
cor.test(data$log_income, data$wfood, method = "pearson")
Hasil keluarannya terdiri dari empat bagian yang layak dibaca.
- t dan df: statistik uji dan derajat kebebasannya, n – 2.
- p-value: probabilitas melihat koefisien sebesar ini jika korelasi sebenarnya adalah nol.
- Interval kepercayaan 95 persen: rentang yang masuk akal untuk korelasi sebenarnya. Jika rentang tersebut tidak termasuk nol, hubungan tersebut signifikan pada tingkat tersebut.
- perkiraan sampel: koefisien itu sendiri, identik dengan apa yang dikembalikan oleh cor().
Fungsi yang sama menjalankan pengujian berbasis peringkat dengan mengubah satu argumen:
# Spearman rank correlation with a p-value
cor.test(data$log_income, data$wfood, method = "spearman")

# One-sided test: is the correlation greater than zero?
cor.test(data$log_income, data$wfood, alternative = "greater")
Kapan menggunakan yang mana. Gunakan cor.test() ketika Anda memeriksa satu pasangan spesifik, karena fungsi ini memberikan interval kepercayaan yang tidak diberikan oleh rcorr(). Gunakan rcorr() dari Hmisc, seperti yang ditunjukkan di atas, ketika Anda membutuhkan nilai p untuk seluruh matriks sekaligus. Perhatikan bahwa pengujian banyak pasangan akan meningkatkan tingkat positif palsu, jadi sesuaikan nilai p dengan p.adjust(p_value, method = “BH”) sebelum menarik kesimpulan dari matriks yang besar.
Matriks Korelasi di R
Korelasi bivariat adalah permulaan yang baik, tetapi pandangan multivariat memberikan gambaran yang lebih luas. A matriks korelasi adalah tabel persegi yang memuat korelasi berpasangan dari setiap variabel terhadap setiap variabel lainnya.
Fungsi cor() mengembalikan matriks korelasi. Satu-satunya perbedaan dengan korelasi bivariat adalah kita tidak perlu menentukan variabel mana. Secara default, R menghitung korelasi antara semua variabel.
Korelasi tidak dapat dihitung untuk suatu faktor, jadi hapus semua kolom kategorikal sebelum meneruskan data frame ke fungsi cor().
Matriks korelasi bersifat simetris yang berarti nilai di atas diagonal mempunyai nilai yang sama dengan nilai di bawah. Lebih visual untuk menampilkan setengah dari matriks.
children_fac dikecualikan karena cor() tidak dapat beroperasi pada faktor.
# the last column of data is a factor level. We don't include it in the code
mat_1 <-as.dist(round(cor(data[,1:9]),2))
mat_1
Code Penjelasan
- cor(data[, 1:9])Hitung matriks korelasi pada sembilan kolom numerik.
- putaran(…, 2)Bulatkan setiap koefisien ke dua angka desimal.
- sebagai.dist()Cetak hanya segitiga bagian bawah, karena matriksnya simetris.
Keluaran:
##            wfood wfuel wcloth  walc wtrans wother   age log_income
## wfuel       0.11
## wcloth     -0.33 -0.25
## walc       -0.12 -0.13  -0.09
## wtrans     -0.34 -0.16  -0.19 -0.22
## wother     -0.35 -0.14  -0.22 -0.12  -0.29
## age         0.02 -0.05   0.04 -0.14   0.03   0.02
## log_income -0.25 -0.12   0.10  0.04   0.06   0.13  0.23
## log_totexp -0.50 -0.36   0.34  0.12   0.15   0.15  0.21       0.49
Tingkat signifikansi
Koefisien saja tidak menunjukkan apakah hubungan tersebut dapat diandalkan secara statistik. Fungsi rcorr() dari pustaka Hmisc mengembalikan nilai p untuk setiap pasangan. Kita dapat mengunduh pustaka tersebut dari [tautan unduhan pustaka]. konda dan salin kode untuk menempelkannya di terminal:
conda install -c r r-hmisc
rcorr() memerlukan bingkai data untuk disimpan sebagai matriks. Kita dapat mengubah data kita menjadi matriks sebelum menghitung matriks korelasi dengan nilai p.
library("Hmisc")
data_rcorr <-as.matrix(data[, 1: 9])

mat_2 <-rcorr(data_rcorr)
# mat_2 <-rcorr(as.matrix(data)) returns the same output
Objek daftar mat_2 berisi tiga elemen:
- r: Output dari matriks korelasi
- n: Jumlah observasi
- P: nilai-p
Kami tertarik pada elemen ketiga, nilai p. Matriks korelasi biasanya ditampilkan dengan nilai p, bukan koefisien korelasi.
p_value <-round(mat_2[["P"]], 3)
p_value
Code Penjelasan
- mat_2[[“P”]]: Nilai p disimpan dalam elemen yang disebut P
- bulat(mat_2[[“P”]], 3): Membulatkan elemen dengan tiga angka
Keluaran:
           wfood wfuel wcloth  walc wtrans wother   age log_income log_totexp
wfood         NA 0.000  0.000 0.000  0.000  0.000 0.365      0.000          0
wfuel      0.000    NA  0.000 0.000  0.000  0.000 0.076      0.000          0
wcloth     0.000 0.000     NA 0.001  0.000  0.000 0.160      0.000          0
walc       0.000 0.000  0.001    NA  0.000  0.000 0.000      0.105          0
wtrans     0.000 0.000  0.000 0.000     NA  0.000 0.259      0.020          0
wother     0.000 0.000  0.000 0.000  0.000     NA 0.355      0.000          0
age        0.365 0.076  0.160 0.000  0.259  0.355    NA      0.000          0
log_income 0.000 0.000  0.000 0.105  0.020  0.000 0.000         NA          0
log_totexp 0.000 0.000  0.000 0.000  0.000  0.000 0.000      0.000         NA
Memvisualisasikan Matriks Korelasi di R
Heat map adalah cara lain untuk membaca matriks korelasi. Pustaka GGally memperluas ggplot2 dan diinstal dari CRAN, bukan conda:
install.packages("GGally")

Perpustakaan mencakup berbagai fungsi untuk menampilkan ringkasan statistik seperti korelasi dan distribusi semua variabel dalam a matriks.
Fungsi ggcorr() memiliki banyak argumen. Kami hanya akan memperkenalkan argumen yang akan kami gunakan dalam tutorial:
Fungsi ggcorr
ggcorr(df, method = c("pairwise", "pearson"),
  nbreaks = NULL, digits = 2, low = "#3B9AB2",
  mid = "#EEEEEE", high = "#F21A00",
  geom = "tile", label = FALSE,
  label_alpha = FALSE)
Argumen:
- df: Kumpulan data yang digunakan
- metode: Rumus untuk menghitung korelasi. Secara default, korelasi berpasangan dan korelasi Pearson dihitung
- nbreak: Mengembalikan rentang kategorikal untuk pewarnaan koefisien. Secara default, tidak ada jeda dan gradien warna berlanjut
- digit: Bulatkan koefisien korelasi. Secara default, disetel ke 2
- rendah: Mengontrol level warna yang lebih rendah
- pertengahan: Mengontrol tingkat menengah pewarnaan
- tinggi: Mengontrol tingkat pewarnaan yang tinggi
- geom: Mengontrol bentuk argumen geometris. Secara default, “ubin”
- label: Nilai Boolean. Menampilkan atau tidak labelnya. Secara default, disetel ke `FALSE`
Peta panas dasar
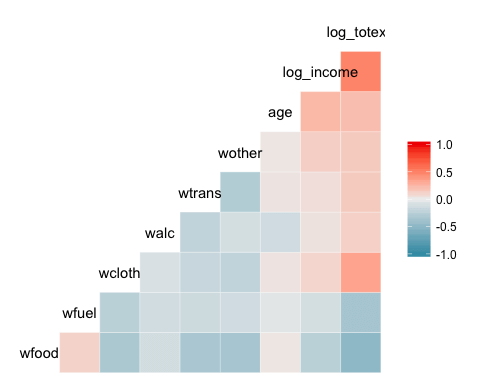
Plot paling dasar dari paket tersebut adalah peta panas. Legenda grafik menunjukkan warna gradien dari – 1 hingga 1, dengan warna panas menunjukkan korelasi positif yang kuat dan warna dingin menunjukkan korelasi negatif.
library(GGally)
ggcorr(data)
Code Penjelasan
- ggkorr(data): Hanya diperlukan satu argumen, yaitu nama frame data. Variabel tingkat faktor tidak disertakan dalam plot.
Keluaran:
Menambahkan Kontrol ke Peta Panas
Kita dapat menambahkan lebih banyak kontrol ke grafik:
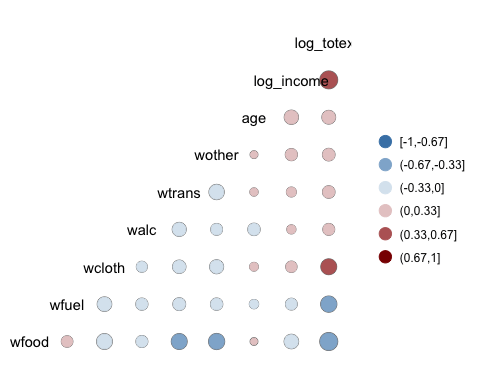
ggcorr(data,
    nbreaks = 6,
    low = "steelblue",
    mid = "white",
    high = "darkred",
    geom = "circle")
Code Penjelasan
- nistirahat=6: pecahkan legenda dengan 6 peringkat.
- rendah = “biru baja”: Gunakan warna yang lebih terang untuk korelasi negatif
- tengah = “putih”: Gunakan warna putih untuk korelasi rentang menengah
- tinggi = “merah tua”: Gunakan warna gelap untuk korelasi positif
- geom = “lingkaran”: Gunakan lingkaran sebagai bentuk jendela di peta panas. Ukuran lingkaran sebanding dengan nilai absolut korelasi.
Keluaran:
Menambahkan Label ke Peta Panas
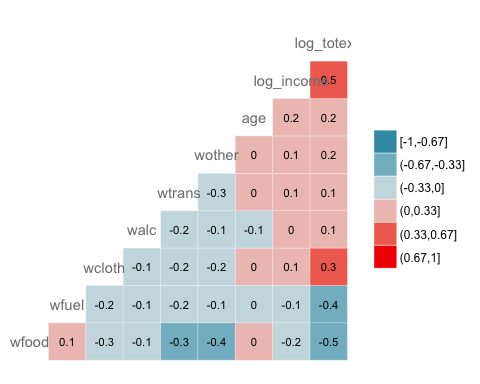
GGally memungkinkan kita untuk menambahkan label di dalam jendela:
ggcorr(data,
    nbreaks = 6,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code Penjelasan
- label = BENAR: Tambahkan nilai koefisien korelasi di dalam peta panas.
- warna = “abu-abu50”: Pilih warnanya, yaitu abu-abu
- label_ukuran = 3: Mengatur ukuran label sama dengan 3
Keluaran:
Fungsi ggpairs
Pustaka GGally juga menyediakan ggpairs(), yang mengembalikan matriks plot. Untuk k variabel yang dipilih, hasilnya adalah grid ak x k: diagonal menunjukkan distribusi setiap variabel, sedangkan panel di atas dan di bawah diagonal masing-masing dapat memuat perhitungan yang berbeda. Sintaksnya adalah:
ggpairs(df, columns = 1:ncol(df), title = NULL,
    upper = list(continuous = "cor"),
    lower = list(continuous = "smooth"),
    mapping = NULL)
Argumen:
- df: Kumpulan data yang digunakan
- kolom: Pilih kolom untuk menggambar plot
- judul: Sertakan judul
- atas: Mengontrol kotak di atas diagonal plot. Perlu menyediakan jenis perhitungan atau grafik yang akan dikembalikan. Jika continuous = “cor”, kita meminta R untuk menghitung korelasi. Perhatikan bahwa argumen harus berupa daftar. Argumen lain tersedia; lihat Dokumentasi GGally for more information.
- menurunkan: Kontrol kotak di bawah diagonal.
- petaping: Menunjukkan estetika grafik. Misalnya, kita dapat menghitung grafik untuk kelompok yang berbeda.
Analisis bivariat dengan ggpair dengan grupping
Grafik berikutnya memplot tiga informasi:
- Matriks korelasi antara variabel log_totexp, log_income, age dan wtrans dikelompokkan berdasarkan apakah rumah tangga tersebut memiliki anak atau tidak.
- Plot distribusi setiap variabel berdasarkan kelompok
- Tampilkan plot sebar dengan tren berdasarkan kelompok
library(ggplot2)
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"), title = "Bivariate analysis of revenue expenditure by the British household", upper = list(continuous = wrap("cor",
        size = 3)),
    lower = list(continuous = wrap("smooth",
        alpha = 0.3,
        size = 0.1)),
    mapping = aes(color = children_fac))
Code Penjelasan
- kolom = c(“log_totexp”, “log_income”, “usia”, “wtrans”): Pilih variabel yang akan ditampilkan dalam grafik
- title = “Analisis bivariat pengeluaran pendapatan rumah tangga Inggris”: Tambahkan judul
- atas = daftar(): Mengontrol bagian atas grafik. Yaitu Di atas diagonal
- kontinyu = bungkus("cor", ukuran = 3)): Hitung koefisien korelasi. Kita membungkus argumen continuous di dalam fungsi wrap() untuk mengontrol estetika grafik (yaitu ukuran = 3) -lower = list(): Mengontrol bagian bawah grafik. Yaitu Di bawah diagonal.
- kontinyu = bungkus("halus",alfa = 0.3,ukuran=0.1): Tambahkan plot sebar dengan tren linier. Kita membungkus argumen continuous di dalam fungsi wrap() untuk mengontrol estetika grafik (yaitu size=0.1, alpha=0.3)
- petaping = aes(warna = wajah_anak)Pisahkan setiap panel berdasarkan children_fac, faktor terurut yang diberi label “Tidak” untuk rumah tangga tanpa anak dan “Ya” untuk rumah tangga dengan anak.
Keluaran:

Analisis bivariat dengan ggpair dengan grup parsialping
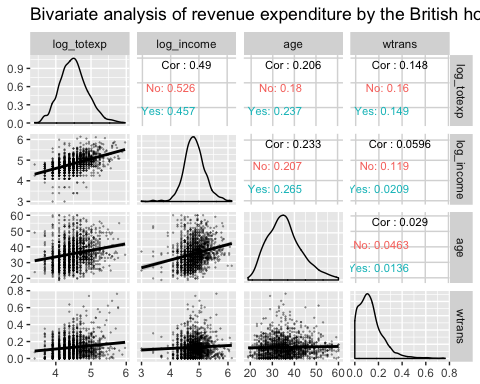
Grafik di bawah ini sedikit berbeda. Kami mengubah posisi peta.ping di dalam argumen atas.
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"),
    title = "Bivariate analysis of revenue expenditure by the British household",
    upper = list(continuous = wrap("cor",
            size = 3),
        mapping = aes(color = children_fac)),
    lower = list(
        continuous = wrap("smooth",
            alpha = 0.3,
            size = 0.1))
)
Code Penjelasan
- Kode yang sama persis dengan contoh sebelumnya kecuali:
- petaping = aes(color = children_fac): Pindahkan daftar ke atas = list(). Kita hanya menginginkan komputasi yang ditumpuk berdasarkan grup di bagian atas grafik.
Keluaran:
Korelasi di R: Poin-Poin Penting dan Referensi Fungsi
- Hubungan Bivariat menggambarkan hubungan -atau korelasi- antara dua variabel di R.
- Ada dua metode utama untuk menghitung korelasi antara dua variabel Pemrograman R: Pearson & Spearman.
- Metode korelasi Pearson biasanya digunakan sebagai pemeriksaan utama hubungan antara dua variabel.
- Korelasi peringkat mengurutkan pengamatan berdasarkan peringkat dan menghitung tingkat kesamaan antar peringkat.
- Korelasi peringkat Spearman berkisar dari -1 hingga 1, dan nilai yang mendekati salah satu ekstrem menunjukkan hubungan monotonik yang kuat.
- Matriks korelasi adalah tabel persegi yang memuat korelasi berpasangan dari setiap variabel.
- Nilai p memberi tahu Anda apakah korelasi yang diamati secara statistik dapat dibedakan dari nol.
Semua fungsi korelasi yang digunakan dalam tutorial ini tercantum di bawah ini:
| Perpustakaan | Tujuan | metode | Code |
|---|---|---|---|
| Mendasarkan | Korelasi bivariat | Pearson |
cor(dfx2, method = "pearson") |
| Mendasarkan | Korelasi bivariat | Spearman |
cor(dfx2, method = "spearman") |
| Mendasarkan | Korelasi multivariat | Pearson |
cor(df, method = "pearson") |
| Mendasarkan | Korelasi multivariat | Spearman |
cor(df, method = "spearman") |
| Hmisc | Nilai P | - |
rcorr(as.matrix(data[,1:9]))[["P"]] |
| GGally | Peta panas | - |
ggcorr(df)
|
| GGally | Matriks plot multivariat | - |
ggpairs(df, columns = c("x1", "x2")) |
