
K-berarti ClusterMengintegrasikan pemrograman R dengan contoh.
 Tim Editorial
⚡ Ringkasan Cerdas
K-Berarti ClusterAlgoritma `ing` di R mengelompokkan observasi dengan meminimalkan jarak antara setiap titik dan centroid klusternya. Panduan ini menstandarisasi dataset harga komputer, menganimasikan algoritma, menemukan nilai k optimal dengan metode siku (elbow method), dan membaca kluster melalui peta panas (heat map).
Apa itu Cluster analisis?
Cluster analisis termasuk dalam belajar tanpa pengawasan. Cluster adalah sekelompok data yang memiliki fitur serupa. Kita dapat mengatakan, analisis clustering lebih tentang penemuan daripada prediksi. Mesin mencari kesamaan dalam data. Misalnya, Anda dapat menggunakan analisis cluster untuk aplikasi berikut:
- Segmentasi pelanggan: Mencari kesamaan antar kelompok pelanggan
- Pengelompokan Pasar Saham: Mengelompokkan saham berdasarkan kinerja
- Mengurangi dimensi dataset dengan cara mengelompokkanping pengamatan dengan nilai serupa
ClusterAnalisis ini tidak terlalu sulit untuk diterapkan dan bermakna serta dapat ditindaklanjuti untuk bisnis.
Perbedaan yang paling mencolok antara pembelajaran yang diawasi dan tidak diawasi terletak pada hasilnya. Pembelajaran tanpa pengawasan menciptakan variabel baru, label, sedangkan pembelajaran dengan pengawasan memprediksi suatu hasil. Mesin tersebut membantu praktisi dalam upaya memberi label pada data berdasarkan keterkaitan yang erat. Terserah analis untuk memanfaatkan grup tersebut dan memberi nama pada grup tersebut.
Mari kita buat contoh untuk memahami konsep pengelompokan. Untuk mempermudah, kita bekerja dalam dua dimensi. Anda memiliki data tentang total pengeluaran pelanggan dan usia mereka. Untuk meningkatkan iklan, tim pemasaran ingin mengirim email yang lebih tertarget kepada pelanggan mereka.
Pada grafik berikut, Anda memetakan total pengeluaran dan usia pelanggan.
library(ggplot2)
df <- data.frame(age = c(18, 21, 22, 24, 26, 26, 27, 30, 31, 35, 39, 40, 41, 42, 44, 46, 47, 48, 49, 54),
    spend = c(10, 11, 22, 15, 12, 13, 14, 33, 39, 37, 44, 27, 29, 20, 28, 21, 30, 31, 23, 24)
)
ggplot(df, aes(x = age, y = spend)) +
    geom_point()

Sebuah pola terlihat pada titik ini
- Di kiri bawah, Anda dapat melihat generasi muda dengan daya beli lebih rendah
- Kelompok menengah ke atas mencerminkan masyarakat dengan pekerjaan yang mampu mereka belanjakan lebih banyak
- Terakhir, lansia dengan anggaran lebih rendah.

Pada gambar di atas, Anda mengelompokkan pengamatan secara manual dan menentukan masing-masing dari ketiga kelompok tersebut. Contoh ini cukup jelas dan sangat visual. Jika observasi baru ditambahkan ke kumpulan data, Anda dapat memberi label pada observasi tersebut di dalam lingkaran. Anda menentukan lingkaran berdasarkan penilaian kami. Sebagai gantinya, Anda bisa menggunakan Pembelajaran mesin untuk mengelompokkan data secara objektif.
Dalam tutorial ini, Anda akan mempelajari cara menggunakan k-berarti algoritma.
Algoritma K-Means
K-means adalah metode pengelompokan yang paling banyak digunakan. Algoritma ini berasal dari tahun 1950-an dan telah disempurnakan berkali-kali sejak saat itu.
Algoritma mencoba mencari kelompok dengan meminimalkan jarak antar pengamatan, disebut optimal lokal solusi. Jarak diukur berdasarkan koordinat pengamatan. Misalnya, dalam ruang dua dimensi, koordinatnya hanyalah x dan y.
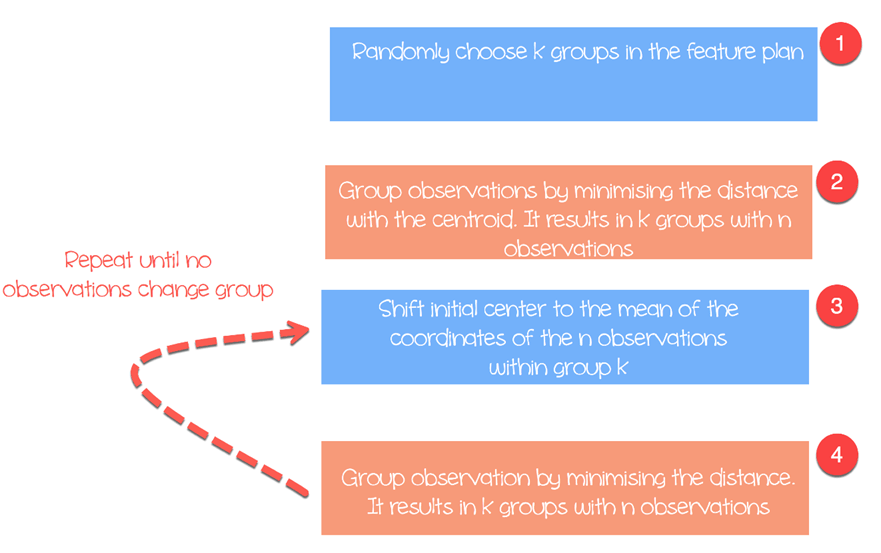
Algoritmanya bekerja sebagai berikut:
- Langkah 1: Pilih k centroid awal secara acak di ruang fitur.
- Langkah 2: Tetapkan setiap observasi ke pusat klaster terdekatnya, pusatIni menghasilkan k kelompok
- Langkah 3: Shift pusat massa awal dengan rata-rata koordinat dalam suatu grup.
- Langkah 4: Minimalkan jarak sesuai dengan centroid baru. Batasan baru tercipta. Dengan demikian pengamatan akan berpindah dari satu kelompok ke kelompok lainnya
- Ulangi sampai tidak ada observasi yang mengubah kelompok
K-means biasanya mengukur jarak Euclidean antara dua pengamatan x dan y:

Tersedia ukuran lain, seperti jarak Manhattan atau Minkowski. Perlu dicatat bahwa K-means menghasilkan kelompok yang berbeda setiap kali algoritma dijalankan. Ingatlah bahwa tebakan awal pertama bersifat acak dan menghitung jarak hingga algoritma mencapai homogenitas di dalam kelompok. Artinya, k-means sangat sensitif terhadap pilihan pertama, dan kecuali jumlah observasi dan kelompoknya kecil, hampir tidak mungkin untuk mendapatkan pengelompokan yang sama.
Memilih jumlah klaster
Kesulitan lain yang ditemukan pada k-means adalah pemilihan jumlah klaster. Anda dapat menetapkan nilai k yang tinggi, yang berarti jumlah kelompok yang besar, untuk meningkatkan homogenitas dalam kelompok, tetapi Anda berisiko terlalu pas Data tersebut. Overfitting berarti kinerja menurun tajam pada data baru, karena model telah menghafal noise dalam sampel tertentu ini daripada pola yang mendasarinya.
Jumlah cluster bergantung pada sifat kumpulan data, industri, bisnis, dan sebagainya. Namun, ada aturan praktis untuk memilih jumlah cluster yang sesuai:

di mana n adalah jumlah pengamatan dalam dataset.
Dalam praktiknya, ada baiknya meluangkan waktu untuk mencari nilai k yang paling sesuai dengan kebutuhan bisnis.
Kami akan menggunakan kumpulan data Harga Komputer Pribadi untuk melakukan analisis pengelompokan. Dataset ini berisi 6259 observasi dan 10 fitur. Kumpulan data tersebut mengamati harga 1993 komputer pribadi di AS dari tahun 1995 hingga 486. Variabelnya antara lain harga, kecepatan, ram, layar, cd.
Anda akan melanjutkan sebagai berikut:
- Impor data
- Latih modelnya
- Evaluasi modelnya
Impor data
K-means tidak cocok untuk variabel faktor, karena algoritma ini bekerja berdasarkan jarak dan label diskrit tidak memiliki jarak yang bermakna di antara keduanya. Hapus tiga kolom kategorikal (cd, multi, premium) beserta indeks baris X. Dataset ini tidak mengandung nilai yang hilang.
library(dplyr)
PATH <-"https://raw.githubusercontent.com/guru99-edu/R-Programming/master/computers.csv"
df <- read.csv(PATH) %>%
select(-c(X, cd, multi, premium))
glimpse(df)
Keluaran
## Observations: 6,259
## Variables: 7
## $ price <int> 1499, 1795, 1595, 1849, 3295, 3695, 1720, 1995, 2225, 2...
## $ speed <int> 25, 33, 25, 25, 33, 66, 25, 50, 50, 50, 33, 66, 50, 25, ...
## $ hd <int> 80, 85, 170, 170, 340, 340, 170, 85, 210, 210, 170, 210...
## $ ram <int> 4, 2, 4, 8, 16, 16, 4, 2, 8, 4, 8, 8, 4, 8, 8, 4, 2, 4, ...
## $ screen <int> 14, 14, 15, 14, 14, 14, 14, 14, 14, 15, 15, 14, 14, 14, ...
## $ ads <int> 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, ...
## $ trend  <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1...
Dari statistik ringkasan, Anda dapat melihat data memiliki nilai yang besar. Praktik yang baik sebelum menggunakan metode berbasis jarak adalah menstandarisasi data sehingga setiap variabel memiliki nilai yang sama. rata-rata nol dan simpangan baku satuTanpa itu, harga, yang nilainya mencapai ribuan, akan mendominasi perhitungan jarak dan ukuran layar hampir tidak berpengaruh.
summary(df)
Keluaran:
##      price          speed              hd              ram
##  Min.   : 949   Min.   : 25.00   Min.   :  80.0   Min.   : 2.000
##  1st Qu.:1794   1st Qu.: 33.00   1st Qu.: 214.0   1st Qu.: 4.000
##  Median :2144   Median : 50.00   Median : 340.0   Median : 8.000
##  Mean   :2220   Mean   : 52.01   Mean   : 416.6   Mean   : 8.287
##  3rd Qu.:2595   3rd Qu.: 66.00   3rd Qu.: 528.0   3rd Qu.: 8.000
##  Max.   :5399   Max.   :100.00   Max.   :2100.0   Max.   :32.000
##      screen           ads            trend
##  Min.   :14.00   Min.   : 39.0   Min.   : 1.00
##  1st Qu.:14.00   1st Qu.:162.5   1st Qu.:10.00
##  Median :14.00   Median :246.0   Median :16.00
##  Mean   :14.61   Mean   :221.3   Mean   :15.93
##  3rd Qu.:15.00   3rd Qu.:275.0   3rd Qu.:21.50
##  Max.   :17.00   Max.   :339.0   Max.   :35.00
Anda mengubah skala variabel dengan fungsi scale() dari perpustakaan dplyr. Transformasi ini mengurangi dampak outlier dan memungkinkan untuk membandingkan observasi tunggal terhadap mean. Jika nilai standar (atau skor-z) tinggi, Anda dapat yakin bahwa pengamatan ini memang berada di atas rata-rata (skor z yang besar menunjukkan bahwa titik ini jauh dari rata-rata dalam standar deviasi. Skor z dua menunjukkan nilainya 2 standar penyimpangan menjauhi mean. Perhatikan, skor-z mengikuti distribusi Gaussian dan simetris di sekitar mean.
# Note: speed is deliberately left out of the scaled data frame
rescale_df <- df %>%
    mutate(price_scal = scale(price),
    hd_scal = scale(hd),
    ram_scal = scale(ram),
    screen_scal = scale(screen),
    ads_scal = scale(ads),
    trend_scal = scale(trend)) %>%
select(-c(price, speed, hd, ram, screen, ads, trend))
Basis R mempunyai fungsi untuk menjalankan algoritma k mean. Fungsi dasar dari k mean adalah:
kmeans(df, k)
arguments:
-df: dataset used to run the algorithm
-k: Number of clusters
Latih modelnya
Pada gambar ketiga, Anda telah menjelaskan secara rinci cara kerja algoritma tersebut. Anda dapat melihat setiap langkah secara grafis dengan paket animasi yang ditulis oleh Yihui Xie, yang juga menciptakan knitr untuk R Markdown. Paket ini tidak ada di saluran conda, jadi instal dari CRAN:
install.packages("animation")
Setelah Anda memuat perpustakaan, Anda menambahkan .ani setelah kmeans dan R akan merencanakan semua langkah. Sebagai ilustrasi, Anda hanya menjalankan algoritma dengan variabel hd dan ram yang diubah skalanya dengan tiga cluster.
set.seed(2345)
library(animation)
kmeans.ani(rescale_df[2:3], 3)
Code Penjelasan
- kmeans.ani(rescale_df[2:3], 3): Pilih kolom 2 dan 3 dari kumpulan data rescale_df dan jalankan algoritme dengan k set ke 3. Plot animasinya.


Anda dapat menafsirkan animasi sebagai berikut:
- Langkah 1: R memilih tiga titik secara acak
- Langkah 2: Hitung jarak Euclidean dan gambar clusternya. Anda memiliki satu cluster berwarna hijau di kiri bawah, satu cluster besar berwarna hitam di sebelah kanan dan satu cluster merah di antara mereka.
- Langkah 3: Hitung pusat massa, yaitu rata-rata cluster
- Ulangi sampai tidak ada perubahan data cluster
Algoritme menyatu setelah tujuh iterasi. Anda dapat menjalankan algoritma k-mean di dataset kami dengan lima cluster dan menyebutnya pc_cluster.
pc_cluster <-kmeans(rescale_df, 5)
Daftar pc_cluster berisi tujuh elemen yang berguna:
- pc_cluster$cluster: Klaster yang ditugaskan untuk setiap observasi
- pc_cluster$centers: Pusat cluster
- pc_cluster$totss: Jumlah total kuadrat
- pc_cluster$withinss: Jumlah kuadrat dalam satu klaster, satu nilai per klaster
- pc_cluster$tot.withinss: Jumlah dari withinss
- pc_cluster$betweenss: Jumlah kuadrat total dikurangi jumlah kuadrat dalam kelompok.
- pc_cluster$size: Jumlah observasi dalam setiap cluster
Anda akan menggunakan jumlah dari jumlah kuadrat (yaitu tot.withinss) untuk menghitung jumlah kluster yang optimal. Menemukan k memang merupakan tugas besar.
Cara Menemukan Nilai k Optimal dengan Metode Siku
Salah satu teknik untuk memilih k terbaik disebut metode siku. Metode ini menggunakan homogenitas dalam kelompok atau heterogenitas dalam kelompok untuk mengevaluasi variabilitas. Dengan kata lain, Anda tertarik dengan persentase varians yang dijelaskan oleh setiap cluster. Anda dapat mengharapkan variabilitas meningkat seiring dengan jumlah cluster, sebaliknya heterogenitas menurun. Tantangan kita adalah menemukan k yang melampaui hasil yang semakin berkurang. Menambahkan cluster baru tidak meningkatkan variabilitas data karena hanya sedikit informasi yang tersisa untuk dijelaskan.
Dalam tutorial ini, kita menemukan titik ini menggunakan ukuran heterogenitas. Jumlah kuadrat total dalam kluster adalah tot.withinss dalam daftar yang dikembalikan oleh kmean().
Anda dapat membuat grafik siku dan mencari k optimal sebagai berikut:
- Langkah 1: Buat fungsi untuk menghitung total jumlah kuadrat dalam cluster
- Langkah 2: Jalankan algoritma pada berbagai nilai k.
- Langkah 3: Buat bingkai data dengan hasil algoritma
- Langkah 4: Plot hasilnya
Langkah 1) Buatlah fungsi untuk menghitung total jumlah kuadrat dalam cluster
Anda membuat fungsi yang menjalankan algoritma k-mean dan menyimpan total dalam jumlah kuadrat cluster
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, k)
    return (cluster$tot.withinss)
}
Code Penjelasan
- function(k): Mengatur jumlah argumen dalam fungsi
- kmeans(rescale_df, k): Jalankan algoritma untuk nilai k ini
- return(cluster$tot.withinss): Menyimpan total dalam cluster jumlah kuadrat
Uji fungsi tersebut dengan k sama dengan 2.
Keluaran:
## Try with 2 cluster
kmean_withinss(2)
Keluaran:
## [1] 27087.07
Langkah 2) Jalankan algoritma sebanyak n kali
Anda akan menggunakan fungsi sapply() untuk menjalankan algoritme pada rentang k. Teknik ini lebih cepat dibandingkan membuat loop dan menyimpan nilainya.
# Set maximum cluster
max_k <-20
# Run algorithm over a range of k
wss <- sapply(2:max_k, kmean_withinss)
Code Penjelasan
- max_k <- 20: Tetapkan nilai maksimum k menjadi 20
- sapply(2:max_k, kmean_withinss): Jalankan fungsi kmean_withinss() pada rentang 2:max_k, yaitu 2 hingga 20.
Langkah 3) Buat bingkai data dengan hasil algoritma
Setelah fungsi ditulis dan diuji, jalankan fungsi tersebut pada rentang 2 hingga 20 dan simpan setiap nilai tot.withinss.
# Create a data frame to plot the graph
elbow <-data.frame(2:max_k, wss)
Code Penjelasan
- data.frame(2:max_k, wss): Membuat bingkai data dengan output dari penyimpanan algoritma di wss
Langkah 4) Gambarkan hasilnya
Anda memplot grafik untuk memvisualisasikan di mana titik sikunya
# Plot the graph with gglop
ggplot(elbow, aes(x = X2.max_k, y = wss)) +
    geom_point() +
    geom_line() +
    scale_x_continuous(breaks = seq(1, 20, by = 1))

Dari grafik terlihat k optimal adalah tujuh, dimana kurva mulai mengalami penurunan return.
Setelah Anda mendapatkan k optimal, jalankan kembali algoritme dengan k sama dengan 7 dan evaluasi cluster.
Memeriksa klaster
pc_cluster_2 <-kmeans(rescale_df, 7)
Seperti disebutkan sebelumnya, Anda dapat mengakses informasi menarik lainnya dalam daftar yang dikembalikan oleh kmean().
pc_cluster_2$cluster
pc_cluster_2$centers
pc_cluster_2$size
Evaluasi bersifat subjektif dan bergantung pada tujuan pengelompokan tersebut. Tujuannya adalah untuk mengelompokkan komputer dengan spesifikasi yang serupa. Seorang ahli di bidangnya dapat melakukan ini secara manual, tetapi prosesnya akan lambat dan rawan kesalahan. K-means melakukan pengelompokan tersebut.ping secara objektif dan menyerahkan kepada ahli untuk menafsirkan dan menyebutkan hasilnya.
Sebagai evaluasi sebelumnya, Anda dapat memeriksa ukuran cluster.
pc_cluster_2$size
Keluaran:
## [1] 608 1596 1231 580 1003 699 542
Klaster terbesar, nomor 2, menampung 1,596 observasi, sedangkan klaster terkecil, nomor 7, hanya menampung 542 komputer. Akan lebih baik jika terdapat homogenitas antar klaster, jika tidak, mungkin diperlukan persiapan data yang lebih sederhana.
Anda mendapatkan gambaran yang lebih mendalam tentang data dengan komponen tengah. Baris mengacu pada penomoran klaster dan kolom mengacu pada variabel yang digunakan oleh algoritma. Nilai-nilai tersebut adalah skor rata-rata setiap klaster untuk kolom yang diminati. Standardisasi membuat interpretasi lebih mudah. Nilai positif menunjukkan bahwa skor z untuk klaster tertentu berada di atas rata-rata keseluruhan. Misalnya, klaster 4 memiliki harga rata-rata tertinggi (price_scal = 1.09), sedangkan klaster 5 memiliki harga rata-rata terendah (-0.82).
center <-pc_cluster_2$centers
center
Keluaran:
##   price_scal    hd_scal     ram_scal screen_scal   ads_scal trend_scal
## 1 -0.6372457 -0.7097995 -0.691520682  -0.4401632  0.6780366 -0.3379751
## 2 -0.1323863  0.6299541  0.004786730   2.6419582 -0.8894946  1.2673184
## 3  0.8745816  0.2574164  0.513105797  -0.2003237  0.6734261 -0.3300536
## 4  1.0912296 -0.2401936  0.006526723   2.6419582  0.4704301 -0.4132057
## 5 -0.8155183  0.2814882 -0.307621003  -0.3205176 -0.9052979  1.2177279
## 6  0.8830191  2.1019454  2.168706085   0.4492922 -0.9035248  1.2069855
## 7  0.2215678 -0.7132577 -0.318050275  -0.3878782 -1.3206229 -1.5490909
Anda dapat membuat peta panas dengan ggplot untuk membantu kami menyoroti perbedaan antar kategori.
Warna default ggplot perlu diubah dengan perpustakaan RColorBrewer. Anda dapat menggunakan conda perpustakaan dan kode untuk diluncurkan di terminal:
conda install -c r r-rcolorbrewer
Untuk membuat peta panas, Anda melanjutkan dalam tiga langkah:
- Bangun bingkai data dengan nilai pusat dan buat variabel dengan jumlah cluster
- Bentuk ulang data dengan fungsi Gather() dari perpustakaan yang lebih rapi. Anda ingin mengubah data dari lebar ke panjang.
- Buat palet warna dengan warnaRampFungsi palet()
Langkah 1) Bangun kerangka data
Mari buat kumpulan data pembentukan ulang
library(tidyr)

# create dataset with the cluster number

cluster <- c(1: 7)
center_df <- data.frame(cluster, center)

# Reshape the data

center_reshape <- gather(center_df, features, values, price_scal: trend_scal)
head(center_reshape)
Keluaran:
##   cluster   features     values
## 1       1 price_scal -0.6372457
## 2       2 price_scal -0.1323863
## 3       3 price_scal  0.8745816
## 4       4 price_scal  1.0912296
## 5       5 price_scal -0.8155183
## 6       6 price_scal  0.8830191
Langkah 2) Buat palet warnanya
Kode di bawah ini membangun palet warna yang digunakan oleh peta panas.
library(RColorBrewer)
# Create the palette
hm.palette <-colorRampPalette(rev(brewer.pal(10, 'RdYlGn')),space='Lab')
Langkah 3) Visualisasikan
Anda dapat memplot grafik dan melihat seperti apa clusternya.
# Plot the heat map
ggplot(data = center_reshape, aes(x = features, y = cluster, fill = values)) +
    scale_y_continuous(breaks = seq(1, 7, by = 1)) +
    geom_tile() +
    coord_equal() +
    scale_fill_gradientn(colours = hm.palette(90)) +
    theme_classic()

Cara Mendapatkan Hasil K-Means yang Dapat Direproduksi dengan set.seed() dan nstart
Tutorial ini mencatat bahwa k-means menghasilkan kelompok yang berbeda pada setiap eksekusi. Itu bukan keanehan yang harus diabaikan, melainkan masalah dengan dua solusi standar, dan tidak satu pun yang digunakan dalam contoh di atas.
1. Tetapkan titik awal dengan set.seed(). Centroid awal diambil secara acak, sehingga panggilan yang sama menghasilkan klaster yang berbeda setiap kali. Menetapkan seed membuat seluruh analisis dapat direproduksi:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, 7)
2. Lakukan beberapa kali percobaan dan pilih yang terbaik dengan nstart. Satu kali permulaan acak dapat mengarah ke optimum lokal yang buruk. Argumen nstart menjalankan algoritma sebanyak itu dari permulaan acak yang berbeda dan mengembalikan yang memiliki total jumlah kuadrat terendah:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, centers = 7, nstart = 25)
Dua puluh lima kali percobaan adalah rekomendasi umum dan biayanya sangat kecil pada dataset sebesar ini. Tanpa itu, kurva siku itu sendiri menjadi tidak stabil, karena setiap titik pada plot berasal dari satu percobaan yang kurang beruntung atau beruntung. Oleh karena itu, fungsi kmean_withinss() yang didefinisikan sebelumnya harus ditulis sebagai:
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, centers = k, nstart = 25)
    return (cluster$tot.withinss)
}
3. Tingkatkan iter.max jika algoritma memberikan peringatan. Jika R melaporkan "tidak konvergen dalam 10 iterasi", berikan iter.max = 50 untuk memberinya ruang lebih banyak.
K-Means vs Hierarchical Clustering di R
K-means bukanlah satu-satunya metode pengelompokan yang tersedia, dan pilihan biasanya bergantung pada ukuran data dan apakah Anda sudah mengetahui berapa banyak kelompok yang Anda inginkan.
| Kriteria | K-Berarti | Hierarkis |
|---|---|---|
| Jumlah klaster | Harus dipilih terlebih dahulu | Dipilih setelahnya, dengan memotong dendrogram. |
| Stabilitas hasil | Bervariasi tergantung pada awal yang acak. | Deterministik |
| Skalabilitas | Mampu menangani kumpulan data yang sangat besar. | Perjuangan di luar beberapa ribu baris |
| Cluster bentuk | Diasumsikan kelompok-kelompok tersebut berbentuk kurang lebih bulat dan berukuran serupa. | Lebih fleksibel |
| Keluaran | Satu set label datar | Dendrogram yang menunjukkan struktur bersarang. |
| fungsi R | kmeans(df, k) | hclust(dist(df)) |
# Hierarchical alternative on the same scaled data
hc <- hclust(dist(rescale_df), method = "ward.D2")
plot(hc)
groups <- cutree(hc, k = 7)
Dengan 6,259 observasi, pengelompokan hierarkis harus membangun matriks jarak sekitar 19.6 juta pasangan, itulah sebabnya k-means merupakan pilihan praktis untuk dataset ini. Perlu dicatat juga bahwa k-means mengasumsikan klaster dengan ukuran yang serupa dan bentuk yang kurang lebih bulat; jika asumsi tersebut gagal, DBSCAN menangani bentuk yang tidak beraturan dan mengidentifikasi outlier alih-alih memaksa setiap titik masuk ke dalam suatu kelompok.
K-Berarti Clustering di R: Referensi Fungsi
Semua fungsi yang digunakan dalam tutorial ini tercantum di bawah ini:
| Paket | Tujuan | fungsi | Argumen |
|---|---|---|---|
| mendasarkan | Latih k-mean | kmeans () | df, k |
| Akses kluster | kmeans()$kluster | ||
| Cluster Pusat | kmeans()$pusat | ||
| Cluster ukuran | kmeans()$ukuran | ||
| Jumlah total dalam jumlah kuadrat | kmeans()$tot.withinss | Digunakan dengan metode siku | |
| Antara jumlah kuadrat | kmeans()$betweenss | ||
| mendasarkan | Hasil yang dapat direproduksi | set.seed() | nilai benih |
| mendasarkan | Stabilkan hasilnya | kmeans(df, k, nstart = 25) | nstart |
