
Tutorial ELK Stack: Kibana, Logstash & Elasticsearch
 David Carter
⚡ Ringkasan Cerdas
ELK Stack menggabungkan tiga alat sumber terbuka — Elasticsearch, Logstash, dan Kibana — untuk mengumpulkan, menyimpan, mencari, dan memvisualisasikan data mesin, memberikan tim teknik pencatatan terpusat dan analitik waktu nyata untuk pemecahan masalah yang lebih cepat di seluruh server dan aplikasi.
ELK Stack adalah salah satu solusi open-source yang paling banyak digunakan untuk pencatatan terpusat dan analitik log. Tutorial ELK Stack ini menjelaskan apa itu Elasticsearch, Logstash, dan Kibana, bagaimana ketiga alat tersebut saling terkait, dan di mana platform tersebut digunakan dalam pekerjaan pemantauan dan observabilitas di dunia nyata.
Apa itu Tumpukan ELK?
The Tumpukan ELK adalah kumpulan dari tiga produk sumber terbuka — Elasticsearch, Logstash, dan Kibana. Ini menyediakan pencatatan terpusat yang membantu Anda mengidentifikasi masalah pada server atau aplikasi dengan memungkinkan Anda mencari semua log Anda di satu tempat. Ini juga membantu Anda mengkorelasikan log di beberapa server dalam jangka waktu tertentu.
- E singkatan dari Elasticsearch: digunakan untuk menyimpan log.
- L singkatan Logstash: digunakan untuk kapalping, memproses, dan menyimpan log.
- K singkatan dari Kibana: sebuah alat visualisasi (antarmuka web) yang dihosting melalui Nginx atau Apache.
Elasticsearch, Logstash, dan Kibana semuanya dikembangkan, dikelola, dan dipelihara oleh sebuah perusahaan bernama Elastis.
Secara keseluruhan, ELK Stack dirancang untuk memungkinkan pengguna mengambil data dari sumber mana pun, dalam format apa pun, lalu mencari, menganalisis, dan memvisualisasikan data tersebut secara real-time.
Tumpukan ELK Architekstur
Setelah Anda memahami apa itu stack, bagian ini menjelaskan arsitektur ELK dan bagaimana data mengalir antar komponen.
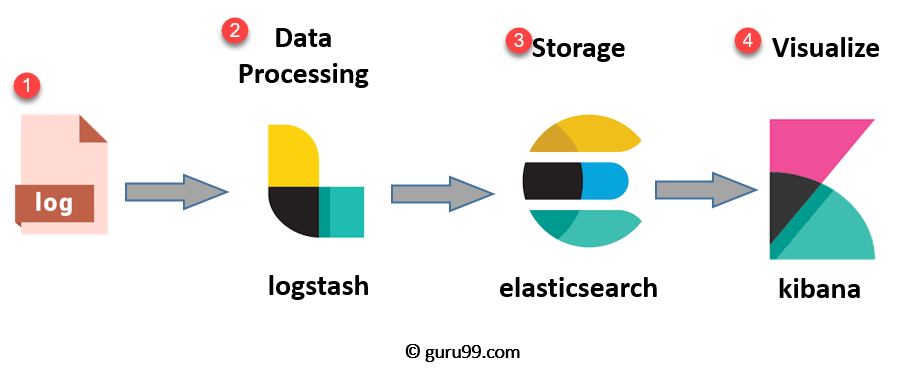
Alur kerja ELK mengikuti urutan yang jelas di mana setiap alat memiliki tugas khusus:
- Log: Log server yang perlu dianalisis telah diidentifikasi.
- Logstash: Mengumpulkan data log dan peristiwa, kemudian mengurai dan mengubahnya.
- Pencarian elastis: Data yang ditransformasikan oleh Logstash disimpan, dicari, dan diindeks.
- Kibana: Menggunakan basis data Elasticsearch untuk mengeksplorasi, memvisualisasikan, dan berbagi wawasan.
Namun, komponen keempat bernama Beats sering ditambahkan untuk pengumpulan data. Beats adalah pengirim data ringan yang diinstal pada server, dan penambahan komponen ini menyebabkan Elastic mengubah nama ELK menjadi Elastic Stack.
Saat Anda menangani data dalam jumlah sangat besar, Anda dapat menambahkan Kafka atau RabbitMQ di depan pipeline untuk buffering dan ketahanan.
Untuk keamanan tambahan, reverse proxy seperti Nginx dapat ditempatkan di depan tumpukan.

Dengan mempertimbangkan arsitektur tersebut, bagian-bagian berikut akan mengulas lebih detail setiap produk sumber terbuka dalam tumpukan teknologi ini.
Apa itu Elasticsearch?
Elasticsearch adalah a Basis data NoSQL Berbasis pada mesin pencari Lucene dan dibangun dengan API RESTful. Ia menawarkan penyebaran yang sederhana, keandalan tinggi, dan manajemen yang mudah, serta menyimpan semua data Anda secara terpusat sehingga Anda dapat menjalankan kueri tingkat lanjut dan pencarian dokumen dengan cepat.
Elasticsearch juga memungkinkan Anda untuk menyimpan, mencari, dan menganalisis data dalam jumlah besar. Elasticsearch paling sering digunakan sebagai mesin dasar yang mendukung aplikasi dengan kebutuhan pencarian yang tinggi.
Karena menambahkan analitik dan banyak fitur canggih di atas pencarian cepat, Elasticsearch telah banyak diadopsi dalam platform pencarian untuk aplikasi web dan seluler modern.
Fitur-fitur Elasticsearch
Elasticsearch menawarkan serangkaian kemampuan yang kaya untuk pengindeksan dan pencarian data:
- Server pencarian sumber terbuka yang ditulis dalam Java.
- Mampu mengindeks semua jenis data heterogen.
- Menyediakan antarmuka web REST API dengan output JSON.
- Pencarian teks lengkap.
- Pencarian mendekati waktu nyata (NRT).
- Penyimpanan dokumen JSON yang terbagi (sharded), direplikasi, dan dapat dicari.
- Penyimpanan dokumen terdistribusi berbasis REST dan JSON tanpa skema.
- Dukungan multibahasa dan geolokasi.
Keuntungan dari Elasticsearch
- Menyimpan data tanpa skema dan juga dapat membuat skema untuk data Anda.
- Memungkinkan Anda memanipulasi data satu per satu menggunakan API multi-dokumen.
- Mendukung penyaringan dan kueri data Anda untuk mendapatkan wawasan.
- Berbasis pada Apache Lucene dan menyediakan API RESTful.
- Menghadirkan skalabilitas horizontal, keandalan, dan kemampuan multi-tenant untuk pengindeksan waktu nyata dan pencarian yang lebih cepat.
- Membantu Anda menskalakan baik secara vertikal maupun horizontal.
Tabel di bawah ini menjelaskan istilah-istilah kunci yang akan Anda temui saat bekerja dengan Elasticsearch:
| Istilah | penggunaan |
|---|---|
| Cluster | Klaster adalah kumpulan node yang bersama-sama menyimpan data Anda dan menyediakan kemampuan pengindeksan dan pencarian gabungan. |
| Node | Sebuah node adalah sebuah instance Elasticsearch tunggal. Node ini dibuat ketika sebuah instance Elasticsearch dimulai. |
| Indeks | Indeks adalah kumpulan dokumen yang memiliki karakteristik serupa, seperti data pelanggan atau katalog produk. Indeks berguna untuk operasi pengindeksan, pencarian, pembaruan, dan penghapusan, dan Anda dapat mendefinisikan banyak indeks dalam satu klaster. |
| Dokumen | Dokumen adalah unit informasi dasar yang dapat diindeks. Dokumen dinyatakan sebagai pasangan kunci-nilai JSON, dan setiap dokumen dikaitkan dengan tipe dan ID unik. |
| Beling | Setiap indeks dapat dibagi menjadi beberapa shard untuk mendistribusikan data. Shard adalah bagian atomik dari sebuah indeks dan dapat disebar ke seluruh klaster saat Anda menambahkan lebih banyak node. |
Apa itu Logstash?
Logstash adalah alat pipeline pengumpulan data dari stack tersebut. Alat ini mengumpulkan input data dan memasukkannya ke Elasticsearch, mengumpulkan semua jenis data dari berbagai sumber dan membuatnya tersedia untuk penggunaan lebih lanjut.
Logstash Dapat menyatukan data dari berbagai sumber dan menormalkannya ke tujuan yang Anda pilih. Ini memungkinkan Anda membersihkan dan mendemokratisasi semua data Anda untuk berbagai kasus penggunaan analitik dan visualisasi.
Ini terdiri dari tiga komponen:
- Memasukkan: Meneruskan data log dan mengubahnya menjadi format yang dapat dibaca mesin.
- filter: serangkaian kondisi yang memicu tindakan tertentu pada suatu peristiwa.
- Keluaran: Pengambil keputusan yang mengarahkan setiap peristiwa atau log yang diproses.
Fitur Logstash
Logstash mencakup beberapa fitur yang membuat pemrosesan log menjadi fleksibel:
- Peristiwa-peristiwa melewati setiap fase menggunakan antrian internal.
- Memungkinkan input yang berbeda untuk log Anda.
- Mendukung penyaringan dan penguraian log Anda.
Keuntungan Logstash
- Memusatkan pemrosesan data Anda.
- Menganalisis berbagai macam data dan peristiwa terstruktur maupun tidak terstruktur.
- Menawarkan plugin untuk terhubung dengan berbagai jenis sumber input dan platform.
Apa itu Kibana?
Kibana adalah alat visualisasi data yang melengkapi ELK Stack. Kibana digunakan untuk memvisualisasikan dokumen Elasticsearch dan membantu pengembang mendapatkan wawasan cepat tentang data mereka melalui diagram interaktif, data geospasial, dan grafik yang membuat kueri kompleks mudah dipahami.
Anda dapat menggunakan Kibana untuk mencari, melihat, dan berinteraksi dengan data yang tersimpan di indeks Elasticsearch. Kibana juga membantu Anda melakukan pencarian tingkat lanjut. analisis data dan sajikan data Anda dalam berbagai tabel, grafik, dan peta.
Kibana mendukung beberapa metode untuk mencari data Anda. Jenis pencarian yang paling umum tercantum di bawah ini:
| Pencarian Tipe | penggunaan |
|---|---|
| Pencarian teks gratis | Digunakan untuk mencari string tertentu. |
| Pencarian tingkat lapangan | Digunakan untuk mencari string dalam bidang tertentu. |
| Pernyataan logis | Digunakan untuk menggabungkan pencarian menjadi pernyataan logis. |
| Pencarian kedekatan | Digunakan untuk mencari istilah dalam rentang karakter tertentu. |
Kibana juga menawarkan sejumlah fitur canggih untuk menjelajahi data yang diindeks:
- Dasbor antarmuka pengguna yang canggih yang memvisualisasikan informasi yang diindeks dari klaster Elasticsearch.
- Memungkinkan pencarian informasi terindeks secara real-time.
- Memungkinkan Anda untuk mencari, melihat, dan berinteraksi dengan data yang tersimpan di Elasticsearch.
- Menjalankan kueri pada data dan memvisualisasikan hasilnya dalam grafik, tabel, dan peta.
- Dasbor yang dapat dikonfigurasi untuk menganalisis data secara mendalam. Logstash log di Elasticsearch.
- Menyediakan data historis dalam bentuk grafik, bagan, dan lainnya.
- Menawarkan dasbor waktu nyata yang mudah dikonfigurasi.
Keuntungan dan Kerugian Kibana
Seperti halnya perangkat lunak lainnya, Kibana memiliki keunggulan yang jelas yang menjelaskan popularitasnya:
- Visualisasi data yang mudah.
- Terintegrasi penuh dengan Elasticsearch.
- Berfungsi sebagai alat visualisasi khusus.
- Menawarkan analisis, pembuatan grafik, rangkuman, dan debugging secara real-time.
- Menyediakan antarmuka yang intuitif dan ramah pengguna.
- Memungkinkan berbagi cuplikan (snapshot) dari log yang telah Anda telusuri.
- Memungkinkan penyimpanan dan pengelolaan beberapa dasbor.
Selain itu, ada beberapa keterbatasan yang perlu diingat:
- Ini hanya berfungsi dengan Elasticsearch sebagai sumber datanya.
- Membangun dan menyempurnakan dasbor yang kompleks dapat melibatkan kurva pembelajaran yang curam.
Mengapa Analisis Log?
Dalam infrastruktur berbasis cloud, kinerja dan isolasi sangat penting.
Performa mesin virtual di cloud dapat bervariasi tergantung pada beban spesifik, lingkungan, dan jumlah pengguna aktif, sehingga keandalan dan kegagalan node dapat menjadi masalah yang signifikan.
A platform manajemen log dapat memantau semua masalah ini. Ia juga dapat memproses log sistem operasi, log server web Nginx dan IIS untuk analisis lalu lintas, log aplikasi, dan log yang dihasilkan di AWS (Amazon Layanan Web).
Pada akhirnya, manajemen log membantu DevOps Para insinyur dan administrator sistem dapat membuat keputusan yang lebih baik dan berbasis data. Inilah mengapa analisis log melalui Elastic Stack atau alat serupa menjadi sangat penting.
Rusa besar vs. Splunk
Pertanyaan umum yang sering muncul adalah bagaimana perbandingan ELK Stack dengan Splunk, sebuah alternatif komersial yang populer. Tabel di bawah ini merangkum perbedaan utamanya:
| RUSA BESAR | Splunk |
|---|---|
| ELK adalah alat sumber terbuka. | Splunk adalah alat komersial. |
| ELK tidak menawarkan Solaris portabilitas berkat Kibana. | Penawaran Splunk Solaris portabilitas. |
| Kecepatan pemrosesan sangat dibatasi. | Menawarkan pemrosesan yang akurat dan cepat. |
| ELK adalah tumpukan teknologi yang dibuat dari kombinasi Elasticsearch, Logstash, dan Kibana. | Splunk adalah alat berpemilik yang menyediakan solusi baik untuk instalasi di lokasi (on-premise) maupun di cloud. |
| Di ELK, pencarian, analisis, dan visualisasi hanya dimungkinkan setelah tumpukan (stack) diatur. | Splunk adalah paket manajemen data lengkap yang siap digunakan. |
| ELK menawarkan integrasi bawaan yang terbatas dengan alat lain. | Splunk berguna untuk membuat integrasi dengan alat-alat lain. |
Studi Kasus
Banyak perusahaan ternama mengandalkan ELK Stack untuk menjalankan pencatatan log dan analitik dalam skala besar. Contoh-contoh di bawah ini menunjukkan bagaimana ELK Stack digunakan dalam lingkungan produksi.
Netflix
Netflix Perusahaan sangat bergantung pada ELK Stack untuk memantau dan menganalisis log keamanan operasi layanan pelanggannya. Platform ini memungkinkan Netflix mengindeks, menyimpan, dan mencari dokumen di lebih dari lima belas klaster yang terdiri dari sekitar 800 node.
Situs jejaring profesional LinkedIn menggunakan ELK Stack untuk memantau kinerja dan keamanan. Tim mereka mengintegrasikan ELK dengan Kafka untuk menangani beban secara real-time, dan operasi ini mencakup lebih dari 100 klaster di enam pusat data.
Tripwire
Tripwire, penyedia Security Information and Event Management (SIEM) di seluruh dunia, menggunakan ELK Stack untuk mendukung analisis log paket informasi.
Medium
Medium, platform penerbitan blog yang populer, menggunakan ELK Stack untuk men-debug masalah produksi dan untuk mendeteksi DynamoDB titik panas. Tumpukan teknologi ini membantu perusahaan mendukung 25 juta pembaca unik dan ribuan postingan baru setiap minggu.
Keuntungan dan Kerugian ELK Stack
Kelebihan
ELK Stack menawarkan beberapa manfaat yang menjelaskan adopsinya yang luas:
- Sistem ini bekerja paling baik ketika log dari berbagai aplikasi suatu perusahaan terkumpul dalam satu instance ELK.
- Hal ini memberikan wawasan mendalam dari satu contoh tunggal dan menghilangkan kebutuhan untuk masuk ke ratusan sumber data terpisah.
- Instalasi cepat di lokasi.
- Mudah diterapkan dan dapat diskalakan baik secara vertikal maupun horizontal.
- Elastic menawarkan banyak klien bahasa pemrograman, termasuk Ruby, PythonPHP, Perl, .NET, Java, dan JavaNaskah.
- Tersedia pustaka untuk berbagai bahasa pemrograman dan skrip.
Kekurangan
Terlepas dari kelebihannya, ELK Stack memiliki beberapa kekurangan yang perlu dipertimbangkan:
- Berbagai komponen tersebut dapat menjadi sulit dikelola saat Anda beralih ke pengaturan yang lebih kompleks.
- Ada kurva pembelajaran yang cukup curam, jadi bersiaplah untuk beberapa proses coba-coba saat Anda mendapatkan pengalaman.
