
Hadoop MapReduce példa: Első Java Program a Code
 Prafulla Ranadive
⚡ Okos összefoglaló
A Hadoop MapReduce programok háromféleképpen írhatók meg: Java osztályokat, egy leképezőt, egy reduktort és egy illesztőprogramot, amelyeket lefordítanak, egy jar-ba csomagolnak, és elküldenek a klaszternek az országonkénti eladások számlálásához.
Ebben az oktatóanyagban megtanulja a Hadoop használatát a MapReduce példákkal. A felhasznált bemeneti adat a ÉrtékesítésJan2009.csv. Értékesítéssel kapcsolatos információkat tartalmaz, például a termék nevét, árát, fizetési módját, az ügyfél városát és országát. A cél az egyes országokban eladott termékek számának meghatározása.
Az első Hadoop MapReduce program
Most ebben MapReduce oktatóanyag, létrehozzuk az elsőt Java MapReduce program:
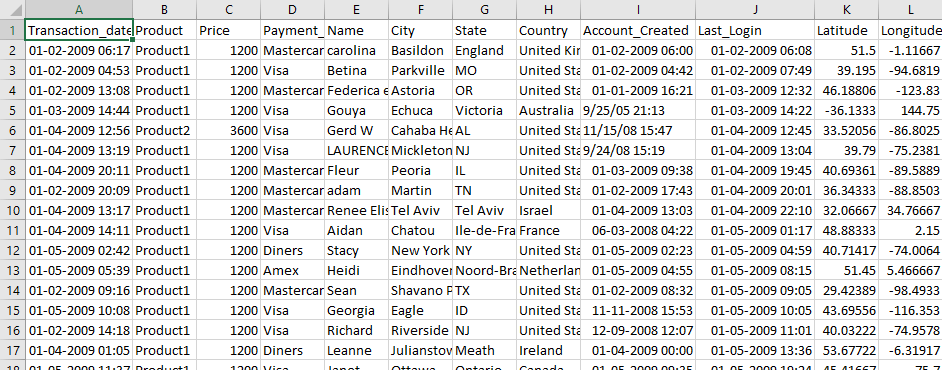
Az alábbi képernyőkép a nyers SalesJan2009 adatokat mutatja, ahol minden sor egy tranzakciót jelöl, az ország pedig a nyolcadik, vesszővel elválasztott oszlopban található.
Győződjön meg róla, hogy telepítve van a Hadoop. Mielőtt elkezdené a tényleges folyamatot, módosítsa a felhasználót „hduser”-re (a Hadoop konfigurálásakor használt azonosító – átválthat a saját Hadoop konfigurációja során használt felhasználói azonosítóra).
su - hduser_
A prompt a hduser fiókra változik, az alábbiak szerint.

1. lépés) Hozza létre a projektkönyvtárat és a forrásfájlokat
Hozz létre egy új könyvtárat MapReduceTutorial néven, ahogy az az alábbi MapReduce példában látható.
sudo mkdir MapReduceTutorial

Adjon engedélyeket
sudo chmod -R 777 MapReduceTutorial

Hozd létre a hármat Java forrásfájlok a MapReduceTutorial alatt. Megjegyzendő, hogy mindhárom a régebbi verziót használja. org.apache.hadoop.mapred API, amely továbbra is a Hadoop 3.x-szel együtt érkezik.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
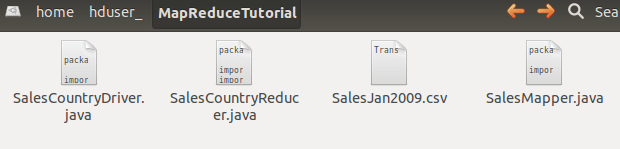
Az archívum ugyanarra a három forrásfájlra bővül ki, ahogy itt is látható.
Ellenőrizze az összes fájl engedélyeit

Ha hiányoznak az „olvasási” jogosultságok, akkor adja meg azokat:

2. lépés) A Hadoop osztályútvonal exportálása
Exportálja az osztályútvonalat az alábbi Hadoop példában látható módon.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Az exportált osztályútvonal visszajelzésre kerül a promptnál.

3. lépés) Fordítsd le a Java fájlok
Fordítsd le a Java fájlok (ezek a fájlok a Final-MapReduceHandsOn könyvtárban találhatók). Az osztályfájljaik a csomag könyvtárába kerülnek.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
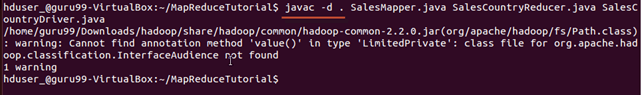
Ez a figyelmeztetés biztonságosan figyelmen kívül hagyható – csak azt jelzi, hogy a leképezett API elavult.
Ez a fordítás egy könyvtárat hoz létre az aktuális könyvtárban, amelynek neve a megadott csomagnév lesz. Java forrásfájlt (azaz a mi esetünkben a SalesCountry-t), és ebbe tegyük az összes lefordított osztályfájlt.

4. lépés) A jegyzékfájl létrehozása
Hozz létre egy új Manifest.txt fájlt
sudo gedit Manifest.txt
Adja hozzá a következő sort:
Main-Class: SalesCountry.SalesCountryDriver

A SalesCountry.SalesCountryDriver a fő osztály neve. Kérjük, vegye figyelembe, hogy a sor végén meg kell nyomni az Enter billentyűt.
5. lépés) Csomagold be az osztályokat egy üvegbe
Hozzon létre egy Jar fájlt
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Ellenőrizze, hogy létrejött-e a jar fájl

6. lépés) Indítsa el a Hadoop-ot
Indítsa el a Hadoop-ot
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
7. lépés) Másolja a bemeneti fájlt a HDFS-be
Másold a SalesJan2009.csv fájlt a ~/inputMapReduce könyvtárba.
Most használd az alábbi parancsot a ~/inputMapReduce fájl HDFS-be másolásához.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
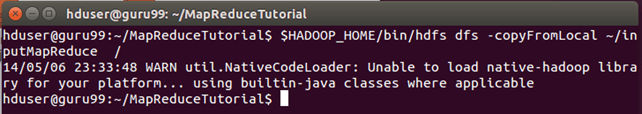
Ezt a figyelmeztetést nyugodtan figyelmen kívül hagyhatjuk.
Ellenőrizze, hogy egy fájl valóban át van-e másolva vagy sem.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

8. lépés) Futtassa a MapReduce feladatot
Futtassa a MapReduce feladatot
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Ezzel létrejön egy mapreduce_output_sales on kimeneti könyvtár HDFS. Ennek a könyvtárnak a tartalma országonkénti termékeladásokat tartalmazó fájl lesz.
9. lépés) Olvasd le az eredményeket
Az eredmény a parancssori felületen keresztül a következőképpen tekinthető meg:
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
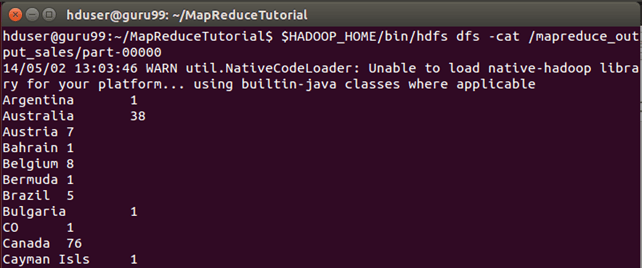
Az eredmények webes felületen is megtekinthetők, pl.
Nyisd ki http://localhost:50070/ egy webböngészőben. A Hadoop 3.x rendszeren a NameNode webes felhasználói felülete átkerült a következő portra: 9870, szóval használd http://localhost:9870/ ott helyette.

Most válaszd a „Fájlrendszer böngészése” lehetőséget, és navigálj a /mapreduce_output_sales mappába.

Nyissa meg az r-00000 részt

A SalesMapper osztály magyarázata
A feladat teljes hosszában halad, a következő három rész bemutatja, hogy mit is csinálnak valójában az egyes osztályok.
Ebben a részben a SalesMapper osztály implementációját fogjuk megérteni.
1. Először is megadjuk az osztályunk csomagnevét. A SalesCountry a csomagunk neve. Fontos megjegyezni, hogy a fordítás kimenete, a SalesMapper.class, a következő csomagnévvel ellátott könyvtárba kerül: SalesCountry.
Ezt követően a könyvtári csomagokat importáljuk.
Az alábbi pillanatkép a SalesMapper osztály egy implementációját mutatja be:

Minta Code Magyarázat:
1. SalesMapper osztálydefiníció-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Minden mapper osztályt ki kell bővíteni a MapReduceBase osztályból, és meg kell valósítania a Mapper interfészt.
2. 'térkép' függvény meghatározása-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
A Mapper osztály fő része egy 'map()' metódus, amely négy argumentumot fogad el.
A 'map()' metódus minden hívásakor egy kulcs-érték párt (ebben a kódban 'key' és 'value') adunk át.
A 'map()' metódus azzal kezdődik, hogy az argumentumként kapott bemeneti szöveget felosztja. Minden sort mezőkre oszt.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Itt a ',' karaktert használjuk elválasztóként.
Ezután egy párt képezünk a 'SingleCountryData' tömb 7. indexénél található rekord és az '1' érték felhasználásával.
output.collect(new Text(SingleCountryData[7]), one);
A 7. indexű rekordot választjuk, mert országadatokra van szükségünk, és ez a 'SingleCountryData' tömb 7. indexén található.
Felhívjuk figyelmét, hogy a bemeneti adataink az alábbi formátumban vannak (ahol az Ország a 7. indexben szerepel, a 0 pedig a kezdőindex):
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
A mapper kimenete ismét egy kulcs-érték pár, amelyet az 'OutputCollector' 'collect()' metódusa bocsát ki.
A SalesCountryReducer osztály magyarázata
Ebben a részben a SalesCountryReducer osztály implementációját fogjuk megérteni.
1. Először is megadjuk az osztályunk csomagjának nevét. Az ÉrtékesítésiOrszág a csomagunk neve. Fontos megjegyezni, hogy a fordítás kimenete, a SalesCountryReducer.class, a következő csomagnévvel ellátott könyvtárba kerül: ÉrtékesítésiOrszág.
Ezt követően a könyvtári csomagokat importáljuk.
Az alábbi pillanatkép a SalesCountryReducer osztály egy implementációját mutatja be:
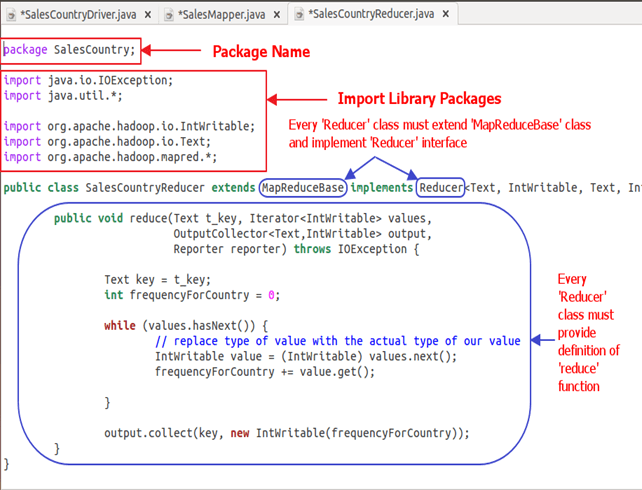
Code Magyarázat:
1. SalesCountryReducer osztály definíció-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Itt az első két adattípus, a „Text” és az „IntWritable” a reduktor bemeneti kulcsértékének adattípusa.
A mapper kimenete a következő formában van: , A mapper ezen kimenete a reduktor bemenetévé válik. Tehát az adattípusának megfelelően a Text és az IntWritable adattípust használjuk itt.
Az utolsó két adattípus, a „Text” és az „IntWritable” a reduktor által kulcs-érték pár formájában generált kimenet adattípusa.
Minden reducer osztályt ki kell bővíteni a MapReduceBase osztályból, és meg kell valósítania a Reducer interfészt.
2. A 'csökkentési' függvény meghatározása-
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
A reduce() metódus bemenete egy kulcs, amely több értékből álló listát tartalmaz.
Például a mi esetünkben az lesz,
, , , , , .
Ezt a reduktornak a következőképpen adjuk meg:
Tehát az ilyen alakú argumentumok elfogadásához az első két adattípust használjuk, nevezetesen a Text és az Iterator adattípust. A szöveg a kulcs és az iterátor adattípusa. egy adattípus, amely az adott kulcs értékeinek listáját tartalmazza.
A következő argumentum OutputCollector típusú. amely összegyűjti a redukáló fázis kimenetét.
A reduce() metódus a kulcsérték másolásával és a frekvenciaszámláló 0-ra való inicializálásával kezdődik.
Text key = t_key;int frequencyForCountry = 0;
Ezután a 'while' ciklus segítségével végigmegyünk a kulcshoz tartozó értékek listáján, és az összes érték összegzésével kiszámítjuk a végső gyakoriságot.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Most az eredményt kulcs és a kapott frekvenciaszámláló formájában a kimeneti gyűjtőbe küldjük.
Az alábbi kód ezt teszi-
output.collect(key, new IntWritable(frequencyForCountry));
A SalesCountryDriver osztály magyarázata
Ebben a szakaszban a SalesCountryDriver osztály implementációját fogjuk megérteni.
1. Először is adjuk meg az osztályunk csomagnevét. A SalesCountry a csomagunk neve. Fontos megjegyezni, hogy a fordítás kimenete, a SalesCountryDriver.class, a következő csomagnévvel ellátott könyvtárba kerül: SalesCountry.
Itt van egy sor, amely megadja a csomag nevét, majd a kódot a könyvtári csomagok importálásához.

2. Határozzon meg egy illesztőprogram-osztályt, amely új ügyfélfeladatot, konfigurációs objektumot hoz létre, és hirdeti a Mapper és Reducer osztályokat.
A vezetői osztály felelős a MapReduce munkánk beindításáért HadoopEbben az osztályban megadjuk a feladat nevét, a bemenet/kimenet adattípusát, valamint a leképező és reduktor osztályok nevét.

3. Az alábbi kódrészletben bemeneti és kimeneti könyvtárakat állítunk be, amelyek a bemeneti adatkészlet felhasználására és a kimenet előállítására szolgálnak.
Az arg[0] és az arg[1] a MapReduce gyakorlati használatában kiadott parancsokkal átadott parancssori argumentumok, azaz
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
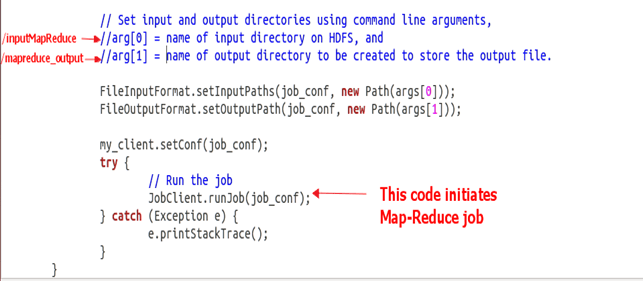
4. Indítsuk el munkánkat
Az alábbi kód elindítja a MapReduce feladat végrehajtását -
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
