
Zavaros mátrix a gépi tanulásban az EXAMPLE-vel
 Evelyn Clarke
⚡ Okos összefoglaló
A zavart okozó mátrix egy teljesítménymérő táblázat osztályozási modellekhez, amely összehasonlítja az előre jelzett címkéket az ismert tényleges címkékkel, pontosan feltárva, hogy egy osztályozó mely osztályokat értelmezi helyesen, és melyeket hibáztat.
Mi az a Confusion Matrix?
A zavart mátrix egy teljesítménymérési technika, amely gépi tanulás osztályozás. Ez egy táblázat, amely bemutatja, hogyan teljesített egy osztályozási modell egy olyan tesztadat-halmazon, amelynek valódi értékei már ismertek. A zavaró mátrix kifejezés elég egyszerű, de a ráépített terminológia zavaró lehet, ezért minden egyes darabját az alábbiakban egyszerű nyelven ismertetjük.
A mátrix bármely felügyelt osztályozó — logisztikus regresszió, döntési fa, Naiv Bayes modell vagy mély ideghálózat – mivel csak két oszlopnyi címkét hasonlít össze: amit a modell előrejelzett, és ami valójában igaz volt.
A zavaros mátrix négy eredménye
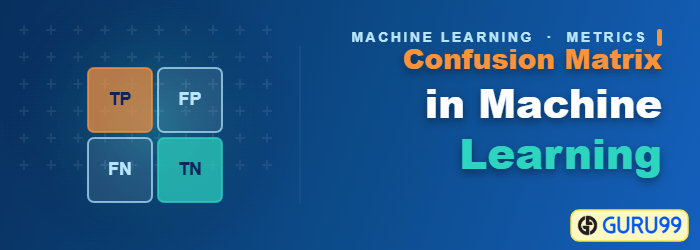
A zavaros mátrix a tényleges és az előre jelzett osztályok összehasonlításával jeleníti meg az osztályozó pontosságát. A bináris összetévesztési mátrix négyzetekből áll:

A fenti táblázat leképezi a négy négyzetet, amelyeket minden bináris zavart okozó mátrix tartalmaz:
- TP: Igaz pozitív: Az előrejelzett értékek helyesen lettek megjósolva tényleges pozitívként
- FP: Hamis pozitív: Az előrejelzett értékek helytelenül lettek előrejelezve tényleges pozitívként, azaz a negatív értékek pozitívként lettek előrejelezve
- FN: Hamis negatív: Pozitív értékek negatívként jósolva
- TN: Igaz Negatív: Az előrejelzett értékek helyesen lettek megjósolva tényleges negatívként.
A statisztika a két hibacellának saját nevet ad. A téves pozitív eredmény a következő: I. típusú hiba — a modell olyan riasztást adott, amelynek soha nem lett volna szabadna megtörténnie. A téves negatív egy II típusú hiba — a modell hallgatott, amikor riasztania kellett volna. A kettő közül a drágább probléma megoldása eldönti, hogy melyik metrikát finomhangolja később.
A pontossági tesztet a zavaró mátrixból számíthatja ki, ahogy az alábbi képlet mutatja:

Példa a zavart mátrixra
A Confusion Matrix egy hasznos gépi tanulási módszer, amely lehetővé teszi a felidézés, a pontosság, az AUC-ROC görbe mérését. Az alábbi futballpélda bemutatja, hogy mit jelentenek a valódi pozitív, valódi negatív, álpozitív és álnegatív kifejezések a köznyelvben.
Igazi pozitív:
Pozitívat jósoltál, és az igaznak bizonyult. Például azt jósoltad, hogy Franciaország nyeri a világbajnokságot, és meg is nyerte.
Igazi negatív:
Negatívumot jósoltál, és ez igaz is. Azt jósoltad, hogy Anglia nem fog nyerni, és veszített.
Álpozitív:
Jóslata pozitív, és hamis.
Azt jósolták, hogy Anglia győzni fog, de veszítettek.
Hamis negatív:
A jóslatod negatív, és az eredmény hamissá teszi.
Azt jósoltad, hogy Franciaország nem fog nyerni, de győzött.
Ne feledd, hogy az első szó azt írja le, hogy a jóslat helyes vagy helytelen volt-e (Igaz vagy Hamis), a második szó pedig azt, hogy mit jósolt meg a modell (Pozitív vagy Negatív).
Hogyan számítsunk ki egy zavaros mátrixot
Íme a zavaró mátrix kiszámításának lépésről lépésre történő folyamata: adatbányászat:
- Step 1) Először is szükséged van egy tesztadatbázisra a várható eredményértékekkel együtt.
- Step 2) Jósolja meg a tesztadatkészlet összes sorát.
- Step 3) Hasonlítsa össze a várható eredményeket az előrejelzésekkel, és számoljon:
- Az egyes osztályok helyes előrejelzéseinek összessége.
- Az egyes osztályok hibás előrejelzéseinek összessége.
Ezt követően ezeket a számokat az alábbi módszerek szerint rendezzük:
- A mátrix minden sora egy tényleges osztálynak felel meg.
- A mátrix minden oszlopa egy előrejelzett osztályhoz kapcsolódik.
- A helyes és hibás besorolások összesített száma bekerül a táblázatba.
- Egy osztályra vonatkozó helyes előrejelzések összege abba a cellába kerül, ahol az osztály tényleges sora találkozik a saját előrejelzett oszlopával – ez az átló.
- Egy osztályra vonatkozó helytelen előrejelzések összege az adott osztályérték tényleges sorába és a modell által választott osztály előrejelzési oszlopába kerül.
A sorok és oszlopok szerepe inkább konvenció, mint törvény, és egyes ábrázoló eszközök felcserélik az elrendezést, ezért a mátrix értelmezése előtt mindig olvasd el a tengelyfeliratokat. Az itt használt orientáció – a sorokon valós, az oszlopokon előre jelzett – az, amelyet a scikit-learn előállít.
Egyéb fontos kifejezések a Confusion mátrix használatával
Miután a négy szám a helyére került, másodlagos kifejezések családja írja le ugyanazon táblázat különböző szeleteit:
- Pozitív prediktív érték (PPV): Ez nagyon közel áll a precizitáshoz. A két kifejezés között az egyik jelentős különbség, hogy a PPV figyelembe veszi az előfordulási gyakoriságot. Abban az esetben, ha az osztályok tökéletesen kiegyensúlyozottak, a pozitív prediktív érték megegyezik a precizitással.
- Null hibaarány: Ez a kifejezés azt határozza meg, hogy milyen gyakran lenne téves az előrejelzésed, ha mindig a többségi osztályt jósolnád meg. Alapmutatóként kezelheted, amellyel összehasonlíthatod az osztályozódat.
- F pontszám: Az F1 pontszám a valódi pozitív arány (visszahívás) és a pontosság súlyozott átlagpontszáma.
- ROC görbe: A ROC-görbe a valódi pozitív arányt és a téves pozitív arányt ábrázolja különböző határértékeken. Emellett egy kompromisszumot is mutat az érzékenység (felidézhetőség) és a specificitás között, ami a valódi negatív arány.
- Pontosság: A precíziós metrika a pozitív osztály pontosságát mutatja. Azt méri, hogy a pozitív osztály előrejelzése mennyire valószínű.

A maximális pontszám 1, ha az osztályozó tökéletesen osztályozza az összes pozitív értéket. A pontosság önmagában nem túl hasznos, mert figyelmen kívül hagyja a negatív osztályt. A metrikát általában a visszahívási metrikával párosítják. A visszahívást érzékenységnek vagy valódi pozitív aránynak is nevezik, és az alábbiak szerint írják fel.
- Érzékenység: Az érzékenység kiszámítja a helyesen detektált pozitív osztályok arányát. Ez a mutató azt mutatja, hogy a modell mennyire jól ismeri fel a pozitív osztályokat.

Zavart mátrix metrikák és képletek
A fenti mutatók mindegyike ugyanazon a négy szemponton alapuló aritmetikai mutató, ezért hasznos, ha egymás mellett látjuk őket azzal a kérdéssel, amelyre mindegyikük válaszol.
| Metric | Képlet | Kérdés, amit megválaszol | Használd, amikor |
|---|---|---|---|
| Pontosság | (TP + TN) / (TP + TN + FP + FN) | Hány jóslat volt helyes összesen? | Az osztályok nagyjából kiegyensúlyozottak |
| Pontosság | TP / (TP + FP) | Amikor a modell pozitívat mond, milyen gyakran igaz? | A téves riasztások drágák |
| Visszahívás (érzékenység) | TP / (TP + FN) | Az összes valódi pozitívum közül hányat kaptak el? | A kihagyott pozitívumok drágák |
| sajátosság | TN / (TN + FP) | Az összes valódi negatívum közül hányat tisztáztak? | A negatív osztály is számít |
| F1 pontszám | 2 × (Pontosság × Visszahívás) / (Pontosság + Visszahívás) | Mi az egyensúly a kettő között? | Egy szám kell mindkettőhöz |
Vegyünk egy 100 e-mailen tesztelt spamszűrőt, amely TP = 45, FN = 5, FP = 10 és TN = 40 eredményeket produkál. A pontosság (45 + 40) / 100 = 0.85. A precizitás 45 / (45 + 10) = 0.82, a visszaemlékezés 45 / (45 + 5) = 0.90, a specificitás pedig 40 / (40 + 10) = 0.80. Az F1 pontszám 0.86.
Ezek a számok egy olyan történetet mesélnek el, amit egyetlen pontossági adat rejt: a szűrő a valódi spam 90 százalékát kiszűri, de minden ötödik megjelölt legitim e-mailt tévesen karanténba helyez. Az, hogy ez a csere elfogadható-e, az egyes hibák költségétől függ, ezért a mátrixot jelentik, nem pedig csak a pontosságot.
Zavart mátrix többosztályos osztályozáshoz
Az osztályozási problémák ritkán állnak meg két címkénél, és a mátrix alakváltozás nélkül skálázódik. N osztály esetén a táblázat N×N-es ráccsá válik: az átló tartalmazza az összes helyes előrejelzést, és minden átlón kívüli cella pontosan rögzíti, hogy melyik osztályt melyik másik osztállyal tévesztették össze.
Egy háromosztályos modell, amely a képeket macska, kutya és nyúl kategóriákba rendezi, egy 3×3-as rácsot hoz létre. Ha a „macska” sor „kutya” oszlopának cellája 12-t tartalmaz, akkor tizenkét macska képet jelöltünk kutyával. Ez a részletességi szint az oka annak, hogy a mátrix hasznosabb, mint egy pontszám: megnevezi azt a konkrét osztálypárt, amelyet a modell nem tud elválasztani.
A pontosság, a visszahívás és az F1 osztályonként van definiálva egy-egy-több nézet használatával, ahol a szóban forgó osztály a pozitív osztály, minden más pedig negatív. Az osztályonkénti adatokat ezután háromféleképpen kombináljuk:
- Makroátlag: Minden osztályhoz külön-külön számítja ki a metrikát, majd a súlyozatlan átlagot veszi. Minden osztály egyformán számít, így a ritka osztályok nem vesznek el a számításból.
- Mikroátlag: A metrika kiszámítása előtt összevonja a TP, FP és FN számokat az összes osztályban. A nagy osztályok dominálnak, és az egycímkés problémák esetén a mikropontosság, a mikrofelidézés és a pontosság azonos.
- Súlyozott átlag: Az egyes osztályok valódi példányainak számát súlyként használva átlagolja az osztályonkénti pontszámokat, ami láthatóvá teszi az osztályok egyensúlyhiányát.
Válassz makrót, ha minden osztály egyformán számít, és súlyozottat, ha az osztályeloszlás a valós forgalmat tükrözi.
Hogyan hozzunk létre egy zavart okozó mátrixot? Python
A scikit-learn függvénykönyvtár két címketömbből építi fel a teljes táblázatot, így nincs szükség manuális számlálásra. Az alábbi példa tíz valódi címkét hasonlít össze tíz predikcióval.
from sklearn.metrics import confusion_matrix

y_true = [1, 0, 1, 1, 0, 1, 0, 0, 1, 0]
y_pred = [1, 0, 1, 0, 0, 1, 1, 0, 1, 0]

cm = confusion_matrix(y_true, y_pred)
print(cm)
A hívás egy 2×2-es NumPy tömböt ad vissza, amelyben a 0. sor a tényleges negatív osztály, az 1. sor pedig a tényleges pozitív osztály:
[[4 1]
 [1 4]]
A tömb scikit-learn konvenció szerinti beolvasása a következő eredményeket adja: TN = 4 (bal felső sarok), FP = 1 (jobb felső sarok), FN = 1 (bal alsó sarok) és TP = 4 (jobb alsó sarok). Ha ezt a négy értéket egy sorban kicsomagoljuk, a térkép a következő lesz:ping kifejezett:
tn, fp, fn, tp = confusion_matrix(y_true, y_pred).ravel()
A pontosság, a visszahívás és az F1 függvény egyidejű eléréséhez minden osztályra, beleértve a fent leírt makro- és súlyozott átlagokat is, hívja meg a classification_report() ahelyett, hogy manuálisan kiszámítanánk az egyes mutatókat:
from sklearn.metrics import classification_report

print(classification_report(y_true, y_pred))
Egy ábrázolt változathoz, ConfusionMatrixDisplay.from_predictions(y_true, y_pred) ugyanazt a táblázatot jeleníti meg, mint egy címkézett hőtérképet. A teljes argumentumlista, beleértve a labels és a normalize opciók, dokumentálva vannak a scikit-learn confusion_matrix referenciaUgyanez az értékelési lépés vonatkozik a következővel készült modellekre is: TensorFlow, mivel a metrika csak az előre jelzett címkéktől függ.
Miért van szüksége Confusion mátrixra?
Íme a zavaró mátrix használatának előnyei és hátrányai.
- Megmutatja, hogyan válik zavarossá egy osztályozási modell, amikor előrejelzéseket tesz.
- A zavaros mátrix nemcsak az osztályozó által elkövetett hibákba ad betekintést, hanem a hibák típusaiba is.
- Ez a lebontás segít leküzdeni az osztályozási pontosság önmagában történő használatának korlátait.
- A konfúziós mátrix minden oszlopa az adott osztály példányait reprezentálja.
- A zavaros mátrix minden sora az aktuális osztály példányait reprezentálja.
- A modellértékelést diagnózissá alakítja, rámutatva arra az osztálypárra, amelyhez több adatra vagy jobb funkcióra van szükség.
Ez a diagnosztikai érték az oka annak, hogy a zavart keltő mátrix az értékelési szakasz középpontjában áll bármely adat-tudomány munkafolyamat, és hogy miért ez általában az első tábla, amelyet áttekintenek, mielőtt egy osztályozót éles környezetbe léptetnek elő.
