
Aggregátor transzformáció az informatikában példával
 Szerkesztőség
⚡ Okos összefoglaló
Az Informaticában az aggregátor transzformáció az az aktív objektum, amely olyan számításokat végez, mint az összegzés, az átlagolás és a darabszám egy sorcsoporton belül, és ezeket a sorokat egy összesített gyorsítótárban tárolja, amíg az egyes csoportok be nem fejeződnek.
Mi az aggregátor transzformáció?
Az aggregátor transzformáció egy aktív transzformáció, amely összesített számításokat végez, például összegzést, átlagolást és darabszámot.
Például, ha az összes alkalmazott fizetésének összegét szeretnéd kiszámolni részlegenként, használhatod az Aggregátor transzformációt.
Az összesített műveletek egy sorcsoporton keresztül kerülnek végrehajtásra, ezért az összes rekord tárolásához és a számítások elvégzéséhez ideiglenes helyőrzőre van szükség.
Erre az aggregátor gyorsítótárát használják. Ez egy ideiglenes fő memória, amelyet az Aggregátor transzformáció számára foglalnak le az ilyen műveletek végrehajtásához, és két részben tárolódik: az index gyorsítótár a csoportértékeket, míg az adat gyorsítótár az aggregált soradatokat tárolja.
Az átalakítás azért aktív, mert megváltoztatja a folyamatban lévő sorok számát. Több ezer alkalmazotti rekord kerülhet be, és részlegenként csak egy sor távozik belőle.
Az aggregátor transzformáció használata Informaticában
Ebben a példában a fizetések összegét fogjuk kiszámítani osztályonként. Ehhez új oszlopra van szükségünk ennek az összegnek a tárolására. Tehát mindenekelőtt egy új rovatot készítünk.
Step 1) Hozz létre egy új adatbázis-céltáblát, például a „sum_sal_deptwise”-t az alábbi szkript segítségével. Látni fogod, hogy az új adatbázis-céltábla a következő alatt jön létre: Targets mappát a következő lépésben.
Töltse le a fenti Create_table_sal_deptwise.txt fájlt
Step 2) Újat csinálni térképping „m_összeg_mélységben”.
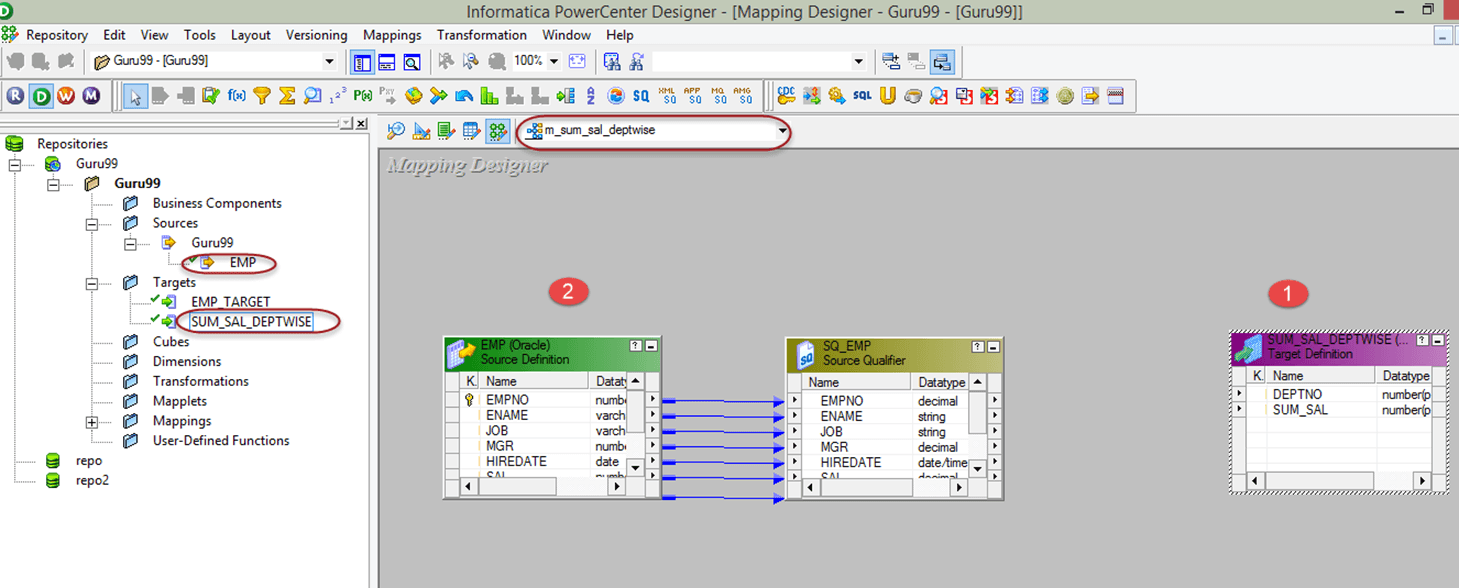
Az új térkép elkészítéséhezping, szükségünk van a forrástáblára (EMP) és a céltáblára (sum_sal_deptwise) a Map-benping Tervező, tehát nekünk kell
- Importálja a „sum_sal_deptwise” céltáblát a térképbeping.
- Importálja az „emp” forrástáblát.
Mindkét definíció megjelenik a vásznon, ahogy az alább látható.
Step 3) A térképenping,
- Tól Forrás minősítő, törölje az empno, ename, job, mgr, hiredate és comm oszlopokat, csak a deptno és sal oszlopokat hagyja meg.
- Hozz létre egy új Aggregator transzformációt az eszköztár menüjének segítségével, ahogy a képernyőképen látható. Amikor az aggregator ikonra kattintasz, egy új Aggregator transzformáció jön létre.
Az új AGGTRANS objektum a levágott forrásminősítő mellett jelenik meg.

Step 4) Húzd át a SAL és DEPTNO oszlopokat a Source Qualifier (SQ_EMP) transzformációból az Aggregator transzformációba. A két port most már össze van kapcsolva az AGGTRANS-szal.

Step 5) Double-kattintson az Aggregator transzformációra a tulajdonságainak megnyitásához, majd
- Adjon hozzá egy új portot az átalakításhoz
- Nevezd át a portot SUM_SAL-ra
- Módosítsa az új port adattípusát duplájára
- Tegye ezt a portot kimeneti porttá a kimeneti port jelölőnégyzetének bejelölésével.
- Kattintson a kifejezés lehetőségre
A Portok fül mostantól a SAL, a DEPTNO és az új SUM_SAL kimeneti portot tartalmazza.

Step 6) A Kifejezésszerkesztő ablakban
- Add hozzá a sum(SAL) kifejezést; ezt a kifejezést magadnak kell megírnod.
- Válassza az OK gombot, ezzel visszahozza az Átalakítások szerkesztése ablakot.
A Kifejezésszerkesztő megjeleníti a SUM_SAL-hoz rendelt összesítő kifejezést.

Step 7) Az Átalakítások szerkesztése ablakban jelölje be a „Csoportosítás” lehetőséget a részlegszám oszlop melletti jelölőnégyzet bejelölésével, majd kattintson az OK gombra. A részlegszám szerinti csoportosítás kiválasztásával utasítjuk az Informaticát, hogy a fizetéseket részlegszám szerint csoportosítsa.

Step 8) Kapcsolja össze az Aggregator transzformációból származó deptno és sum_sal oszlopokat a céltáblával. A térképping ezután a forrástól a célig teljes.

Most mentsd el a térképetping és hajtsa végre egy új létrehozása után ülés ehhez a térképhezpingA céltábla az osztályonkénti fizetések összegét tartalmazná. Így az Aggregátor transzformációval kiszámíthatjuk az összesített eredményeket.
Csoportosítás portok szerint az Aggregator transzformációban
A fenti lépés egyetlen portot jelölt meg Csoportosítás szerint (Group By), ami a vállalat egészére kiterjedő összesítést részlegenkénti összeggé alakította. Bármely bemeneti, bemeneti/kimeneti, kimeneti vagy változó port ugyanígy megjelölhető.
Három szabály szabályozza az eredményhalmazt:
- Csoportonként egy sor. Az értékek csoportosításakor az integrációs szolgáltatás a csoport minden egyes portonkénti egyedi kombinációjához egy sort hoz létre.
- Nincs csoportosítás, egy sor. Ha nincs megjelölve port, a teljes bemenetet egyetlen csoportként kezeli a rendszer, és az összes bemeneti sorhoz egyetlen sort ad vissza.
- Az utolsó sor nyer. Az összesített eredmény mellett az Integrációs Szolgáltatás általában átadja a csoportban fogadott utolsó sort is, kivéve, ha egy olyan függvény, mint például a FIRST, egy másik sort nevez meg.
Ahol több kikötő van megjelölve, a kikötők sorrendje határozza meg a területet.ping sorrend, és a sorrend megváltoztathatja az eredményt. Csoportping a DEPTNO által, majd a JOB nem ugyanaz, mint a grouping a JOB, majd a DEPTNO szerint, mivel a második oszlop értékei nem feltétlenül egyediek.
Aggregátor transzformációs tulajdonságai
Az Átalakítások szerkesztése ablak Tulajdonságok lapján találhatók azok a beállítások, amelyek meghatározzák, hogy hol található a gyorsítótár, és mennyit használunk belőle. Az alábbi táblázat felsorolja ezeket.
| Beállítás | Mit szabályoz |
|---|---|
| Gyorsítótár könyvtár | Helyi könyvtár, amelyben az Integrációs szolgáltatás létrehozza az index- és adatgyorsítótár-fájlokat. Az alapértelmezett érték a Workflow Managerben beállított $PMCacheDir folyamatváltozó. |
| Tracszint | A munkamenet-naplóba írt részletek mennyisége ehhez az átalakításhoz. |
| Rendezett bemenet | Deklarálja, hogy a bejövő adatok már portok szerinti csoportosításban vannak rendezve. Csak akkor válassza ki, ha a térkép...ping valóban rendezett adatokat szolgáltat. |
| Összesítő adatgyorsítótár mérete | Az adatgyorsítótár mérete. Az alapértelmezett érték 2 000 000 bájt, az Automatikus beállítás pedig lehetővé teszi az Integrációs szolgáltatás számára a méretezést. |
| Aggregátor index gyorsítótár mérete | Az index gyorsítótárának mérete. Az alapértelmezett érték 1 000 000 bájt, az Automatikus beállítás pedig lehetővé teszi az Integrációs szolgáltatás számára a méretezést. |
| Átalakítási hatókör | A logikát minden egyes tranzakcióra, vagy az összes bejövő adatra alkalmazza. Az „Összes bemenet” opció elveti a bejövő tranzakciók határait. |
Ha az inkrementális összesítés engedélyezve van, az integrációs szolgáltatás minden futtatáskor biztonsági másolatot készít a gyorsítótárfájlokról, így a gyorsítótár könyvtárának két fájlkészletet kell tartalmaznia egy helyett.
Összesített kifejezések szabályai és teljesítménytippek
Egy aggregált kifejezés kombinálhat egy aggregált függvényt feltételes és nem aggregált függvényekkel, ami lehetővé teszi a feltételes összegzéseket és darabszámokat egy porton belül. Két szabály korlátozza, hogy mi írható le.
- Egy fészkelési szint. Csak egy összesítő függvény ágyazható be egy másikba, és a belső kifejezés kiértékelése történik először.
- Nincs keverés. Egy transzformáció tartalmazhat egyszintű függvényeket vagy beágyazott függvényeket, soha nem mindkettőt. Ha mindkettőt tartalmazza, a Tervező megjelöli a térképet.ping érvénytelen, ezért oszd fel a logikát két Aggregátor transzformációra.
A hangolás terén három beállítás végzi a munka nagy részét:
- Rendezett bemenet. Amikor a sorok portok szerinti csoportosításban rendezve érkeznek meg, minden csoport felszabadítható, amint az utolsó sora megérkezik, így sokkal kevesebb adat kerül gyorsítótárba, és a munkamenet gyorsabban fut. A rendezett bemenet nem kombinálható növekményes aggregációval.
- Inkrementális aggregáció. Az új forrássorok áthaladnak a térképen.ping és az előzmények újraszámítása helyett a történelmi gyorsítótárral kombinálva, ami egy éjszakai betöltést tesz lehetővé egy futó összesítésben.
- Szűrd korán. Azokat a sorokat, amelyek soha nem járulnak hozzá az összegzéshez, az Aggregator előtt kell eldobni, akár a Forrásminősítő lekérdezésben, akár egy Szűrőátalakítás, mivel minden sor, amely eléri az Aggregátort, gyorsítótár memóriát igényel. Ez az egyik szabványos ellenőrzés a folyamat során teljesítmény növelés.
