
ANOVA u R-u: Jednosmjerni i dvosmjerni test s primjerima
 Uredništvo
⚡ Pametni sažetak
ANOVA u R-u uspoređuje srednje vrijednosti triju ili više skupina dijeljenjem ukupne varijacije na komponente između skupina i unutar skupina. Ovaj vodič provodi jednosmjerne i dvosmjerne testove na skupu podataka o otrovima, provjerava pretpostavke i izolira različite parove pomoću Tukey HSD-a.
Što je ANOVA?
Analiza varijance (ANOVA) je statistička tehnika koja se koristi za usporedbu srednjih vrijednosti dviju ili više skupina. Test funkcionira tako da ukupnu varijaciju u mjerenju podijeli na dio objašnjen pripadnošću skupini i dio koji ostaje kao slučajni šum. ANOVA u R-u stoga govori razlikuje li se barem jedna srednja vrijednost skupine od ostalih, a ne koja. To je izravno proširenje t-test na situacije u kojima faktorska varijabla ima više od dvije razine.
Prije pokretanja testa, korisno je znati koji član ANOVA obitelji odgovara vašem dizajnu.
Vrste ANOVA testova u R-u
„ANOVA“ je skup testova, a ne jedan postupak. Odabir pravog člana ovisi o tome koliko faktora imate i kako su podaci prikupljeni.
| test | Kada ga koristiti | R poziv |
|---|---|---|
| Jednosmjerna ANOVA | Jedan faktor s tri ili više razina | aov(y ~ x, podaci = df) |
| Dvosmjerna ANOVA | Dva neovisna faktora | aov(y ~ x1 + x2, podaci = df) |
| Dvosmjerno s interakcijom | Učinak jednog faktora ovisi o drugom | aov(y ~ x1 * x2, podaci = df) |
| ANOVA s ponovljenim mjerenjima | Isti subjekti mjereni su više puta | aov(y ~ x + Pogreška(subjekt/x)) |
| ANKOVA | Kontinuirana kovarijanta mora se kontrolirati za | aov(y ~ x + kovarijanta, podaci = df) |
| MANOVA | Dvije ili više varijabli odgovora odjednom | manova(cbind(y1, y2) ~ x) |
Ovaj vodič pokriva prve tri. Preostale varijante koriste isto aov() sučelje, tako da kada jednom možete pročitati jednu izlaznu tablicu, možete ih pročitati sve.
ANOVA vs T-test u R: Ključne razlike
Oba testa uspoređuju srednje vrijednosti, stoga je vrijedno biti precizan oko toga gdje jedan zamjenjuje drugi.
| Kriteriji | T-test | ANOVA |
|---|---|---|
| Broj grupa | Točno dva | Dvije ili više |
| Statistika testa | t | F, jednako t na kvadrat kada postoje dvije grupe |
| Proizlaziti | Imenuje smjer razlike | Samo izvještava da postoji razlika |
| Potrebno je praćenje | nijedan | Post hoc test kao što je Tukey HSD |
| R funkcija | t.test() | aov() |
S tri grupe, iskušenje je provesti tri odvojena t-testa. Oduprite se tome. Svaki test nosi vlastitu stopu pogreške od 5 posto, pa tri usporedbe povećavaju vjerojatnost lažno pozitivnog rezultata na otprilike 14 posto. ANOVA odgovara na isto pitanje jednim testom, a Tukey HSD zatim obrađuje detalje parova s kontroliranom stopom pogreške. Za slučaj dvije grupe, pogledajte vodič za t-test.
Jednosmjerna ANOVA
Postoje mnoge situacije u kojima trebate usporediti srednju vrijednost između više skupina. Na primjer, odjel marketinga želi znati imaju li tri tima isti prodajni učinak.
- Tim: faktor 3 razine: A, B i C
- Prodaja: mjera uspješnosti
ANOVA test može pokazati imaju li tri skupine slične performanse.
Da biste razjasnili dolaze li podaci iz iste populacije, možete izvesti a jednosmjerna analiza varijance (u daljnjem tekstu jednosmjerna ANOVA). Kao i svaki drugi statistički test, daje dokaze o tome može li se H0 hipoteza odbaciti. Imajte na umu da neodbacivanje H0 nije isto što i dokazivanje njezine istinitosti.
Hipoteza u jednosmjernom ANOVA testu
- H0: Srednje vrijednosti između skupina su identične
- H1: Barem je srednja vrijednost jedne skupine različita
Drugim riječima, ako se H0 ne odbaci, nema dovoljno dokaza za zaključak da se bilo koja srednja vrijednost grupe razlikuje od ostalih.
Ovaj test je sličan t-testu, ali ANOVA je ispravan izbor kada postoji više od dvije grupe. S točno dvije grupe, dva testa su ekvivalentna i F-statistika je jednaka kvadratu t-statistike.
Pretpostavke
Jednosmjerna ANOVA temelji se na tri uvjeta: opažanja su nasumično uzorkovana i neovisna jedno o drugome, reziduali unutar svake skupine su približno normalno raspoređeni, a varijanca je ista u svakoj skupini (homogenost varijance). Odjeljak o provjeri pretpostavki u nastavku pokazuje kako testirati svaku od njih u R-u.
Interpretirajte ANOVA test
F-statistika se koristi za testiranje jesu li podaci iz značajno različitih populacija, tj. različite srednje vrijednosti uzorka.
Da biste izračunali F-statistiku, trebate podijeliti varijabilnost između grupa nad varijabilnost unutar grupe.
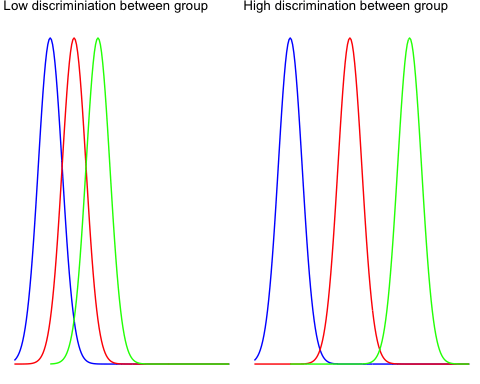
The među-skupina Varijabilnost odražava koliko se srednja vrijednost svake grupe razlikuje od ukupne srednje vrijednosti. Usporedite dva grafa u nastavku kako biste bolje shvatili o čemu se radi.
Lijevi graf pokazuje vrlo male varijacije između triju skupina, tako da su sve tri skupine srednje vrijednosti blizu ukupni znače.
Desni graf prikazuje tri daleko udaljene distribucije bez preklapanja, tako da je jaz između ukupnog prosjeka i prosjeka svake skupine velik.
The unutar grupe Varijabilnost mjeri koliko se pojedinačna opažanja razlikuju od prosjeka vlastite skupine. Neke se točke nalaze daleko od prosjeka svoje skupine, a izraz unutar skupine obuhvaća upravo taj raspon, što je pogreška uzorkovanja.
Kako biste vizualno razumjeli koncept varijabilnosti unutar grupe, pogledajte grafikon u nastavku.
Lijevi dio prikazuje distribuciju triju različitih skupina. Povećali ste raspon svakog uzorka i jasno je da je individualna varijanca velika. F-statistika pada, tako da ne biste mogli odbaciti nultu hipotezu.
Desni dio prikazuje uzorke s istim srednjim vrijednostima, ali puno manjim rasponom. To povećava F-statistiku i ukazuje u korist alternativne hipoteze.

Možete koristiti obje mjere za konstruiranje F-statistike. Vrlo je intuitivno razumjeti F-statistiku. Ako se brojnik povećava, to znači da je varijabilnost među grupama velika i da je vjerojatno da su grupe u uzorku izvučene iz potpuno različitih distribucija.
Drugim riječima, niska F-statistika ukazuje na malu ili nikakvu značajnu razliku između prosjeka grupe.
Primjer Jednosmjerni ANOVA test
Koristit ćete skup podataka o otrovu za provedbu jednosmjernog ANOVA testa. Skup podataka sadrži 48 redaka i 3 varijable:
- Vrijeme: Vrijeme preživljavanja životinje
- otrov: vrsta korištenog otrova: razina faktora: 1,2 i 3
- liječiti: Vrsta korištenog tretmana: razina faktora: 1,2 i 3
Prije nego počnete izračunavati ANOVA test, morate pripremiti podatke na sljedeći način:
- Korak 1: Uvezite podatke
- Korak 2: Uklonite nepotrebnu varijablu
- Korak 3: Pretvorite varijablu otrov u naručenu razinu
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/poisons.csv"
df <- read.csv(PATH) %>%
select(-X) %>%
mutate(poison = factor(poison, ordered = TRUE))
glimpse(df)
Izlaz:
## Observations: 48
## Variables: 3
## $ time   <dbl> 0.31, 0.45, 0.46, 0.43, 0.36, 0.29, 0.40, 0.23, 0.22, 0...
## $ poison <ord> 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 1, 1, 1, 1, 2, 2, 2...
## $ treat  <fctr> A, A, A, A, A, A, A, A, A, A, A, A, B, B, B, B, B, B, ...
Naš cilj je testirati sljedeću pretpostavku:
- H0: Nema razlike u prosjeku vremena preživljavanja između skupina
- H1: Prosjek vremena preživljavanja je različit za barem jednu skupinu.
Drugim riječima, želite znati postoji li statistička razlika između srednjeg vremena preživljavanja ovisno o vrsti otrova koji je dan zamorcu.
Postupit ćete na sljedeći način:
- Korak 1: Provjerite format varijable poison
- Korak 2: Ispišite sumarnu statistiku: broj, srednju vrijednost i standardnu devijaciju
- Korak 3: Iscrtajte okvirni dijagram
- Korak 4: Izračunajte jednosmjerni ANOVA test
- Korak 5: Pokrenite parnu usporedbu s Tukey HSD-om
Korak 1) Provjerite razine otrova pomoću donjeg koda. Trebali biste vidjeti trostruke vrijednosti jer je glagol mutate pretvorio stupac u uređeni faktor.
levels(df$poison)
Izlaz:
## [1] "1" "2" "3"
Korak 2) Vi izračunavate srednju vrijednost i standardnu devijaciju.
df %>%
	group_by(poison) %>%
	summarise(
		count_poison = n(),
		mean_time = mean(time, na.rm = TRUE),
		sd_time = sd(time, na.rm = TRUE)
	)
Izlaz:
##
# A tibble: 3 x 4
##   poison count_poison mean_time    sd_time
##    <ord>        <int>     <dbl>      <dbl>
## 1      1           16  0.617500 0.20942779
## 2      2           16  0.544375 0.28936641
## 3      3           16  0.276250 0.06227627
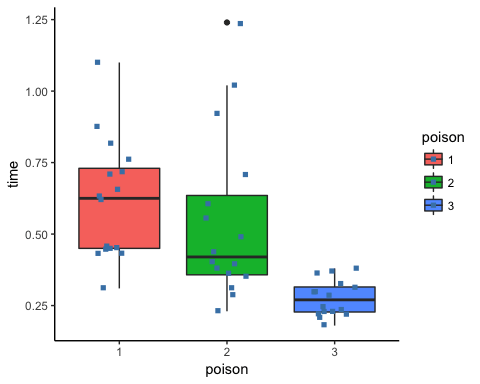
Korak 3) U trećem koraku možete grafički provjeriti postoji li razlika između distribucije. Imajte na umu da ste uključili potresnu točku.
ggplot(df, aes(x = poison, y = time, fill = poison)) +
    geom_boxplot() +
    geom_jitter(shape = 15,
        color = "steelblue",
        position = position_jitter(0.21)) +
    theme_classic()
Izlaz:
Korak 4) Možete pokrenuti jednosmjerni ANOVA test s naredbom aov. Osnovna sintaksa za ANOVA test je:
aov(formula, data)
Arguments:
- formula: The equation you want to estimate
- data: The dataset used
Sintaksa formule je:
y ~ X1+ X2+...+Xn # X1 +  X2 +... refers to the independent variables
y ~ . # use all the remaining variables as independent variables
Sada možete odgovoriti na pitanje: postoji li razlika u vremenu preživljavanja između zamoraca, s obzirom na vrstu primijenjenog otrova?
Pohranite model u objekt i proslijedite ga funkciji summary() kako biste dobili čitljiv ispis rezultata.
anova_one_way <- aov(time~poison, data = df)
summary(anova_one_way)
Code Objašnjenje
- aov(vrijeme ~ otrov, podaci = df): Pokrenite ANOVA test sa sljedećom formulom
- summary(anova_one_way): Ispis sažetka testa
Izlaz:
##             Df Sum Sq Mean Sq F value   Pr(>F)
## poison       2  1.033  0.5165   11.79 7.66e-05 ***
## Residuals   45  1.972  0.0438
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
P-vrijednost je 7.66e-05, daleko ispod uobičajenog praga od 0.05, a tri zvjezdice označavaju najjači kod značajnosti. Možete odbaciti H0 i zaključiti da barem jedna skupina otrova ima drugačije prosječno vrijeme preživljavanja.
Kako provjeriti ANOVA pretpostavke u R-u
ANOVA p-vrijednost je pouzdana samo kada su ispunjena tri prethodno navedena uvjeta. Svaki od njih ima izravnu provjeru u R-u i svi se izvode na prilagođenom objektu modela.
1. Neovisnost opažanja. Ovo je svojstvo dizajna studije, a ne podataka, tako da nijedan test to ne može spasiti. Svaki zamorac mora se izmjeriti jednom i nasumično dodijeliti svojoj skupini. Ako se isti subjekt pojavljuje u nekoliko redaka, potreban vam je model ponovljenih mjerenja.
2. Normalnost reziduala. ANOVA pretpostavlja da su reziduali, a ne sirovi podaci, približno normalni. Pregledajte QQ dijagram i potvrdite Shapiro-Wilkovim testom:
par(mfrow = c(2, 2))
plot(anova_one_way)          # four diagnostic plots

shapiro.test(residuals(anova_one_way))
Točke koje grane s dijagonalom normalnog QQ dijagrama označavaju normalne reziduale. Shapiro-Wilkova p-vrijednost iznad 0.05 znači da se normalnost ne može odbaciti.
3. Homogenost varijance. Svaka grupa trebala bi pokazati sličan raspon. Grafik ostataka u odnosu na prilagođene vrijednosti trebao bi izgledati kao ravna traka, a ne kao lijevak. Potvrdite to Leveneovim testom, koji je robusniji na nenormalnosti od Bartlettovog:
library(car)
leveneTest(time ~ poison, data = df)

bartlett.test(time ~ poison, data = df)
P-vrijednost iznad 0.05 podržava jednake varijance.
Što učiniti kada pretpostavka ne uspije. Ako su varijance nejednake, pokrenite oneway.test(time ~ poison, data = df, var.equal = FALSE), Welchovu korekciju. Ako su reziduali očito nenormalni i uzorak je malen, prebacite se na Kruskal-Wallisov test rangova, kruskal.test(time ~ poison, data = df). Kod velikih uravnoteženih uzoraka, ANOVA je prilično robusna do umjerenih odstupanja od normalnosti, tako da je granični Shapiro-Wilkov rezultat rijetko koban.
Usporedba u paru
Značajan F-test govori da srednje vrijednosti grupe nisu sve jednake, ali ne i koji se par razlikuje. Tukeyjev test iskrenih značajnih razlika odgovara na to uspoređujući svaki par, kontrolirajući stopu pogreške na razini obitelji.
TukeyHSD(anova_one_way)
Izlaz:

Pročitajte izlazni redak po paru. razl stupac sadrži razliku između dvaju grupnih prosjeka, niska temperatura i licenca ograničili 95-postotni interval pouzdanosti za tu razliku i prid. je p-vrijednost prilagođena za višestruke usporedbe. Par se značajno razlikuje kada njegov interval isključuje nulu, što je ekvivalentno kada je p adj ispod 0.05. U ovom skupu podataka, usporedbe koje uključuju otrov 3 su značajne, što odgovara kutijastom dijagramu: skupina 3 ima jasno niže prosječno vrijeme preživljavanja od skupina 1 i 2, dok su skupine 1 i 2 statistički nerazlučive jedna od druge.
Dvosmjerna ANOVA
Dvosmjerna ANOVA dodaje drugi faktor formuli. Funkcionira potpuno isto kao i jednosmjerni test, samo se formula mijenja:
y ~ x1 + x2
Ovdje je y kvantitativna varijabla odgovora, dok su x1 i x2 kategorički faktori.
Hipoteza u dvosmjernom ANOVA testu
- H0: Grupne sredine su jednake za obje faktorske varijable
- H1: Barem jedna srednja vrijednost grupe razlikuje se za barem jedan od dva faktora
Modelu dodajete varijablu tretmana. Ova varijabla bilježi tretman koji je dan zamorcu. Aditivna formula u nastavku testira utječe li svaki faktor samostalno na vrijeme preživljavanja, nakon što se uzmu u obzir ostali.
Prilagodite kod dodavanjem riječi "treat" uz prvu nezavisnu varijablu.
anova_two_way <- aov(time~poison + treat, data = df)
summary(anova_two_way)
Izlaz:
##             Df Sum Sq Mean Sq F value  Pr(>F)
## poison       2 1.0330  0.5165   20.64 5.7e-07 ***
## treat        3 0.9212  0.3071   12.27 6.7e-06 ***
## Residuals   42 1.0509  0.0250
## ---
Obje p-vrijednosti (5.7e-07 za otrov i 6.7e-06 za tretman) su daleko ispod 0.05, pa odbacujete H0 za oba faktora i zaključujete da promjena otrova ili tretmana utječe na vrijeme preživljavanja.
Dodavanje interakcijskog pojma
Gornji aditivni model pretpostavlja da je učinak otrova isti bez obzira na tretman. Kako bismo testirali tu pretpostavku, zamijenite znak plus zvjezdicom, što odgovara i glavnim učincima i njihovoj interakciji:
anova_interaction <- aov(time~poison * treat, data = df)
summary(anova_interaction)
Ako redak otrov:treat nije značajan, aditivni model je bolji izbor jer troši manje stupnjeva slobode.
ANOVA u R-u: Brzi vodič za testiranje
U donjoj tablici navedeni su svi gore korišteni testovi, R pozivi koji ih pokreću i hipoteze koje procjenjuju:
| test | Code | hipoteza | P-vrijednosti |
|---|---|---|---|
| Jednosmjerna ANOVA |
aov(y ~ X, data = df)
|
H1: Prosjek je različit za barem jednu grupu | 0.05 |
| U paru |
TukeyHSD(ANOVA summary) |
0.05 | |
| Dvosmjerna ANOVA |
aov(y ~ X1 + X2, data = df)
|
H1: Barem jedna srednja vrijednost grupe razlikuje se za bilo koji faktor | 0.05 |
