
Višestruka linearna regresija u R-u: jednostavna i postupna s primjerima
 Evelyn Clarke
⚡ Pametni sažetak
Jednostavna i višestruka linearna regresija u R-u modeliraju kontinuirani ishod kao ponderirani zbroj prediktora prilagođenih metodom običnih najmanjih kvadrata. Ovaj vodič pokriva lm(), očitavanje koeficijenata, prediktore faktora, dijagnostiku reziduala, predviđanje i automatski odabir varijabli.
Gdje se linearna regresija uklapa u strojno učenje
Linearna regresija jedna je od najstarijih nadziranih regresija. stroj za učenje algoritmi, i to je još uvijek prvi model za kojim većina analitičara poseže. Jedna od najranijih primjena strojnog učenja bila je filtar za neželjenu poštu.
Druge uobičajene primjene strojnog učenja uključuju:
- Identifikacija neželjenih spam poruka u e-pošti
- Segmentacija ponašanja kupaca za ciljano oglašavanje
- Smanjenje lažnih transakcija kreditnim karticama
- Optimizacija korištenja energije u domovima i poslovnim zgradama
- prepoznavanje lica
Nadzirano učenje
In Nadzirano učenje, podaci o obuci koje unesete u algoritam uključuju oznaku.
Klasifikacija je vjerojatno najkorištenija tehnika nadziranog učenja. Jedan od prvih zadataka klasifikacije kojim su se istraživači bavili bio je filter neželjene pošte. Cilj učenja je predvidjeti je li e-pošta klasificirana kao neželjena pošta ili ham (dobra e-pošta). Stroj, nakon koraka obuke, može prepoznati klasu e-pošte.
Regresije se često koriste u području strojnog učenja za predviđanje kontinuirane vrijednosti. Regresijski zadatak može predvidjeti vrijednost zavisna varijabla na temelju skupa neovisne varijable (također se nazivaju prediktori ili regresori). Na primjer, linearna regresija može predvidjeti cijenu dionice, vremensku prognozu, prodaju i tako dalje.
Neki osnovni algoritmi nadziranog učenja su:
- Linearna regresija
- Logistička regresija
- Najbliži susjedi
- Support Vector Machine (SVM)
- Stabla odlučivanja i slučajna šuma
- Neuronske mreže
Učenje bez nadzora
In Učenje bez nadzora, podaci o obuci nisu označeni. Sustav pokušava učiti bez reference. Dolje je popis algoritama učenja bez nadzora.
- K-srednja vrijednost
- hijerarhijski Cluster Analiza
- Maksimiziranje očekivanja
- Vizualizacija i smanjenje dimenzionalnosti
- Analiza glavne komponente
- Kernel PCA
- Lokalno-linearno ugrađivanje
S tim kontekstom na mjestu, ostatak ovog tutorijala korak po korak gradi regresijske modele u R-u.
Jednostavna linearna regresija u R
Linearna regresija odgovara na jednostavno pitanje: možete li izmjeriti točan odnos između jedne ciljne varijable i skupa prediktora?
Najjednostavniji probabilistički model je model linearne linije:

gdje
- y = Zavisna varijabla
- x = Nezavisna varijabla
-
 = komponenta slučajne pogreške
-
 = presresti
-
 = Koeficijent x
Razmotrite sljedeći zaplet:
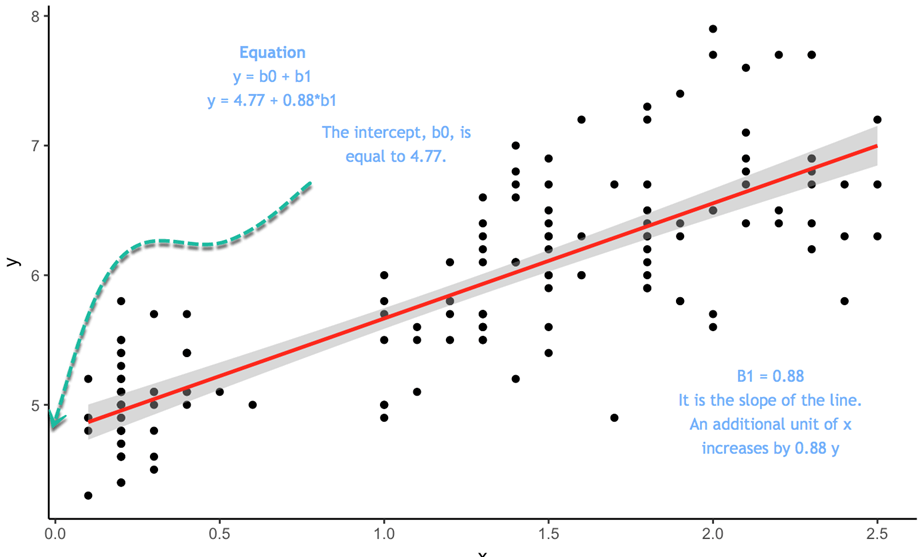
Jednadžba je 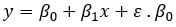 U ovoj jednadžbi odsječak na osi je 4.77, pa kada je x jednak 0, prilagođena vrijednost y je 4.77. Nagib vam govori u kojem omjeru se y mijenja kada se x mijenja.
Za procjenu optimalnih vrijednosti  i
 , koristite metodu tzv Obični najmanji kvadrati (OLS). Ova metoda pokušava pronaći parametre koji minimiziraju zbroj kvadrata pogrešaka, odnosno okomitu udaljenost između predviđenih vrijednosti y i stvarnih vrijednosti y. Razlika je poznata kao termin pogreške.
Prije nego što procijenite model, možete odrediti je li linearni odnos između y i x moguć iscrtavanjem dijagrama raspršenja.
Dijagram raspršenosti
Koristit ćemo vrlo jednostavan skup podataka kako bismo objasnili koncept jednostavne linearne regresije. Uvest ćemo prosječne visine i težine za američke žene. Skup podataka sadrži 15 opažanja. Želite izmjeriti jesu li visine u pozitivnoj korelaciji s težinama.
library(ggplot2)
path <- 'https://raw.githubusercontent.com/guru99-edu/R-Programming/master/women.csv'
df <-read.csv(path)
ggplot(df,aes(x=height, y =  weight))+
geom_point()
Izlaz:

Dijagram raspršenja sugerira opću tendenciju povećanja težine s povećanjem visine. U sljedećem koraku mjerit ćete za koliko se težina povećava za svaku dodatnu jedinicu visine.
Procjene najmanjih kvadrata
U jednostavnoj OLS regresiji, izračun od  i je jednostavan. Ovaj vodič ne izvodi formule, već ih samo navodi.
Želite procijeniti: 
Cilj OLS regresije je minimizirati sljedeću jednadžbu:

gdje
 je stvarna vrijednost i
 je predviđena vrijednost.
Rješenje za is 
Imajte na umu da  znači prosječnu vrijednost x
Rješenje za  is

U R-u možete koristiti funkcije cov() i var() za procjenu a za procjenu možete koristiti funkciju mean(). 
beta <- cov(df$height, df$weight) / var (df$height)
beta
Izlaz:
##[1] 3.45
alpha <- mean(df$weight) - beta * mean(df$height)
alpha
Izlaz:
## [1] -87.51667
Beta koeficijent implicira da se za svaki dodatni centimetar visine prosječna težina povećava za 3.45 funti.
Ručna procjena linearne jednadžbe je poučna, ali nepraktična. R pruža funkciju lm() koja to radi umjesto vas, a koristit ćete je od sljedećeg odjeljka nadalje. U stvarnim projektima gotovo nikada nećete prilagoditi model s jednim prediktorom; regresijski zadaci obično uključuju mnogo estimatora odjednom.
Višestruka linearna regresija u R
Praktične primjene regresijske analize koriste modele složenije od jednostavnog linearnog modela. Probabilistički model koji uključuje više od jedne nezavisne varijable naziva se višestruki regresijski modeli. Opći oblik ovog modela je:

U matričnom zapisu, možete prepisati model:

Zavisna varijabla y sada je funkcija k nezavisnih varijabli. Vrijednost koeficijenta  određuje doprinos nezavisne varijable
 i .
Ukratko predstavljamo pretpostavku koju smo napravili o slučajnoj pogrešci  OLS-a:
- Srednja vrijednost jednaka 0
- Varijanca jednaka

- Normalna distribucija
- Slučajne pogreške su neovisne (u vjerojatnosnom smislu)

Morate riješiti za , vektor regresijskih koeficijenata koji minimiziraju zbroj kvadrata pogrešaka između predviđenih i stvarnih y vrijednosti.
Rješenje zatvorenog oblika je:

s:
- označava prenositi matrice X
 označava invertibilna matrica
 označava invertibilna matrica
Primjeri u nastavku koriste ugrađeni skup podataka mtcars. Cilj je predvidjeti potrošnju goriva u miljama po galonu (mpg) iz skupa značajki.
Kontinuirane varijable u R
Za sada ćete koristiti samo kontinuirane varijable i ostaviti po strani kategoričke značajke. Varijabla am je binarna varijabla koja ima vrijednost 1 ako je mjenjač ručni i 0 za automatske automobile; vs je također binarna varijabla.
library(dplyr)
df <- mtcars %>%
select(-c(am, vs, cyl, gear, carb))
glimpse(df)
Izlaz:
## Observations: 32
## Variables: 6
## $ mpg  <dbl> 21.0, 21.0, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19....
## $ disp <dbl> 160.0, 160.0, 108.0, 258.0, 360.0, 225.0, 360.0, 146.7, 1...
## $ hp   <dbl> 110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, ...
## $ drat <dbl> 3.90, 3.90, 3.85, 3.08, 3.15, 2.76, 3.21, 3.69, 3.92, 3.9...
## $ wt   <dbl> 2.620, 2.875, 2.320, 3.215, 3.440, 3.460, 3.570, 3.190, 3...
## $ qsec <dbl> 16.46, 17.02, 18.61, 19.44, 17.02, 20.22, 15.84, 20.00, 2...
Za izračunavanje parametara možete koristiti funkciju lm(). Osnovna sintaksa ove funkcije je:
lm(formula, data, subset)
Arguments:
	-formula: The equation you want to estimate
	-data: The dataset used
	-subset: Estimate the model on a subset of the dataset
Zapamtite da je jednadžba sljedećeg oblika

u R
- Simbol = zamjenjuje se sa ~
- Svaki x zamijenjen je imenom varijable
- Ako želite izbaciti konstantu, dodajte -1 na kraju formule
Primjer:
Želite procijeniti težinu pojedinaca na temelju njihove visine i prihoda. Jednadžba je

Jednadžba u R je napisana na sljedeći način:
y ~ X1+ X2+…+Xn # S presjekom
Dakle, za naš primjer:
- Vagati ~ visina + prihod
Vaš cilj je procijeniti milju po galonu na temelju niza varijabli. Jednadžba za procjenu je:

Procijenit ćete svoju prvu linearnu regresiju i pohraniti rezultat u fit objekt.
model <- mpg ~ disp + hp + drat + wt + qsec
fit <- lm(model, df)
fit
Code Objašnjenje
- model <- mpg ~ disp + hp + drat + wt + qsec: Pohrani model za procjenu
- lm(model, df): Procijenite model s okvirom podataka df
##
## Call:
## lm(formula = model, data = df)
##
## Coefficients:
## (Intercept)         disp           hp         drat           wt
##    16.53357      0.00872     -0.02060      2.01577     -4.38546
##        qsec
##     0.64015
Izlaz ne pruža dovoljno informacija o kvaliteti pristajanja. Pomoću funkcije summary() možete pristupiti više detalja kao što su značaj koeficijenata, stupanj slobode i oblik reziduala.
summary(fit)
Izlaz:
## return the p-value and coefficient
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5404 -1.6701 -0.4264  1.1320  5.4996
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 16.53357   10.96423   1.508  0.14362
## disp         0.00872    0.01119   0.779  0.44281
## hp          -0.02060    0.01528  -1.348  0.18936
## drat         2.01578    1.30946   1.539  0.13579
## wt          -4.38546    1.24343  -3.527  0.00158 **
## qsec         0.64015    0.45934   1.394  0.17523
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.558 on 26 degrees of freedom
## Multiple R-squared:  0.8489, Adjusted R-squared:  0.8199
## F-statistic: 29.22 on 5 and 26 DF, p-value: 6.892e-10
Zaključak iz gornjeg izlaza tablice
- Tablica pokazuje jaku negativnu vezu između težine i potrošnje goriva, te pozitivan koeficijent za potrošnju goriva.
- Samo varijabla wt ima statistički utjecaj na mpg. Zapamtite, za testiranje hipoteze u statistici koristimo:
- H0: Nema statističkog utjecaja
- H1: Prediktor ima značajan utjecaj na y
- Ako je p vrijednost niža od 0.05, to znači da je varijabla statistički značajna
- Prilagođeni R-kvadrat: udio varijance y objašnjen modelom, korigiran za broj prediktora. Ovdje je to 0.8199, tako da model objašnjava oko 82 posto varijance potrošnje goriva. R-kvadrat se uvijek nalazi između 0 i 1, a veći je bolji.
Možete pokrenuti ANOVA test za procjenu učinka svake značajke na varijance pomoću funkcije anova().
anova(fit)
Izlaz:
## Analysis of Variance Table
##
## Response: mpg
##           Df Sum Sq Mean Sq  F value   Pr(>F)
## disp       1 808.89  808.89 123.6185 2.23e-11 ***
## hp         1  33.67   33.67   5.1449 0.031854 *
## drat       1  30.15   30.15   4.6073 0.041340 *
## wt         1  70.51   70.51  10.7754 0.002933 **
## qsec       1  12.71   12.71   1.9422 0.175233
## Residuals 26 170.13    6.54
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Konvencionalniji način procjene izvedbe modela je prikaz reziduala u odnosu na različite mjere.
Možete koristiti funkciju plot() za prikaz četiri grafikona:
– Ostaci u odnosu na prilagođene vrijednosti
– Normalni QQ grafikon: teorijski kvartil u odnosu na standardizirane reziduale
– Skala-lokacija: prilagođene vrijednosti u odnosu na kvadratne korijene standardiziranih reziduala
– Ostaci u odnosu na financijsku polugu: financijska poluga u odnosu na standardizirane reziduale
Prije plot(fit) dodajete kod par(mfrow = c(2, 2)). Ako ne dodate ovaj redak koda, R će vas potaknuti da pritisnete naredbu enter za prikaz sljedećeg grafa.
par(mfrow = c(2, 2))
Code Objašnjenje
- (mfrow=c(2,2)): vraća prozor s četiri grafikona jedan pored drugog.
- Prva 2 zbrajaju broj redaka
- Druga 2 dodaje broj stupaca.
- Ako napišete (mfrow=c(3,2)): stvorit ćete prozor s 3 reda i 2 stupca
plot(fit)
Izlaz:

Formula lm() vraća popis koji sadrži mnogo korisnih informacija. Možete im pristupiti pomoću objekta fit koji ste kreirali, nakon čega slijedi znak $ i informacije koje želite prikazati.tract.
– koeficijenti: `fit$coefficients`
– ostaci: `fit$reziduali`
– prilagođena vrijednost: `fit$fitted.values`
Faktori regresije u R
U posljednjoj procjeni modela, regresirate mpg samo na kontinuirane varijable. Modelu je jednostavno dodati faktorske varijable. Svojem modelu dodajete varijablu am. Važno je biti siguran da je varijabla faktorska razina, a ne kontinuirana.
df <- mtcars %>%
    mutate(cyl = factor(cyl),
        vs = factor(vs),
        am = factor(am),
        gear = factor(gear),
        carb = factor(carb))
model <- mpg ~ .
summary(lm(model, df))
Izlaz:
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5087 -1.3584 -0.0948  0.7745  4.6251
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 23.87913   20.06582   1.190   0.2525
## cyl6        -2.64870    3.04089  -0.871   0.3975
## cyl8        -0.33616    7.15954  -0.047   0.9632
## disp         0.03555    0.03190   1.114   0.2827
## hp          -0.07051    0.03943  -1.788   0.0939 .
## drat         1.18283    2.48348   0.476   0.6407
## wt          -4.52978    2.53875  -1.784   0.0946 .
## qsec         0.36784    0.93540   0.393   0.6997
## vs1          1.93085    2.87126   0.672   0.5115
## am1          1.21212    3.21355   0.377   0.7113
## gear4        1.11435    3.79952   0.293   0.7733
## gear5        2.52840    3.73636   0.677   0.5089
## carb2       -0.97935    2.31797  -0.423   0.6787
## carb3        2.99964    4.29355   0.699   0.4955
## carb4        1.09142    4.44962   0.245   0.8096
## carb6        4.47757    6.38406   0.701   0.4938
## carb8        7.25041    8.36057   0.867   0.3995
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.833 on 15 degrees of freedom
## Multiple R-squared:  0.8931, Adjusted R-squared:  0.779
## F-statistic:  7.83 on 16 and 15 DF,  p-value: 0.000124
R koristi prvu razinu faktora kao osnovnu grupu. Morate usporediti koeficijente druge grupe u odnosu na osnovnu grupu.
Pretpostavke linearne regresije u R-u
Obična metoda najmanjih kvadrata daje pouzdane koeficijente i p-vrijednosti samo kada je ispunjeno pet uvjeta. Četiri dijagnostička grafikona koje proizvodi plot(fit) postoje upravo da bi ih provjerili.
- linearnost: odnos između svakog prediktora i y je linearan. Provjerite Ostaci u odnosu na ugrađene dijelove graf; vidljiva krivulja znači da vam je potrebna transformacija ili polinomski član.
- Neovisnost: Članovi pogreške nisu korelirani. Vremenski poredani podaci često krše ovo, što možete testirati pomoću durbinWatsonTest() iz paketa car.
- Homoskedastičnost: Varijanca pogreške je konstantna za sve prilagođene vrijednosti. Oblik lijevka u Skala-Lokacija zaplet signalizira kršenje.
- Normalnost reziduala: pogreške slijede normalnu distribuciju. Točke bi trebale biti na dijagonali Normalni QQ zemljište.
- Nema multikolinearnosti: Prediktori nisu gotovo identični. Faktor inflacije varijance iznad 5 je uobičajena linija upozorenja.
library(car)
vif(fit)           # variance inflation factors
shapiro.test(residuals(fit))   # normality of residuals
Kršenja ne čine uvijek model nevažećim, ali mijenjaju koliko možete biti sigurni u p-vrijednosti, stoga ih provjerite prije izvještavanja bilo kojeg koeficijenta.
Kako napraviti predviđanja pomoću modela linearne regresije u R-u
Prilagođavanje modela je samo pola posla. Funkcija predict() primjenjuje prilagođene koeficijente na nova opažanja.
predict(object, newdata, interval = "none", level = 0.95)
arguments:
-object: The model returned by lm()
-newdata: A data frame whose columns match the predictors used in the formula
-interval: "none", "confidence" for the mean response, or "prediction" for a single new case
-level: The confidence level, 0.95 by default
Slijedite ova tri koraka.
- Izgradite okvir podataka za nove slučajeve. Nazivi stupaca moraju se točno podudarati s nazivima prediktora u formuli, a razine faktora moraju se podudarati s podacima za učenje.
- Pozovite predict(). Proslijedite prilagođeni objekt i novi okvir podataka.
- Dodajte interval. Odaberite „pouzdanost“ kada želite nesigurnost oko prosječnog odziva, a „predviđanje“ kada želite domet za jedan pojedinačni automobil.
new_cars <- data.frame(wt = c(2.5, 3.2), hp = c(110, 175))
fit_final <- lm(mpg ~ wt + hp, data = mtcars)

predict(fit_final, newdata = new_cars)
predict(fit_final, newdata = new_cars, interval = "prediction")
Čitanje rezultata. Predviđa se da će automobil težine 2.5 tisuće funti sa 110 konjskih snaga potrošiti otprilike 24.1 mpg. Interval predviđanja uvijek je širi od intervala pouzdanosti jer nosi nesigurnost pojedinačnog opažanja povrh nesigurnosti prilagođene linije.
Dva pravila održavaju predviđanja iskrenima. Nikada ne ekstrapolirajte izvan raspona prediktora za učenje, jer ravna linija nema dokaza. I uvijek procjenjujte na podacima koje model nije vidio, inače je prijavljena pogreška optimistična.
Linearna regresija u odnosu na logističku regresiju u R-u
Analitičari često posežu za lm() kada ishod nije kontinuiran. Tablica u nastavku pokazuje gdje se nalazi granica.
| Kriteriji | Linearna regresija | Logistička regresija |
|---|---|---|
| Varijabla odgovora | Stalan | Binarno ili kategoričko |
| Predviđeni izlaz | Bilo koji realni broj | Vjerojatnost između 0 i 1 |
| Procjena | Obični najmanji kvadrati | Maksimalna vjerojatnost |
| Prilagodite mjeru | R-kvadrat, RMSE | AIC, devijantnost, točnost |
| R funkcija | lm(formula, podaci) | glm(formula, podaci, obitelj = “binom”) |
Ako je ishod odluka da ili ne, prijeđite na generalizirani linearni model umjesto forsiranja ravne linije kroz nule i jedinice.
Postepena linearna regresija u R
Posljednji dio ovog vodiča bavi se postupna regresija algoritam. Svrha ovog algoritma je dodavanje i uklanjanje potencijalnih kandidata u modelima i zadržavanje onih koji imaju značajan utjecaj na zavisnu varijablu. Ovaj algoritam ima smisla kada skup podataka sadrži veliki popis prediktora. Ne morate ručno dodavati i uklanjati nezavisne varijable. Postepena regresija izgrađena je za odabir najboljih kandidata koji odgovaraju modelu.
Pogledajmo u akciji kako to funkcionira. Skup podataka mtcars s kontinuiranim varijablama koristite samo za pedagošku ilustraciju. Prije nego što započnete analizu, dobra je praksa pregledati odnose u podacima pomoću matrice korelacije. Biblioteka GGally je proširenje biblioteke ggplot2.
Knjižnica uključuje različite funkcije za prikaz sumarne statistike kao što su korelacija i distribucija svih varijabli u matrici. Koristit ćemo funkciju ggscatmat, ali možete se pozvati na vinjeta za više informacija o knjižnici GGally.
Osnovna sintaksa za ggscatmat() je:
ggscatmat(df, columns = 1:ncol(df), corMethod = "pearson")
arguments:
-df:  A matrix of continuous variables
-columns: Pick up the columns to use in the function. By default, all columns are used
-corMethod: Define the function to compute the correlation between variable. By default, the algorithm uses the Pearson formula
Prikazujete korelaciju za sve svoje varijable i odlučujete koje su najbolji kandidati za prvi korak postupne regresije. Postoje neke jake korelacije između vaših varijabli i zavisne varijable, mpg.
library(GGally)
df <- mtcars %>%
	select(-c(am, vs, cyl, gear, carb))
ggscatmat(df, columns = 1: ncol(df))
Izlaz:

Korak po korak primjer regresije
Odabir varijabli važan je dio prilagođavanja modela, a postupna regresija automatski izvodi tu pretragu. Da biste procijenili koliko mogućih izbora postoji u skupu podataka, izračunavate  gdje je k broj prediktora. Količina mogućnosti raste s brojem nezavisnih varijabli. Zato morate imati automatsku pretragu.
Morate instalirati paket olsrr iz CRAN-a. Paket još nije dostupan u Anacondi. Stoga ga instalirate izravno iz naredbenog retka:
install.packages("olsrr")
Možete iscrtati sve podskupove mogućnosti s kriterijima prilagodbe (tj. R-kvadrat, prilagođeni R-kvadrat, Bayesov kriterij). Model s najnižim AIC kriterijima bit će konačni model.
library(olsrr)
model <- mpg~.
fit <- lm(model, df)
test <- ols_all_subset(fit)
plot(test)
Code Objašnjenje
- mpg ~.: Konstruirajte model za procjenu
- lm(model, df): Pokrenite OLS model
- ols_svi_podskup(prilagođavanje): Izgradite grafove s relevantnim statističkim podacima
- dijagram (test): Iscrtajte grafikone
Izlaz:

Modeli linearne regresije koriste t-test za procjenu statističkog utjecaja nezavisne varijable na zavisnu varijablu. Istraživači obično postavljaju maksimalni prag na 10 posto, a niže p-vrijednosti ukazuju na jaču statističku vezu. Postupna regresija se gradi oko ovog testa za dodavanje i uklanjanje kandidata za prediktore. Algoritam radi na sljedeći način:

- Korak 1: Regresirajte svaki prediktor na y zasebno. Naime, regresija x_1 na y, x_2 na y na x_n. Pohranite p-vrijednost i zadržite regresor s p-vrijednošću nižom od definiranog praga (0.1 prema zadanim postavkama). Prediktori sa značajnošću nižom od praga bit će dodani konačnom modelu. Ako nijedna varijabla nema p-vrijednost nižu od ulaznog praga, tada se algoritam zaustavlja i imate svoj konačni model samo s konstantom.
- Korak 2: Koristite prediktor s najnižom p-vrijednošću i zasebno dodaje jednu varijablu. Regresirate konstantu, najbolji prediktor prvog koraka i treće varijable. Postupnom modelu dodajete nove prediktore s vrijednošću nižom od ulaznog praga. Ako nijedna varijabla nema p-vrijednost nižu od 0.1, tada se algoritam zaustavlja i imate svoj konačni model sa samo jednim prediktorom. Regresirate postupni model kako biste provjerili značaj najboljih prediktora za prvi korak. Ako je viši od praga za uklanjanje, zadržavate ga u postupnom modelu. U protivnom ga isključujete.
- Korak 3: Replicirate korak 2 na novom najboljem modelu korak po korak. Algoritam dodaje prediktore u postupni model na temelju unesenih vrijednosti i isključuje prediktor iz postupnog modela ako ne zadovoljava prag isključivanja.
- Algoritam nastavlja raditi dok se nijedna varijabla ne može dodati ili isključiti.
Algoritam možete izvesti s funkcijom ols_stepwise() iz paketa olsrr.
ols_stepwise(fit, pent = 0.1, prem = 0.3, details = FALSE)

arguments:
-fit:  Model to fit. Need to use `lm()`before to run `ols_stepwise()
-pent: Threshold of the p-value used to enter a variable into the stepwise model. By default, 0.1
-prem: Threshold of the p-value used to exclude a variable into the stepwise model. By default, 0.3
-details: Print the details of each step
⚠️ Napomena o paketu: Novije verzije olsrr-a preimenovale su ove funkcije. Koristite ols_step_sve_moguće() umjesto ols_all_subset() i ols_step_both_p() umjesto ols_stepwise(). Argumenti i izlaz ostaju nepromijenjeni.
Prije toga, pokazat ćemo vam korake algoritma. Dolje je tablica s ovisnim i nezavisnim varijablama:
| Zavisna varijabla | Nezavisne varijable |
|---|---|
| mpg | dostupno |
| hp | |
| štakor | |
| wt | |
| qsec |
Start
Za početak, algoritam počinje pokretanjem modela na svakoj nezavisnoj varijabli zasebno. Tablica prikazuje p-vrijednost za svaki model.
## [[1]]
##  (Intercept)         disp
## 3.576586e-21 9.380327e-10
##
## [[2]]
##  (Intercept)           hp
## 6.642736e-18 1.787835e-07
##
## [[3]]
##  (Intercept)         drat
## 0.1796390847 0.0000177624
##
## [[4]]
##  (Intercept)           wt
## 8.241799e-19 1.293959e-10
##
## [[5]
## (Intercept)        qsec
##  0.61385436  0.01708199
Za ulazak u model, algoritam zadržava varijablu s najnižom p-vrijednošću. Iz gornjeg rezultata, to je mas
Korak 1
U prvom koraku, algoritam neovisno pokreće mpg na wt i drugim varijablama.
## [[1]]
##  (Intercept)           wt         disp
## 4.910746e-16 7.430725e-03 6.361981e-02
##
## [[2]]
##  (Intercept)           wt           hp
## 2.565459e-20 1.119647e-06 1.451229e-03
##
## [[3]]
##  (Intercept)           wt         drat
## 2.737824e-04 1.589075e-06 3.308544e-01
##
## [[4]]
##  (Intercept)           wt         qsec
## 7.650466e-04 2.518948e-11 1.499883e-03
Svaka varijabla je potencijalni kandidat za ulazak u konačni model. Međutim, algoritam zadržava samo varijablu s nižom p-vrijednošću. Ispada da hp ima nešto nižu p-vrijednost od qsec, pa hp ulazi u konačni model.
Korak 2
Algoritam ponavlja prvi korak, ali ovaj put s dvije neovisne varijable u konačnom modelu.
## [[1]]
##  (Intercept)           wt           hp         disp
## 1.161936e-16 1.330991e-03 1.097103e-02 9.285070e-01
##
## [[2]]
##  (Intercept)           wt           hp         drat
## 5.133678e-05 3.642961e-04 1.178415e-03 1.987554e-01
##
## [[3]]
##  (Intercept)           wt           hp         qsec
## 2.784556e-03 3.217222e-06 2.441762e-01 2.546284e-01
Nijedan od preostalih kandidata nema p-vrijednost ispod ulaznog praga. Algoritam se ovdje zaustavlja i ovo je konačni model:
##
## Call:
## lm(formula = mpg ~ wt + hp, data = df)
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -3.941 -1.600 -0.182  1.050  5.854
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 37.22727    1.59879  23.285  < 2e-16 ***
## wt          -3.87783    0.63273  -6.129 1.12e-06 ***
## hp          -0.03177    0.00903  -3.519  0.00145 **
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.593 on 29 degrees of freedom
## Multiple R-squared:  0.8268, Adjusted R-squared:  0.8148
## F-statistic: 69.21 on 2 and 29 DF,  p-value: 9.109e-12
Možete koristiti funkciju ols_stepwise() za usporedbu rezultata.
stp_s <-ols_stepwise(fit, details=TRUE)
Izlaz:
Algoritam pronalazi rješenje nakon dva koraka i vraća isti izlaz kao i gornji ručni vodič.
Konačni model stoga objašnjavaju dva prediktora i odsječak na jednoj liniji: milje po galonu negativno su povezane i s bruto konjskim snagama i s težinom.
## You are selecting variables based on p value...
## 1 variable(s) added....
## Variable Selection Procedure
##  Dependent Variable: mpg
##
##  Stepwise Selection: Step 1
##
##  Variable wt Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.868       RMSE                3.046
## R-Squared               0.753       Coef. Var          15.161
## Adj. R-Squared          0.745       MSE                 9.277
## Pred R-Squared          0.709       MAE                 2.341
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##		ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     847.725         1        847.725    91.375    0.0000
## Residual       278.322        30          9.277
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.285         1.878                 19.858    0.000    33.450    41.120
##          wt    -5.344         0.559       -0.868    -9.559    0.000    -6.486    -4.203
## ----------------------------------------------------------------------------------------
## 1 variable(s) added...
## Stepwise Selection: Step 2
##
##  Variable hp Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.909       RMSE                2.593
## R-Squared               0.827       Coef. Var          12.909
## Adj. R-Squared          0.815       MSE                 6.726
## Pred R-Squared          0.781       MAE                 1.901
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##			ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     930.999         2        465.500    69.211    0.0000
## Residual       195.048        29          6.726
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.227         1.599                 23.285    0.000    33.957    40.497
##          wt    -3.878         0.633       -0.630    -6.129    0.000    -5.172    -2.584
##          hp    -0.032         0.009       -0.361    -3.519    0.001    -0.050    -0.013
## ----------------------------------------------------------------------------------------
## No more variables to be added or removed.
Linearna regresija u R-u: Ključne informacije i referenca funkcija
- Linearna regresija odgovara na jednostavno pitanje: možete li izmjeriti točan odnos između jedne ciljne varijable i skupa prediktora?
- Metoda običnih najmanjih kvadrata pronalazi parametre koji minimiziraju zbroj kvadratnih pogrešaka, odnosno vertikalnu udaljenost između predviđenih y vrijednosti i stvarnih y vrijednosti.
- Vjerojatnosni model koji uključuje više od jedne nezavisne varijable naziva se model višestruke regresije.
- Svrha algoritma Stepwise Linear Regression je dodavanje i uklanjanje potencijalnih kandidata u modelima i zadržavanje onih koji imaju značajan utjecaj na zavisnu varijablu.
- Odabir varijabli važan je dio prilagođavanja modela, a postupna regresija automatski izvodi tu pretragu.
Svaka funkcija korištena u ovom tutorijalu navedena je u nastavku:
| Knjižnica | Cilj | funkcija | argumenti |
|---|---|---|---|
| baza | Izračunajte linearnu regresiju | lm() | formula, podaci |
| baza | Sažeti model | Sažetak() | pristajati |
| baza | Extract-koeficijenti | lm()$koeficijent | |
| baza | Extract reziduala | lm()$reziduali | |
| baza | Extract-prilagođena vrijednost | lm()$uklopljene.vrijednosti | |
| olsrr | Pokrenite postupnu regresiju | ols_stepwise() | pristajanje, pent = 0.1, prem = 0.3, detalji = FALSE |
bilješkeNe zaboravite pretvoriti kategoričke varijable u faktore prije prilagođavanja modela.
