
Pearsonova a Spearmanova korelační matice v R s příkladem
 Evelyn Clarkeová
⚡ Chytré shrnutí
Pearsonova a Spearmanova korelace v R měří, jak silně se dvě proměnné vzájemně ovlivňují, a to pomocí funkce cor() pro jeden pár a korelační matice pro více párů. Tento návod přidává testování významnosti pomocí Hmisc a vizualizuje výsledek pomocí tepelných map GGally.
Dvourozměrná korelace v R
Dvourozměrný vztah popisuje vztah – nebo korelaci – mezi dvěma proměnnými v R. V tomto tutoriálu probereme koncept korelace a ukážeme, jak jej lze použít k měření vztahu mezi libovolnými dvěma proměnnými v R.
Korelace v R programování
Existují dvě primární metody pro výpočet korelace mezi dvěma proměnnými v programování R:
- Pearson: Parametrická korelace
- Spearman: Neparametrická korelace
Pearsonova korelační matice v R
Pearsonova korelační metoda se obvykle používá jako primární kontrola vztahu mezi dvěma proměnnými.
Jedno koeficient korelace, označováno jako r, měří sílu lineární vztah mezi dvěma proměnnými x a y. Vypočítá se následovně:
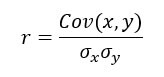
s
 je směrodatná odchylka x
 je směrodatná odchylka y
Korelace se pohybuje mezi -1 a 1.
- Hodnota r blízká nebo rovna 0 znamená malý nebo žádný lineární vztah mezi x a y.
- Čím blíže je r k 1 nebo -1, tím silnější je lineární vztah.
Zda se r liší od nuly, můžete otestovat pomocí níže uvedené t-statistiky porovnáním se Studentovým rozdělením s n – 2 stupni volnosti:
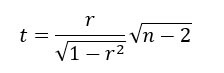
Korelace hodnosti Spearmana v R
Pořadová korelace třídí pozorování podle pořadí a vypočítává úroveň podobnosti mezi jednotlivými pořadími. Pořadová korelace má výhodu v tom, že je robustní vůči odlehlým hodnotám a není vázána na distribuci dat. Pořadová korelace je také správnou volbou pro ordinální proměnné.
Spearmanova korelace pořadí, označovaná jako rho, se také pohybuje od -1 do 1 a hodnoty blízké kterémukoli extrému naznačují silný monotónní vztah. Vypočítá se následovně:
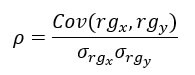
Čitatel je kovariance mezi řadami x a y a jmenovatel je součin jejich směrodatných odchylek.
V R se obojí vypočítává pomocí funkce cor(), která přijímá tři argumenty: x, y a metodu.
cor(x, y, method)
Argumenty:
- x: První vektor
- y: Druhý vektor
- metoda: Vzorec použitý k výpočtu korelace. Tři hodnoty řetězce:
- "pearson"
- "kendal"
- "kopiník"
Pokud vektory obsahují chybějící hodnotu, lze přidat volitelný argument: use = “complete.obs”
Použijeme datovou sadu BudgetUK. Tento soubor údajů uvádí rozpočtové alokace britských domácností v letech 1980 až 1982. Existuje 1519 pozorování s deseti rysy, mezi nimi:
- wfood: sdílet jídlo sdílet utrácet
- wfuel: podíl na útratě paliva
- wcloth: podíl rozpočtu na výdaje na oblečení
- walc: sdílet alkohol utrácet
- wtrans: sdílet výdaje na dopravu
- wother: podíl na útratě ostatního zboží
- totexp: celkové výdaje domácnosti v librách
- příjem: celkový čistý příjem domácnosti
- stáří: věk domácnosti
- děti: počet dětí
Příklad
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/british_household.csv"
data <- read.csv(PATH) %>%
    filter(income < 500) %>%
    mutate(log_income = log(income),
           log_totexp = log(totexp),
           children_fac = factor(children, order = TRUE, labels = c("No", "Yes"))) %>%
    select(-c(X, X.1, children, totexp, income))
glimpse(data)
Code Vysvětlení
- Nejprve importujeme data a podíváme se pomocí funkce glimpse() z knihovny dplyr.
- Tři domácnosti uvádějí příjem 500 nebo více, takže filtr (příjem < 500) je odstraní a počet řádků klesne z 1 519 na 1 516.
- Je běžnou praxí převádět peněžní proměnnou v log. Pomáhá snížit dopad odlehlých hodnot a snižuje zkreslení datové sady.
Výstup:
## Observations: 1,516
## Variables: 10
## $ wfood        <dbl> 0.4272, 0.3739, 0.1941, 0.4438, 0.3331, 0.3752, 0...
## $ wfuel        <dbl> 0.1342, 0.1686, 0.4056, 0.1258, 0.0824, 0.0481, 0...
## $ wcloth       <dbl> 0.0000, 0.0091, 0.0012, 0.0539, 0.0399, 0.1170, 0...
## $ walc         <dbl> 0.0106, 0.0825, 0.0513, 0.0397, 0.1571, 0.0210, 0...
## $ wtrans       <dbl> 0.1458, 0.1215, 0.2063, 0.0652, 0.2403, 0.0955, 0...
## $ wother       <dbl> 0.2822, 0.2444, 0.1415, 0.2716, 0.1473, 0.3431, 0...
## $ age          <int> 25, 39, 47, 33, 31, 24, 46, 25, 30, 41, 48, 24, 2...
## $ log_income   <dbl> 4.867534, 5.010635, 5.438079, 4.605170, 4.605170,...
## $ log_totexp   <dbl> 3.912023, 4.499810, 5.192957, 4.382027, 4.499810,...
## $ children_fac <ord> Yes, Yes, Yes, Yes, No, No, No, No, No, No, Yes, ...
Korelační koeficient mezi příjmovými a wfood proměnnými můžeme vypočítat metodami „pearson“ a „spearman“.
cor(data$log_income, data$wfood, method = "pearson")
Výstup:
## [1] -0.2466986
cor(data$log_income, data$wfood, method = "spearman")
Výstup:
## [1] -0.2501252
Než to rozšíříme na každou dvojici proměnných, je vhodné stanovit, jak by se měl číst jeden koeficient.
Jak interpretovat korelační koeficient
Koeficient je užitečný pouze tehdy, když umíte říct, co znamená. Pásma níže představují konvenční hodnotu a znaménko se čte odděleně od síly.
| Absolutní hodnota r | Síla vztahu |
|---|---|
| 0.00 0.19 na | Velmi slabé nebo žádné |
| 0.20 0.39 na | Slabý |
| 0.40 0.59 na | Středně |
| 0.60 0.79 na | Silný |
| 0.80 1.00 na | Velmi silný |
Hodnota -0.2467 vypočítaná dříve mezi log_income a wfood je tedy slabý negativní vztah: bohatší domácnosti utratí za potraviny o něco menší část svého rozpočtu.
Pro každý koeficient platí tři upozornění.
- Korelace není kauzalita. Silné r říká, že se obě proměnné pohybují společně, nikdy ne, že jedna způsobuje druhou. Třetí, neměřená proměnná často řídí obě.
- Pearson vidí pouze rovné čáry. Perfektní vztah ve tvaru U vrací r blízké nule. Vždy si vykreslete data, než se číslu budete důvěřovat.
- Velikost je důležitější než význam. Při 1 516 pozorováních může být koeficient 0.06 statisticky významný a stále prakticky bezvýznamný.
Jak otestovat korelační významnost pomocí cor.test()
cor() vrací koeficient a nic jiného. Pro jeden pár sečte cor.test() p-hodnotu a interval spolehlivosti v jednom volání.
cor.test(data$log_income, data$wfood, method = "pearson")
Výstup má čtyři části, které stojí za přečtení.
- t a df: testovací statistika a její stupně volnosti, n – 2.
- p-hodnotapravděpodobnost výskytu takto velkého koeficientu, pokud by skutečná korelace byla nulová.
- 95% interval spolehlivosti: věrohodný rozsah pro skutečnou korelaci. Pokud vylučuje nulu, je vztah na dané úrovni významný.
- ukázkový odhad: samotný koeficient, identický s tím, co vrací funkce cor().
Stejná funkce spouští testy založené na pořadí změnou jednoho argumentu:
# Spearman rank correlation with a p-value
cor.test(data$log_income, data$wfood, method = "spearman")

# One-sided test: is the correlation greater than zero?
cor.test(data$log_income, data$wfood, alternative = "greater")
Kdy který použít. Použijte cor.test() při zkoumání jednoho konkrétního páru, protože udává interval spolehlivosti, který rcorr() vynechává. Použijte rcorr() z Hmisc, jak je uvedeno výše, pokud potřebujete p-hodnoty pro celou matici najednou. Upozorňujeme, že testování mnoha párů zvyšuje míru falešně pozitivních výsledků, proto upravte p-hodnoty pomocí p.adjust(p_value, method = “BH”) před vyvozováním závěrů z velké matice.
Korelační matice v R
Dvourozměrná korelace je dobrý začátek, ale vícerozměrný pohled poskytuje širší obraz. korelační matice je čtvercová tabulka obsahující párové korelace všech proměnných vůči sobě navzájem.
Funkce cor() vrací korelační matici. Jediný rozdíl oproti bivariační korelaci je, že nemusíme specifikovat, které proměnné. Ve výchozím nastavení R počítá korelaci mezi všemi proměnnými.
Korelaci pro faktor nelze vypočítat, proto před předáním datového rámce do cor() odstraňte všechny kategoriální sloupce.
Korelační matice je symetrická, což znamená, že hodnoty nad úhlopříčkou mají stejné hodnoty jako ta níže. Vizuálnější je zobrazit polovinu matice.
Funkce children_fac je vyloučena, protože metoda cor() nemůže operovat s faktorem.
# the last column of data is a factor level. We don't include it in the code
mat_1 <-as.dist(round(cor(data[,1:9]),2))
mat_1
Code Vysvětlení
- cor(data[, 1:9])Vypočítejte korelační matici na devíti číselných sloupcích
- kolo(…, 2)Zaokrouhlete každý koeficient na dvě desetinná místa
- as.dist()Vytiskněte pouze spodní trojúhelník, protože matice je symetrická
Výstup:
##            wfood wfuel wcloth  walc wtrans wother   age log_income
## wfuel       0.11
## wcloth     -0.33 -0.25
## walc       -0.12 -0.13  -0.09
## wtrans     -0.34 -0.16  -0.19 -0.22
## wother     -0.35 -0.14  -0.22 -0.12  -0.29
## age         0.02 -0.05   0.04 -0.14   0.03   0.02
## log_income -0.25 -0.12   0.10  0.04   0.06   0.13  0.23
## log_totexp -0.50 -0.36   0.34  0.12   0.15   0.15  0.21       0.49
Úroveň významnosti
Samotný koeficient neříká, zda je vztah statisticky spolehlivý. Funkce rcorr() z knihovny Hmisc vrací p-hodnotu pro každý pár. Knihovnu si můžeme stáhnout z Conda a zkopírujte kód a vložte jej do terminálu:
conda install -c r r-hmisc
rcorr() vyžaduje, aby byl datový rámec uložen jako matice. Můžeme převést naše data do matice předtím, než vypočítat korelační matici s p-hodnotou.
library("Hmisc")
data_rcorr <-as.matrix(data[, 1: 9])

mat_2 <-rcorr(data_rcorr)
# mat_2 <-rcorr(as.matrix(data)) returns the same output
Objekt seznamu mat_2 obsahuje tři prvky:
- r: Výstup korelační matice
- n: Počet pozorování
- P: p-hodnota
Zajímá nás třetí prvek, p-hodnota. Je běžné ukazovat korelační matici s p-hodnotou namísto korelačního koeficientu.
p_value <-round(mat_2[["P"]], 3)
p_value
Code Vysvětlení
- mat_2[[“P”]]: P-hodnoty jsou uloženy v prvku zvaném P
- kolo(mat_2[[“P”]], 3): Zaokrouhlete prvky na tři číslice
Výstup:
           wfood wfuel wcloth  walc wtrans wother   age log_income log_totexp
wfood         NA 0.000  0.000 0.000  0.000  0.000 0.365      0.000          0
wfuel      0.000    NA  0.000 0.000  0.000  0.000 0.076      0.000          0
wcloth     0.000 0.000     NA 0.001  0.000  0.000 0.160      0.000          0
walc       0.000 0.000  0.001    NA  0.000  0.000 0.000      0.105          0
wtrans     0.000 0.000  0.000 0.000     NA  0.000 0.259      0.020          0
wother     0.000 0.000  0.000 0.000  0.000     NA 0.355      0.000          0
age        0.365 0.076  0.160 0.000  0.259  0.355    NA      0.000          0
log_income 0.000 0.000  0.000 0.105  0.020  0.000 0.000         NA          0
log_totexp 0.000 0.000  0.000 0.000  0.000  0.000 0.000      0.000         NA
Vizualizace korelační matice v R
Tepelná mapa je dalším způsobem, jak číst korelační matici. Knihovna GGally rozšiřuje knihovnu ggplot2 a instaluje se z CRAN, nikoli z conda:
install.packages("GGally")

Knihovna obsahuje různé funkce pro zobrazení souhrnných statistik, jako je korelace a distribuce všech proměnných v a matice.
Funkce ggcorr() má spoustu argumentů. Uvedeme pouze argumenty, které použijeme v tutoriálu:
Funkce ggcorr
ggcorr(df, method = c("pairwise", "pearson"),
  nbreaks = NULL, digits = 2, low = "#3B9AB2",
  mid = "#EEEEEE", high = "#F21A00",
  geom = "tile", label = FALSE,
  label_alpha = FALSE)
argumenty:
- df: Použitá datová sada
- metoda: Vzorec pro výpočet korelace. Ve výchozím nastavení se počítá párově a Pearson
- nbreaks: Vrátí kategorický rozsah pro zabarvení koeficientů. Ve výchozím nastavení bez přerušení a barevný přechod je souvislý
- číslice: Zaokrouhlete korelační koeficient. Ve výchozím nastavení nastavte na 2
- nízký: Ovládání nižší úrovně zabarvení
- střední: Ovládání střední úrovně zabarvení
- vysoký: Ovládání vysoké úrovně zabarvení
- geom: Ovládání tvaru geometrického argumentu. Ve výchozím nastavení „dlaždice“
- štítek: Booleovská hodnota. Zobrazit nebo nezobrazit štítek. Ve výchozím nastavení je nastaveno na `FALSE`
Základní tepelná mapa
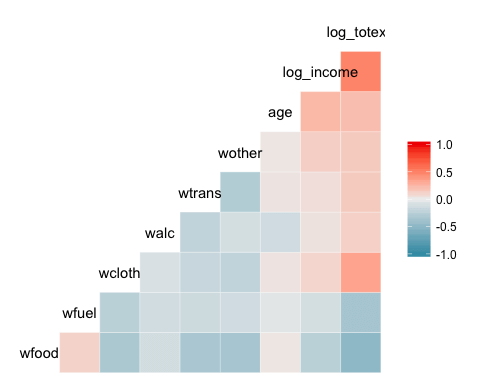
Nejzákladnější zápletkou balíčku je tepelná mapa. Legenda grafu ukazuje barvu gradientu od – 1 do 1, přičemž horká barva indikuje silnou pozitivní korelaci a studená barva, negativní korelaci.
library(GGally)
ggcorr(data)
Code Vysvětlení
- ggcorr(data): Je potřeba pouze jeden argument, kterým je název datového rámce. Proměnné na úrovni faktoru nejsou v grafu zahrnuty.
Výstup:
Přidání kontroly do tepelné mapy
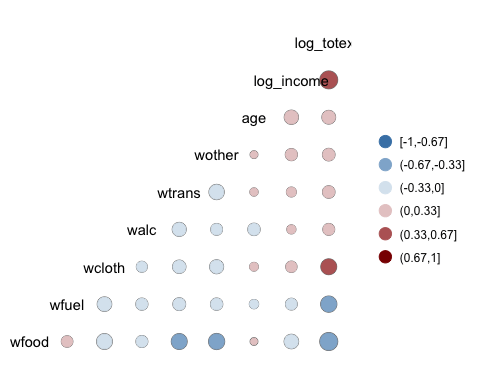
Do grafu můžeme přidat další ovládací prvky:
ggcorr(data,
    nbreaks = 6,
    low = "steelblue",
    mid = "white",
    high = "darkred",
    geom = "circle")
Code Vysvětlení
- nbreaks=6: rozbít legendu se 6 pozicemi.
- nízká = „ocelově modrá“: Použijte světlejší barvy pro negativní korelaci
- střední = „bílá“: Pro korelaci středních rozsahů použijte bílé barvy
- vysoký = „tmavý“: Použijte tmavé barvy pro pozitivní korelaci
- geom = "kruh": Použijte kruh jako tvar oken v tepelné mapě. Velikost kruhu je úměrná absolutní hodnotě korelace.
Výstup:
Přidání štítku do tepelné mapy
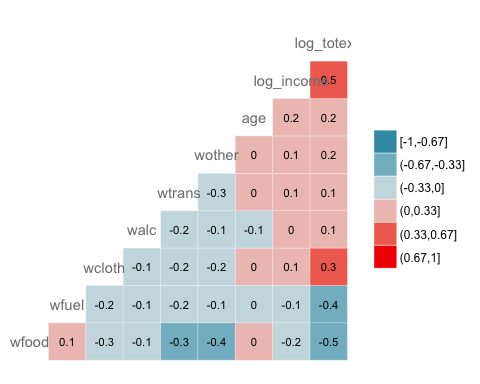
GGally nám umožňuje přidat štítek do oken:
ggcorr(data,
    nbreaks = 6,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code Vysvětlení
- štítek = PRAVDA: Přidejte hodnoty korelačních koeficientů uvnitř tepelné mapy.
- barva = "šedá50": Vyberte barvu, tj. šedou
- velikost_štítku = 3: Nastavte velikost štítku na 3
Výstup:
Funkce ggpairs
Knihovna GGally také poskytuje funkci ggpairs(), která vrací matici grafů. Pro k vybraných proměnných je výsledkem mřížka ak krát k: diagonála zobrazuje rozdělení každé proměnné, zatímco panely nad a pod diagonálou mohou obsahovat každý jiný výpočet. Syntaxe je:
ggpairs(df, columns = 1:ncol(df), title = NULL,
    upper = list(continuous = "cor"),
    lower = list(continuous = "smooth"),
    mapping = NULL)
argumenty:
- df: Použitá datová sada
- sloupce: Vyberte sloupce pro kreslení grafu
- titul: Vložit název
- horní: Ovládejte políčka nad diagonálou grafu. Je nutné zadat typ výpočtů nebo grafu, který se má vrátit. Pokud continuous = „cor“, požádáme R o výpočet korelace. Argument musí být seznam. K dispozici jsou i další argumenty; viz Dokumentace GGally Pro více informací.
- nižší: Ovládejte políčka pod úhlopříčkou.
- mapaping: Označuje estetiku grafu. Například můžeme vypočítat graf pro různé skupiny.
Bivariační analýza s ggpair s grouping
Následující graf zobrazuje tři informace:
- Korelační matice mezi proměnnými log_totexp, log_income, věk a wtrans seskupené podle toho, zda má domácnost dítě nebo ne.
- Nakreslete distribuci každé proměnné podle skupiny
- Zobrazte bodový graf s trendem podle skupiny
library(ggplot2)
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"), title = "Bivariate analysis of revenue expenditure by the British household", upper = list(continuous = wrap("cor",
        size = 3)),
    lower = list(continuous = wrap("smooth",
        alpha = 0.3,
        size = 0.1)),
    mapping = aes(color = children_fac))
Code Vysvětlení
- sloupce = c(“log_totexp”, “log_income”, “age”, “wtrans”): Vyberte proměnné, které se mají zobrazit v grafu
- title = „Bivariační analýza výdajů na příjmy britské domácnosti“: Přidejte název
- horní = seznam(): Ovládání horní části grafu. Tj. Nad úhlopříčkou
- kontinuální = wrap(“cor”, velikost = 3)): Vypočtěte korelační koeficient. Argument spojitě zabalíme do funkce wrap() pro kontrolu estetiky grafu (tj. velikost = 3) -lower = list(): Ovládání spodní části grafu. Tj. pod úhlopříčkou.
- kontinuální = obal (“hladký”, alfa = 0.3, velikost=0.1): Přidá bodový graf s lineárním trendem. Argument spojitý zabalíme do funkce wrap(), abychom ovládali estetiku grafu (tj. velikost=0.1, alfa=0.3)
- mapaping = aes(barva = dětská_fakce)Rozdělte každý panel podle children_fac, seřazeného faktoru označeného „Ne“ pro domácnosti bez dětí a „Ano“ pro domácnosti s dětmi.
Výstup:

Bivariační analýza s ggpair s parciální grouping
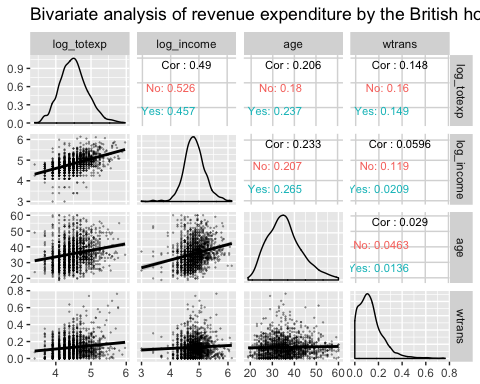
Graf níže je trochu jiný. Změníme polohu mapy.ping uvnitř horního argumentu.
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"),
    title = "Bivariate analysis of revenue expenditure by the British household",
    upper = list(continuous = wrap("cor",
            size = 3),
        mapping = aes(color = children_fac)),
    lower = list(
        continuous = wrap("smooth",
            alpha = 0.3,
            size = 0.1))
)
Code Vysvětlení
- Přesně stejný kód jako předchozí příklad s výjimkou:
- mapaping = aes(color = children_fac): Přesune seznam v horní části grafu = list(). Chceme, aby byl výpočet uspořádaný podle skupin pouze v horní části grafu.
Výstup:
Korelace v R: Klíčové poznatky a reference funkcí
- Dvourozměrný vztah popisuje vztah – nebo korelaci – mezi dvěma proměnnými v R.
- Existují dvě primární metody pro výpočet korelace mezi dvěma proměnnými v R Programování: Pearson & Spearman.
- Pearsonova korelační metoda se obvykle používá jako primární kontrola vztahu mezi dvěma proměnnými.
- Pořadová korelace třídí pozorování podle pořadí a vypočítává úroveň podobnosti mezi pořadím.
- Spearmanova korelace pořadí se pohybuje od -1 do 1 a hodnoty blízké kterémukoli extrému naznačují silný monotónní vztah.
- Korelační matice je čtvercová tabulka obsahující párové korelace všech proměnných.
- P-hodnota vám říká, zda je pozorovaná korelace statisticky odlišitelná od nuly.
Všechny korelační funkce použité v tomto tutoriálu jsou uvedeny níže:
| Knihovna | Objektivní | Metoda | Code |
|---|---|---|---|
| Základna | Bivariační korelace | Pearson |
cor(dfx2, method = "pearson") |
| Základna | Bivariační korelace | Spearman |
cor(dfx2, method = "spearman") |
| Základna | Vícerozměrná korelace | Pearson |
cor(df, method = "pearson") |
| Základna | Vícerozměrná korelace | Spearman |
cor(df, method = "spearman") |
| Hmisc | Hodnota P | - |
rcorr(as.matrix(data[,1:9]))[["P"]] |
| GGally | Teplotní mapa | - |
ggcorr(df)
|
| GGally | Matice vícerozměrného grafu | - |
ggpairs(df, columns = c("x1", "x2")) |
