
R apply(), lapply(), sapply(), tapply() s příklady
 Evelyn Clarkeová
⚡ Chytré shrnutí
apply(), lapply(), sapply() a tapply() tvoří rodinu funkcí R apply, vektorizovanou alternativu k explicitním smyčkám, která aplikuje vybranou funkci na matice, seznamy, vektory a seskupená data a vrací stručné výsledky.
Tento tutoriál se zaměřuje na představení kolekce funkcí apply(). Funkce apply() je nejzákladnější z celé kolekce. Naučíme se také sapply(), lapply() a tapply(). Kolekci aplikací lze považovat za náhradu smyčky.
Kolekce apply() je součástí balíčku r zásadní balíček, pokud jste nainstalovat R s Anaconda. Funkce použít v R může být doplněna mnoha funkcemi pro provedení redundantní aplikace na kolekci objektů (datový rámec, seznam, vektor atd.). Účelem apply() je především vyhnout se explicitnímu použití konstrukcí smyček. Lze je použít pro vstupní seznam, matici nebo pole a použít funkci. Do apply() lze předat jakoukoli funkci.
funkce apply().
aplikovat() bere datový rámec nebo matici jako vstup a poskytuje výstup ve vektoru, seznamu nebo poli. Aplikovat funkce v R se primárně používá, aby se zabránilo explicitnímu použití konstrukcí smyček. Je to nejzákladnější ze všech kolekcí, které lze použít nad matricemi.
Tato funkce má 3 argumenty:
apply(X, MARGIN, FUN)
Here:
-x: an array or matrix
-MARGIN:  take a value or range between 1 and 2 to define where to apply the function:
-MARGIN=1`: the manipulation is performed on rows
-MARGIN=2`: the manipulation is performed on columns
-MARGIN=c(1,2)` the manipulation is performed on rows and columns
-FUN: tells which function to apply. Built functions like mean, median, sum, min, max and even user-defined functions can be applied>
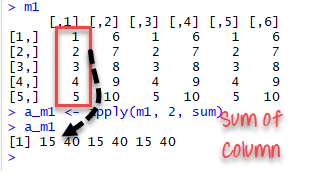
Nejjednodušším příkladem je sečíst matici přes všechny sloupce. Kód apply(m1, 2, sum) použije funkci součtu na matici 5×6 a vrátí součet každého sloupce dostupného v datové sadě.
m1 <- matrix(C<-(1:10),nrow=5, ncol=6)
m1
a_m1 <- apply(m1, 2, sum)
a_m1
Výstup:
Doporučený postup: Před tiskem do konzole hodnoty uložte.
funkce lapply().
lapply() Funkce je užitečná pro provádění operací s objekty seznamu a vrací objekt seznamu stejné délky jako původní sada. lappy() vrací seznam podobné délky jako vstupní objekt seznamu, jehož každý prvek je výsledkem aplikace FUN na odpovídající prvek seznamu. Lapply v R bere seznam, vektor nebo datový rámec jako vstup a dává výstup v seznamu.
lapply(X, FUN)
Arguments:
-X: A vector or an object
-FUN: Function applied to each element of x
l v lapply() znamená seznam. Rozdíl mezi lapply() a apply() spočívá mezi návratem výstupu. Výstupem lapply() je seznam. lapply() lze použít pro jiné objekty, jako jsou datové rámce a seznamy.
Funkce lapply() nepotřebuje MARGIN.
Velmi snadným příkladem může být změna hodnoty řetězce matice na malá písmena pomocí funkce tolower. Sestavíme matici s názvy slavných filmů. Název je ve formátu velkých písmen.
movies <- c("SPYDERMAN","BATMAN","VERTIGO","CHINATOWN")
movies_lower <-lapply(movies, tolower)
str(movies_lower)
Výstup:
## List of 4
## $:chr"spyderman"
## $:chr"batman"
## $:chr"vertigo"
## $:chr"chinatown"
K převedení seznamu na vektor můžeme použít unlist().
movies_lower <-unlist(lapply(movies,tolower))
str(movies_lower)
Výstup:
## chr [1:4] "spyderman" "batman" "vertigo" "chinatown"
funkce sapply().
sapply() funkce bere seznam, vektor nebo datový rámec jako vstup a dává výstup ve vektoru nebo matice. Je užitečný pro operace s objekty seznamu a vrací objekt seznamu stejné délky jako původní sada. Funkce Sapply v R dělá stejnou práci jako funkce lapply(), ale vrací vektor.
sapply(X, FUN)
Arguments:
-X: A vector or an object
-FUN: Function applied to each element of x
Můžeme změřit minimální rychlost a zastavitping vzdálenosti aut z datové sady aut.
dt <- cars
lmn_cars <- lapply(dt, min)
smn_cars <- sapply(dt, min)
lmn_cars
Výstup:
## $speed
## [1] 4
## $dist
## [1] 2
smn_cars
Výstup:
## speed  dist
##     4     2
lmxcars <- lapply(dt, max)
smxcars <- sapply(dt, max)
lmxcars
Výstup:
## $speed
## [1] 25
## $dist
## [1] 120
smxcars
Výstup:
## speed  dist
##    25   120
Můžeme použít uživatelskou vestavěnou funkci do lapply() nebo sapply(). Vytvoříme funkci s názvem avg pro výpočet průměru minima a maxima vektoru.
avg <- function(x) {
  ( min(x) + max(x) ) / 2}
fcars <- sapply(dt, avg)
fcars
Výstup
## speed  dist
##  14.5  61.0
Sapply v R je ve vráceném výstupu efektivnější než lapply(), protože sapply() ukládá hodnoty přímo do vektoru. V dalším příkladu uvidíme, že tomu tak není vždy.
Rozdíl mezi apply(), sapply() a `lapply() můžeme shrnout v následující tabulce:
| funkce | Argumenty | Objektivní | Vstup | Výstup |
|---|---|---|---|---|
| aplikovat | použít(x, MARGIN, FUN) | Použijte funkci na řádky nebo sloupce nebo obojí | Datový rámec nebo matice | vektor, seznam, pole |
| laply | lapply(X, FUN) | Použijte funkci na všechny prvky vstupu | Seznam, vektor nebo datový rámec | lest |
| šťáva | sappy(X, ZÁBAVA) | Použijte funkci na všechny prvky vstupu | Seznam, vektor nebo datový rámec | vektor nebo matice |
Výřez vektoru
K rozdělení datového rámce můžeme použít zaměnitelné lapply() nebo sapply(). Vytvoříme funkci under_average(), která vezme vektor číselných hodnot a vrátí vektor, který obsahuje pouze hodnoty, které jsou přísně nad průměrem. Oba výsledky porovnáme s funkcí identické().
below_ave <- function(x) {
    ave <- mean(x)
    return(x[x > ave])
}
dt_s<- sapply(dt, below_ave)
dt_l<- lapply(dt, below_ave)
identical(dt_s, dt_l)
Výstup:
## [1] TRUE
funkce tapply().
tapply() počítá míru (průměr, medián, min, max, atd..) nebo funkci pro každou proměnnou faktoru ve vektoru. Je to velmi užitečná funkce, která vám umožní vytvořit podmnožinu vektoru a poté aplikovat některé funkce na každou z podmnožin.
tapply(X, INDEX, FUN = NULL)
Arguments:
-X: An object, usually a vector
-INDEX: A list containing factor
-FUN: Function applied to each element of x
Součástí práce datového vědce nebo výzkumníků je počítat souhrny proměnných. Například změřte průměrná nebo skupinová data na základě charakteristiky. Většina dat je seskupena podle ID, města, zemí a tak dále. Shrnutí nad skupinou odhalí zajímavější vzorce.
Abychom pochopili, jak to funguje, použijme datovou sadu duhovky. Tato datová sada je velmi známá ve světě strojového učení. Účelem tohoto souboru dat je předpovědět třídu každého ze tří druhů květin: Sepal, Versicolor, Virginica. Soubor dat shromažďuje informace pro každý druh o jejich délce a šířce.
Jako předchozí práci můžeme vypočítat medián délky pro každý druh. Tapply v R je rychlý způsob, jak provést tento výpočet.
data(iris)
tapply(iris$Sepal.Width, iris$Species, median)
Výstup:
##     setosa versicolor  virginica
##        3.4        2.8        3.0
