
Склад за данни Archiструктура, компоненти и диаграма Concepts
 Дейвид Картър
⚡ Умно обобщение
Склад за данни ArchiСтруктурата определя как историческите и кумулативните данни от много източници са организирани в многопластови слоеве и свързани компоненти, което позволява надеждно отчитане, анализ и единна версия на истината за вземане на организационни решения и прогнозиране.
Склад за данни Concepts
A склад за данни съществува, за да предостави на компанията единна версия на истината за вземане на решения и прогнозиране. Това е информационна система, която съхранява исторически и кумулативни данни, извлечени от един или много източници.
Чрез организиране на тези данни за анализ, а не за транзакции, хранилището за данни опростява работата по отчитане и анализ на цялата организация.
Характеристики на Data Warehouse
Хранилището за данни има четири определящи характеристики, които го отличават от рутинната оперативна база данни:
- Предметно ориентиран
- Интегрирана
- Времеви вариант
- Енергонезависима
Предметно ориентиран
Хранилището за данни е ориентирано към дадена тема, защото предоставя информация за дадена тема, а не за текущите операции на компанията. Типични теми включват продажби, маркетинг и дистрибуция.
Вместо ежедневна обработка, хранилището набляга на моделирането и анализа за вземане на решения. То предлага опростен, сбит поглед върху всеки обект и пропуска данни, които не подкрепят процеса на вземане на решения.
Интегрирана
Интеграцията е тясно свързана с ориентацията към предмета. В хранилище за данни интеграцията означава установяване на обща мерна единица за всички подобни данни, извлечени от различни бази данни, и съхраняване на тези данни по общ, универсално приемлив начин.
Хранилището за данни се изгражда чрез интегриране на данни от различни източници, като например мейнфрейм, релационни бази данни и плоски файлове. То също така трябва да поддържа последователни конвенции за именуване, формати и кодиране.
Тази последователност в именуването, мерките на атрибутите и структурата на кодиране е това, което прави възможен ефективен анализ. Разгледайте следния пример:
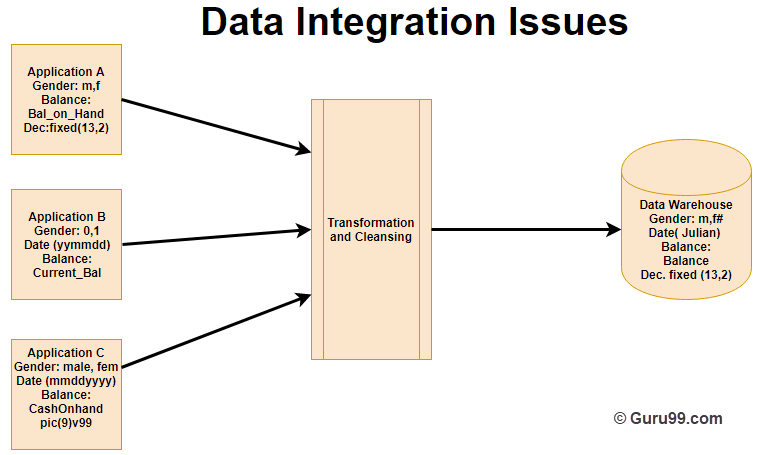
В горния пример, три приложения, обозначени с A, B и C, съхраняват информация за пол, дата и баланс, но всяко приложение я съхранява по различен начин:
- Приложение А съхранява полето за пол като логически стойности, като например М или Ж.
- Приложение Б съхранява полето за пол като числова стойност.
- Приложение C съхранява полето за пол като символна стойност.
- Същата вариация важи и за полетата „Дата“ и „Салдо“.
След процеса на трансформация и почистване, всички тези данни се съхраняват в общ формат в хранилището за данни.
Времеви вариант
Времевият хоризонт на едно хранилище за данни е много по-широк от този на една операционна система. Данните се разпознават с определен период и предлагат историческа гледна точка, така че винаги носят елемент на време, изрично или имплицитно.
Едно от местата, където се появява тази времева вариация, е в структурата на ключа на записа. Всеки първичен ключ в хранилището трябва да носи елемент от времето, като например ден, седмица или месец.
Друг аспект на времевата вариация е, че след като данните бъдат въведени в хранилището, те не могат да бъдат актуализирани или променяни.
Енергонезависима
Хранилището за данни е енергонезависимо, което означава, че по-ранните данни не се изтриват, когато постъпят нови. Данните са само за четене и се обновяват периодично, което помага на анализаторите да изучават исторически данни и да разбират какво се е случило и кога.
Тъй като не се нуждае от обработка на транзакции, възстановяване или контрол на паралелизма, хранилището за данни пропуска дейностите по изтриване, актуализиране и вмъкване, обичайни за оперативно приложение. В хранилището за данни се извършват само две операции с данни:
- Зареждане на данни
- Достъп до данни
Таблицата по-долу подчертава някои основни разлики между оперативно приложение и хранилище за данни:
| Operaционно приложение | Склад за данни |
|---|---|
| Сложната програма трябва да бъде кодирана, за да се гарантира, че процесите на надграждане на данни поддържат висока цялост на крайния продукт. | Този вид проблем не се случва, защото не се извършва актуализация на данните. |
| Данните се поставят в нормализирана форма, за да се осигури минимален излишък. | Данните не се съхраняват в нормализирана форма. |
| Технологията, необходима за поддръжка на проблеми с транзакции, възстановяване на данни, връщане към предишни операции и разрешаване на безизходици, е доста сложна. | Той предлага относителна простота в технологията. |
Склад за данни Archiтекстура
Склад за данни ArchiСтруктурата е сложна, защото системата съхранява исторически и кумулативни данни от множество източници. Има три подхода за изграждане на слоевете на хранилището: еднослоен, двуслоен и трислоен.
Еднослойна архитектура има за цел да минимизира количеството съхранявани данни чрез премахване на излишествата. Рядко се използва на практика.
Двустепенна архитектура разделя физически наличните източници от хранилището за данни. Не е лесно разширяем, поддържа по-малко крайни потребители и може да се сблъска с проблеми със свързаността поради мрежови ограничения.
Трислойна архитектура е най-широко използваният дизайн на хранилище за данни.
Състои се от горен, среден и долен слой:
- Долно ниво: Базата данни на хранилището служи като най-долното ниво. Обикновено това е релационна система за бази данни, а данните се почистват, трансформират и зареждат в това ниво с помощта на back-end инструменти.
- Средно ниво: Средният слой е OLAP сървър, реализиран с помощта на ROLAP или MOLAP модела. Той представя абстрактенtracпреглежда базата данни и действа като посредник между крайния потребител и базата данни.
- Най-високо ниво: Най-горният слой е клиентски слой от front-end класа. Той съдържа инструментите и API-тата, използвани за свързване и извличане на данни от хранилището, като например инструменти за заявки, инструменти за отчитане, инструменти за управлявани заявки, инструменти за анализ и инструменти за извличане на данни.
Компоненти на Datawarehouse
Компонентите и цялостната архитектура на хранилището за данни работят заедно, както е показано на диаграмата по-долу.
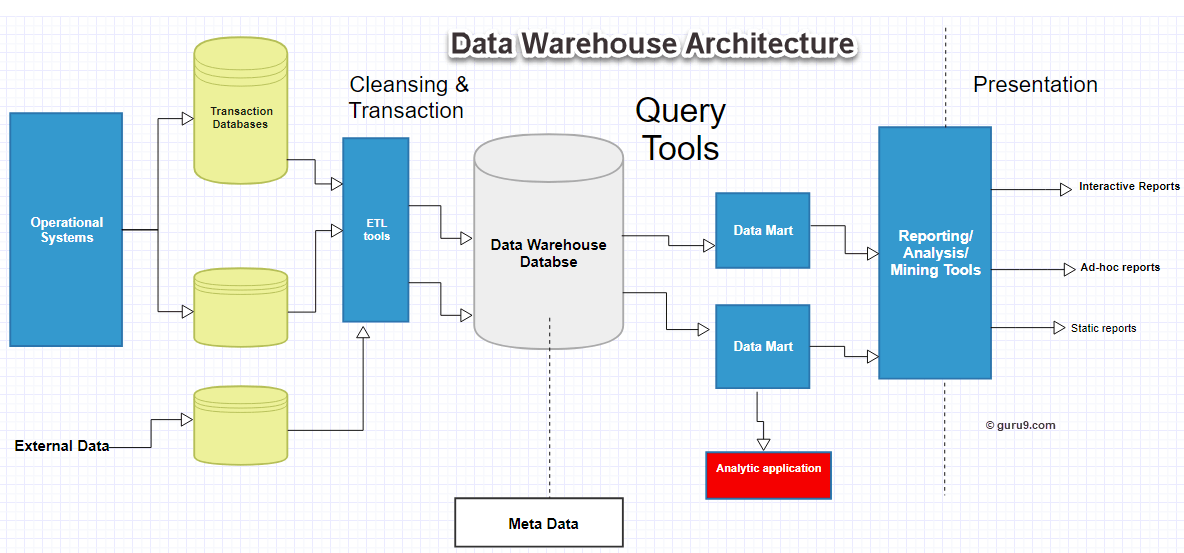
Хранилището за данни е базирано на RDBMS сървър, централно хранилище за информация, заобиколено от ключови компоненти, които поддържат цялата среда функционална, управляема и достъпна.
Хранилището за данни има пет основни компонента, описани по-долу.
Data Warehouse База данни
Централната база данни е основата на складовата среда и е внедрена на RDBMS технология. Тъй като традиционната RDBMS е настроена за обработка на транзакции, а не за складиране, ресурсоемките операции, като например ad-hoc заявки, многотаблицни съединения и агрегати, могат да я забавят.
Поради тази причина се използват алтернативни подходи към базата данни:
- Релационните бази данни се разполагат паралелно, за да се осигури мащабируемост, като се използват модели със споделена памет или без споделена памет на различни многопроцесорни или масово паралелни конфигурации.
- Използват се нови индексни структури, за да се заобиколи сканирането на релационни таблици и да се подобри скоростта.
- Многомерните бази данни (MDDB) се използват за преодоляване на ограниченията на моделите на релационните складове. Пример за това е Essbase от Oracle.
Инструменти за снабдяване, придобиване, почистване и трансформация (ETL)
Инструментите за извличане, трансформация и миграция на данни извършват всички преобразувания, обобщавания и промени, необходими за превръщането на данните в унифициран формат за съхранение. Те се наричат още Ex.tracинструменти за t, трансформация и зареждане (ETL).
Тяхната функционалност включва следното:
- Анонимизирайте данните според нормативните разпоредби.
- Премахнете нежеланите данни от оперативните бази данни, преди да ги заредите в склада.
- Търсене и замяна на общи имена и дефиниции за данни, пристигащи от различни източници.
- Изчисляване на обобщения и производни данни.
- Попълнете липсващите данни със стойности по подразбиране.
- Премахнете дублиращите се повтарящи се данни, постъпващи от множество източници.
тези ETL инструменти може да генерира cron задачи, фонови задачи, Cobol програми и shell скриптове, които редовно обновяват хранилището и помагат за поддържането на метаданните.
Тъй като черпят от много системи, ETL инструментите трябва да се справят и с хетерогенността на базите данни и данните.
Metadata
Метаданните може да звучат сложно, но те са просто данни за данни, които определят хранилището. Те се използват за изграждането, поддръжката и управлението на хранилището.
В рамките на архитектурата, метаданните определят източника, употребата, стойностите и характеристиките на данните и дефинират как данните могат да бъдат променяни и обработвани, така че да останат тясно свързани с хранилището.
Например, един ред в база данни за продажби може да съдържа:
4030 KJ732 299.90
Това е безсмислено, докато метаданните не обяснят, че представлява номер на модел 4030, идентификационен номер на търговски агент KJ732 и обща сума на продажбите от $299.90.
Следователно метаданните са съществена съставка за превръщането на данните в знания и помагат да се отговорят на въпроси като:
- Какви таблици, атрибути и ключове съдържа хранилището?
- Откъде идват данните?
- Колко пъти се презареждат данните?
- Какви трансформации и прочиствания бяха приложени?
Метаданните се разделят на две категории:
- Технически метаданни: Това описва склада за дизайнерите и администраторите, които го изграждат и управляват.
- Бизнес метаданни: Това дава на крайните потребители лесен начин да разберат информацията, съхранявана в склада.
Инструменти за заявки
Основна цел на хранилището за данни е да предостави на бизнеса информацията, от която се нуждаят, за да вземат стратегически решения, а инструментите за заявки са начинът, по който потребителите взаимодействат със системата.
Тези инструменти се разделят на четири категории:
- Инструменти за заявки и отчети
- Инструменти за разработка на приложения
- Инструменти за извличане на данни
- OLAP инструменти
Инструменти за заявки и отчети
Инструментите за заявки и отчети се разделят на две групи: инструменти за отчети и инструменти за управлявани заявки.
Инструменти за отчитане разделени допълнително на инструменти за отчитане на производството и инструменти за създаване на отчети за настолни компютри:
- Автори на доклада: Те са предназначени за крайни потребители, които изграждат свои собствени анализи.
- Отчитане на производството: Те позволяват на организациите да генерират редовни оперативни отчети и да поддържат големи пакетни задачи, като например печат и изчисления. Популярни примери включват Brio, Business Objects, Oracle, PowerSoft и SAS Institute.
Инструменти за управлявани заявки помагат на крайните потребители, като вмъкват мета-слой между потребителя и базата данни, което скрива сложността на SQL и структурата на базата данни.
Инструменти за разработка на приложения
Когато вградените графични и аналитични инструменти не могат да отговорят на аналитичните нужди на организацията, се изграждат персонализирани отчети с инструменти за разработка на приложения.
Инструменти за извличане на данни
Извличането на данни открива значими нови корелации, модели и тенденции в големи обеми от данни, а инструментите за извличане на данни автоматизират това откриване.
OLAP инструменти
OLAP Инструментите са изградени върху многомерна база данни и позволяват на потребителите да анализират данни чрез сложни, многомерни изгледи.
Шина за хранилище на данни Archiтекстура
Шината на хранилището за данни определя как данните преминават през него. Този поток може да бъде категоризиран като входящ, възходящ, низходящ, изходящ и мета-поток.
Когато проектирате шината, трябва да вземете предвид споделените измерения и факти, които обхващат информационните мрежови хранилища.
Мартове за данни
A данни март е слой за достъп, използван за предоставяне на данни на потребителите. Подходящ е за големи складове, защото изграждането му отнема по-малко време и пари, въпреки че няма единно съгласувано определение за склад за данни.
Най-просто казано, data mart е дъщерно дружество на хранилище за данни. То разделя данните за определена група потребители и може да се намира в същата база данни като хранилището или във физически отделна такава.
Склад за данни ArchiНай-добри практики на tecture
За да проектирате надеждна архитектура на хранилище за данни, следвайте най-добрите практики по-долу:
- Използвайте модели на хранилища за данни, оптимизирани за извличане на информация, независимо дали размерите, денормализиран или хибриден подход.
- Изберете подходящ подход към дизайна, независимо дали е отгоре надолу или отдолу нагоре.
- Уверете се, че данните се обработват бързо и точно, като същевременно ги консолидирате в една единствена версия на истината.
- Внимателно проектирайте процеса на събиране и почистване на данни за склада.
- Проектирайте архитектура на метаданни, която позволява споделянето на метаданни между компонентите на хранилището.
- Помислете за Operaмодел на хранилище за данни (ODS), когато нуждите от извличане са близо до дъното на абстракта с данниtracционна пирамида или когато трябва да се осъществи достъп до множество оперативни източници.
- Уверете се, че моделът на данните е интегриран, а не просто консолидиран; в този случай използвайте 3NF модел на данни, който е идеален и при придобиване на ETL и инструменти за почистване на данни.
