
الانتشار العكسي في الشبكات العصبية: خوارزمية التعلم الآلي ومثال
 فريق التحرير
⚡ ملخص ذكي
يعتبر الانتشار العكسي خوارزمية التدريب الأساسية للشبكة العصبية، حيث يقوم بضبط كل وزن بدقة من الخطأ المقاس في الحقبة السابقة بحيث يعمم النموذج بشكل أفضل على البيانات غير المرئية، طبقة تلو الأخرى.
ما هي الشبكة العصبية الاصطناعية؟
الشبكة العصبية الاصطناعية هي مجموعة من وحدات الإدخال/الإخراج المتصلة، حيث يحمل كل اتصال وزنًا. تساعد هذه الشبكة في بناء نماذج تنبؤية من قواعد بيانات ضخمة، ويستوحي تصميمها مفرداته من الجهاز العصبي البشري. تدعم هذه الشبكات فهم الصور، والتعلم الآلي، والنطق الحاسوبي، والعديد من مهام التعرف على الأنماط الأخرى.
إن خوارزمية الانتشار العكسي هي التي تحدد ما يجب أن تكون عليه تلك الأوزان، لذا من الأفضل قراءة الفكرتين معًا.
ما هو انتشار العكسي؟
يُعدّ الانتشار العكسي جوهر تدريب الشبكات العصبية. وهو أسلوب لضبط أوزان الشبكة العصبية بدقة بناءً على معدل الخطأ المُسجّل في الدورة التدريبية السابقة (أي التكرار). يُتيح الضبط الدقيق للأوزان تقليل معدلات الخطأ وجعل النموذج أكثر موثوقية من خلال زيادة قدرته على التعميم.
يعد الانتشار العكسي في الشبكة العصبية نموذجًا قصيرًا لـ "الانتشار العكسي للأخطاء". إنها طريقة قياسية لتدريب الشبكات العصبية الاصطناعية. تساعد هذه الطريقة في حساب تدرج دالة الخسارة فيما يتعلق بجميع الأوزان الموجودة في الشبكة.
مصطلحان غالباً ما يتم الخلط بينهما. الانتشار العكسي فقط يحسب التدرج؛ مُحسِّن مثل خوارزمية التدرج الهبوطي هو ما يحدث فعليًا التغييرات الأوزان باستخدام هذا التدرج. تقريبًا كل إطار عمل حديث يقوم بعملية الانتشار العكسي تلقائيًا من خلال محرك التفاضل التلقائي الخاص به.
كيف تعمل خوارزمية الانتشار العكسي
تحسب خوارزمية الانتشار العكسي في الشبكات العصبية تدرج دالة الخسارة لوزن واحد باستخدام قاعدة السلسلة. وهي تحسب بكفاءة طبقة واحدة في كل مرة، على عكس الحساب المباشر البسيط. تحسب هذه الخوارزمية التدرج، لكنها لا تحدد كيفية استخدامه. وهي تعمم الحساب في قاعدة دلتا.
إن قاعدة السلسلة هي ما يجعل هذه الطريقة فعالة. فتأثير وزن مبكر واحد على الخسارة النهائية هو نتاج المشتقات المحلية على طول المسار المؤدي إلى المخرج، لذا تقوم الخوارزمية بتخزين النتيجة الوسيطة لكل طبقة في طريق العودة، وتعيد استخدامها لكل وزن في الطبقة التي تليها، بدلاً من إعادة حساب الشبكة بأكملها لكل وزن.
انظر إلى الرسم التخطيطي التالي لمثال شبكة عصبية ذات انتشار عكسي لفهمها. الشكل tracتمريرة كاملة واحدة: تدخل المدخلات من اليسار، وتتحرك التنشيطات للأمام عبر الطبقة المخفية إلى المخرجات، ثم ينتقل الخطأ المقاس مرة أخرى على طول نفس الاتصالات لتصحيح الأوزان.
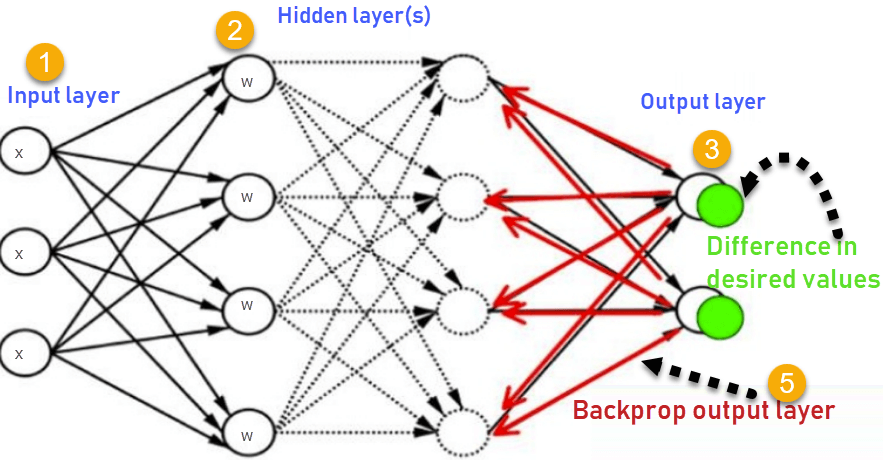
- تصل المدخلات X عبر المسار المتصل مسبقًا
- يتم تصميم المدخلات باستخدام الأوزان الحقيقية W. وعادة ما يتم اختيار الأوزان بشكل عشوائي.
- احسب الناتج لكل خلية عصبية من طبقة الإدخال، إلى الطبقات المخفية، إلى طبقة الإخراج.
- احسب الخطأ في المخرجات:
ErrorB= Actual Output – Desired Output
- قم بالرجوع من طبقة الإخراج إلى الطبقة المخفية لضبط الأوزان بحيث يتم تقليل الخطأ.
- استمر في تكرار العملية حتى يتم تحقيق النتيجة المرجوة.
تكتب العديد من الكتب المدرسية نفس الكمية كما المطلوب ناقص الفعليكلا الاصطلاحين يعمل، لأن الإشارة تُستوعب عندما يقوم المُحسِّن الفرعيtracts the gradient, prefided you keep one convention across the network.
في الواقع، نادراً ما يكون الخطأ مجرد جزء فرعي بسيط.traction. تقوم دالة الخسارة مثل متوسط مربع الخطأ للانحدار، أو الانتروبيا المتقاطعة للتصنيف، بتحويل الفروق لكل مخرج إلى رقم واحد يتم حسابه فعليًا بواسطة الانتشار العكسي للتدرج.
لماذا نحتاج إلى الانتشار العكسي؟
أبرز مزايا Backpropagation هي:
- يعد الانتشار العكسي سريعًا وبسيطًا وسهل البرمجة
- لا يضيف أي معايير جديدة خاصة به؛ فالتعديل الذي تقوم به يعود إلى المُحسِّن والشبكة، وخاصةً معدل التعلم وعدد المدخلات.
- إنها طريقة مرنة لأنها لا تتطلب معرفة مسبقة بالشبكة
- إنها طريقة قياسية تعمل بشكل جيد بشكل عام
- لا يحتاج الأمر إلى أي ذكر خاص لميزات الوظيفة المراد تعلمها.
ببساطة، بدون طريقة فعالة للحصول على التدرجات، فإن تدريب أي شيء أعمق من طبقة واحدة سيكون غير عملي من الناحية الحسابية.
ما هي شبكة التغذية إلى الأمام؟
الشبكة العصبية المغذية هي شبكة عصبية اصطناعية حيث لا تشكل العقد دورة أبدًا. يحتوي هذا النوع من الشبكات العصبية على طبقة إدخال وطبقات مخفية وطبقة إخراج. إنه أول وأبسط نوع من الشبكات العصبية الاصطناعية.
إن التمييز مهم هنا لأن المرور الأمامي للانتشار العكسي هو بالضبط مرور أمامي؛ فقط تصحيح الخطأ يعمل في الاتجاه المعاكس.
أنواع شبكات الانتشار العكسي
هناك نوعان من شبكات الانتشار العكسي هما:
- ثابت الانتشار الخلفي
- الانتشار العكسي المتكرر
الانتشار الخلفي الساكن
هو أحد أنواع شبكات الانتشار العكسي التي تنتج خريطةping يُستخدم هذا الأسلوب مع مدخلات ثابتة للحصول على مخرجات ثابتة. وهو مفيد لحل مشكلات التصنيف الثابتة مثل التعرف الضوئي على الأحرف.
الانتشار العكسي المتكرر
الانتشار العكسي المتكرر في استخراج البيانات يتم تمرير البيانات للأمام حتى يتم الوصول إلى قيمة ثابتة. بعد ذلك، يتم حساب الخطأ ونشره للخلف.
الفرق الرئيسي بين هاتين الطريقتين هو: أن الخريطةping تكون هذه الطريقة سريعة في الانتشار العكسي الثابت، بينما تكون غير ثابتة في الانتشار العكسي المتكرر. يوضح الجدول أدناه المقارنتين جنبًا إلى جنب.
| معيار | الانتشار الخلفي الساكن | الانتشار العكسي المتكرر |
|---|---|---|
| التخطيط | مدخل ثابت إلى مخرج ثابت | غير ثابت؛ تستقر الشبكة قبل استخدام الخطأ |
| سرعة | سريع، تمريرة واحدة لكل عينة | ببطء، يتم تكرار التنشيط حتى يستقر. |
| شكل الشبكة | التغذية الأمامية، بدون دورات | يحتوي على وصلة تغذية راجعة |
| الاستخدام النموذجي | التعرف الضوئي على الأحرف، تصنيف الحجم الثابت | المشاكل التي تعتمد مخرجاتها على حالة داخلية مستقرة |
تاريخ الانتشار العكسي
- في عام 1961، تم اشتقاق المفهوم الأساسي للانتشار العكسي المستمر في سياق نظرية التحكم بواسطة ج. كيلي، وهنري آرثر، وإي. برايسون.
- في عام 1969، قدم برايسون وهو طريقة لتحسين النظام الديناميكي متعدد المراحل.
- في عام 1970، نشر سيبو لينينما الوضع العكسي للتفاضل التلقائي، وهي الطريقة الحسابية التي بُنيت عليها عملية الانتشار العكسي الحديثة.
- وفي عام 1974، ذكر وربوس إمكانية تطبيق هذا المبدأ في الشبكة العصبية الاصطناعية.
- في عام 1982، طرح هوبفيلد فكرته عن الشبكة العصبية.
- في عام 1986، وبجهود ديفيد إي. روميلهارت، وجيفري إي. هينتون، ورونالد جيه. ويليامز، اكتسب الانتشار العكسي الاعتراف.
- في عام 1989، قام يان ليكان وزملاؤه بتدريب شبكة عصبية تلافيفية باستخدام الانتشار العكسي لقراءة الأرقام المكتوبة بخط اليد، وهو أحد الاستخدامات العملية الأولى واسعة النطاق.
- في عام 1993، كان وان أول شخص يفوز في مسابقة دولية للتعرف على الأنماط بمساعدة طريقة الانتشار العكسي.
- في عام 2006، أعاد عمل هينتون على شبكات الاعتقاد العميق والتدريب المسبق على مستوى الطبقات إحياء الاهتمام بتدريب الشبكات العميقة، التي كانت قد توقفت بسبب تلاشي التدرجات.
- في عام 2010، قام كل من خافيير غلوروت ويوشوا بينجيو بتحليل سبب صعوبة تدريب الشبكات العميقة وقدموا تهيئة محسّنة للأوزان، والتي جعلت عملية الانتشار العكسي العميق عملية عملية إلى جانب تنشيطات ReLU.
- في عام 2012، فاز AlexNet (Krizhevsky و Sutskever و Hinton) بمسابقة ImageNet باستخدام الانتشار العكسي المعجل بواسطة وحدة معالجة الرسومات، مما أدى إلى إطلاق طفرة التعلم العميق الحديثة.
- في عام 2014، تم تقديم مُحسِّن آدم (كينغما وبا) وسرعان ما أصبح متغير التدرج الهبوطي الافتراضي المستخدم مع الانتشار العكسي.
- في عام 2015، حلت عملية تطبيع الدفعات والشبكات المتبقية (ResNet) مشاكل تدفق التدرج في الشبكات العميقة جدًا، مما يسمح بالانتشار العكسي عبر مئات الطبقات.
- في الفترة من 2015 إلى 2017، تم استخدام TensorFlow وPyTorجعل برنامج ch التفاضل التلقائي ميزة برمجية قياسية، لذلك لم يعد من الضروري اشتقاق التدرجات يدويًا.
- في عام 2017، تم تقديم بنية Transformer، ويتم تدريبها من البداية إلى النهاية باستخدام الانتشار العكسي، كما هو الحال مع نماذج اللغة الكبيرة المبنية عليها.
- في عام 2019، حصل كل من بينجيو وهينتون وليكون على جائزة ACM AM Turing لعملهم على الشبكات العصبية العميقة.
- في عام 2020، جادلت الورقة البحثية "الانتشار العكسي والدماغ" (ليليكراب، سانتورو، ماريس، أكرمان، وهينتون) بأن الدماغ قد يقترب من التعلم الشبيه بالانتشار العكسي، مما أعاد فتح النقاش حول المعقولية البيولوجية.
- في عام 2022، اقترح هينتون خوارزمية Forward-Forward، وهي طريقة تدريب تتجنب المرور العكسي تمامًا.
- في عام 2024، مُنح جون هوبفيلد وجيفري هينتون جائزة نوبل في الفيزياء لاكتشافاتهما الأساسية التي مكنت من التعلم الآلي باستخدام الشبكات العصبية الاصطناعية.
- في عام 2025، تم توسيع أساليب التوجيه الأمامي لتشمل الشبكات الالتفافية، مما أظهر أن التدريب الخالي من الانتشار العكسي يمكن أن ينجح في مهام تصنيف الصور.
- اعتبارًا من عام 2026، لا تزال خوارزمية الانتشار العكسي هي خوارزمية التدريب القياسية لجميع نماذج التعلم العميق تقريبًا، بينما يستمر البحث في طرق التعلم المحلية والمتوازية الخالية من التدرج والتي تقلل من تكلفة الذاكرة والحساب.
النقاط الرئيسية للانتشار العكسي
- يبسط بنية الشبكة عن طريق إزالة الروابط الموزونة التي لها أقل تأثير على الشبكة المدربة.
- تحتاج إلى دراسة مجموعة من قيم الإدخال والتنشيط لتطوير العلاقة بين طبقات الإدخال وطبقات الوحدة المخفية.
- فهو يساعد على تقييم تأثير متغير الإدخال المحدد على مخرجات الشبكة. وينبغي تمثيل المعرفة المكتسبة من هذا التحليل في القواعد.
- يعد الانتشار العكسي مفيدًا بشكل خاص للشبكات العصبية العميقة التي تعمل على المشاريع المعرضة للأخطاء، مثل التعرف على الصور أو الكلام.
- تستفيد عملية الانتشار العكسي من قواعد السلسلة والقوة، مما يسمح لها بالعمل مع أي عدد من المخرجات.
أفضل ممارسة للانتشار العكسي
يمكن شرح عملية الانتشار العكسي في الشبكات العصبية باستخدام تشبيه "رباط الحذاء". تتصرف تحديثات الأوزان بشكل مشابه لشد الرباط: إذا كان الشد قليلاً جدًا، فلن يتماسك الرباط، وإذا كان كثيرًا جدًا، فسيتمزق.
| شد الرباط | ماذا يعني ذلك أثناء التدريب؟ |
|---|---|
| توتر قليل جداً | لا توجد قيود كافية، والنموذج فضفاض للغاية - فهو لا يتناسب مع البيانات. |
| توتر شديد | القيود المفرطة (التدريب الزائد)؛ استغراق وقت طويل (عملية بطيئة نسبياً)؛ احتمالية أكبر للفشل |
| شد أحد الرباطين أكثر من الآخر | عدم الارتياح (التحيز) - يهيمن جزء واحد من الشبكة على التوافق |
ينتج عن هذا التشبيه عادتان عمليتان: الأولى هي ضبط حجم المدخلات قبل التدريب بحيث لا تؤثر أي ميزة بشكل أكبر من غيرها، والثانية هي مراقبة خسارة التحقق من الصحة بحيث يتم تخفيف التوتر قبل حدوث الإفراط في التدريب.
عيوب استخدام Backpropagation
- يعتمد الأداء الفعلي للانتشار العكسي في مشكلة معينة على البيانات المدخلة.
- يمكن أن تكون خوارزمية الانتشار الخلفي في استخراج البيانات حساسة جدًا للبيانات الصاخبة
- عند معالجة دفعة صغيرة، يجب تطبيق خوارزمية الانتشار العكسي باستخدام أسلوب قائم على المصفوفات؛ انظرping معالجة مثال واحد في كل مرة أبطأ بشكل ملحوظ.
- في الشبكات العميقة، يمكن أن يؤدي الضرب المتكرر للمشتقات الصغيرة إلى تقليص التدرجات نحو الصفر، لذا فإن الطبقات الأولى بالكاد تتعلم - وهي مشكلة تلاشي التدرج الموصوفة في Google دورة مكثفة لتعلم الآلة.
لا يستبعد أي من هذه العوامل استخدام هذه الطريقة. بل هي الأسباب التي تدفع الممارسين إلى اللجوء إلى دوال التنشيط ReLU، والتطبيع، وجداول معدل التعلم الدقيقة عند الانتقال من شبكة سطحية إلى شبكة أكثر عمقًا. التعلم العميق نموذج.
