
ما هو التعلم المعزز؟ أنواعه، Algorithms & مثال
 إيفلين كلارك
⚡ ملخص ذكي
التعلم المعزز هو أسلوب من أساليب التعلم الآلي حيث يتعلم وكيل البرمجيات من خلال العمل داخل بيئة معينة، وجمع المكافآت أو العقوبات، وتعديل سلوكه لزيادة المكافأة التراكمية إلى أقصى حد على مدى خطوات عديدة.
ما هو التعلم المعزز؟
تعزيز التعلم هو تعلم آلة أسلوب يهتم بكيفية اتخاذ البرامج الذكية للقرارات في بيئة معينة. لا تُعرض على البرنامج إجابات صحيحة، بل يتعلم من المكافأة التي يتلقاها ويُعدّل سلوكه لزيادة المكافأة التراكمية إلى أقصى حد.
يُعدّ التعلّم المعزز فرعاً مستقلاً من فروع التعلّم الآلي، إلى جانب أشرف و غير خاضعة للرقابة التعلم. عندما يتم تمثيل سياسة الوكيل أو دالة قيمته بواسطة شبكة عصبية، يُطلق على هذا المزيج اسم التعلم. التعلم المعزز العميق — هذا الاقتران هو ما يسمح للوكيل بتحقيق هدف معقد أو زيادة بُعد معين إلى أقصى حد على مدى خطوات عديدة.
المكونات المهمة لأسلوب التعلم المعزز
قبل أن تصبح الخوارزميات مفهومة، من المفيد تسمية أجزائها. يوضح الرسم البياني أدناه كيف تتكامل عناصر الوكيل والبيئة والفعل وإشارة المكافأة في حلقة واحدة.
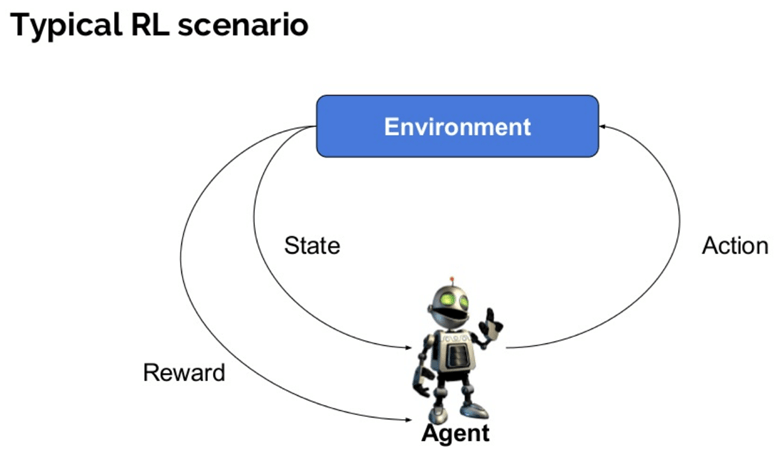
فيما يلي بعض المصطلحات المهمة المستخدمة في التعلم المعزز:
- وكيل: الكيان الذي يقوم بأفعال في بيئة ما للحصول على مكافأة ما.
- البيئة (هـ): السيناريو الذي يجب على الوكيل مواجهته.
- المكافأة (ص): عائد فوري يُمنح للوكيل عند قيامه بعمل أو مهمة محددة.
- تنص على): تشير الحالة إلى الوضع الحالي الذي أعادته البيئة.
- السياسة (π): الاستراتيجية التي يطبقها الوكيل لتحديد الإجراء التالي بناءً على الحالة الحالية.
- القيمة (الخامس): العائد المتوقع على المدى الطويل مع الخصم، مقارنة بالمكافأة قصيرة الأجل.
- وظيفة القيمة: يحدد قيمة الحالة، أي إجمالي مقدار المكافأة التي يمكن أن يتوقعها الوكيل بدءًا من تلك الحالة.
- نموذج البيئة: يحاكي هذا سلوك البيئة، مما يسمح لك باستخلاص النتائج وتحديد كيفية تصرف البيئة.
- الأساليب القائمة على النماذج: الأساليب التي تحل مشاكل التعلم المعزز عن طريق تعلم أو استخدام نموذج للبيئة أولاً، ثم التخطيط بناءً عليه.
- قيمة Q أو قيمة الإجراء (Q): قيمة Q مشابهة تمامًا لقيمة . الفرق الوحيد بينهما هو أن قيمة Q تأخذ مُعاملًا إضافيًا، وهو الإجراء الحالي.
كيف يعمل التعلم المعزز؟
إن استخدام تشبيه من الحياة اليومية يوضح الآلية قبل ظهور أي رموز.
تخيل سيناريو تعليم قطتك حيلًا جديدة.
- بما أن القطة لا تفهم الإنجليزية أو أي لغة بشرية أخرى، فلا يمكننا إخبارها مباشرة بما يجب عليها فعله. بدلاً من ذلك، نتبع استراتيجية مختلفة.
- نقوم بمحاكاة موقف معين، وتحاول القطة الاستجابة بطرق مختلفة. إذا كانت استجابة القطة هي الاستجابة المرغوبة، فإننا نقدم لها السمك.
- والآن كلما تعرضت القطة لنفس الموقف، فإنها تقوم بعمل مماثل بحماس أكبر، على أمل الحصول على المزيد من المكافأة (الطعام).
- هذا هو التعلم الذي تحصل عليه القطة حول "ما يجب فعله" من التجارب الإيجابية.
- وفي الوقت نفسه، يتعلم القط أيضاً ما لا يجب فعله عند مواجهة التجارب السلبية.
مثال على التعلم المعزز
يوضح الشكل أدناه قصة القطة تلك على الحلقة الرسمية، حيث يمثل المنزل البيئة والسمكة المكافأة.
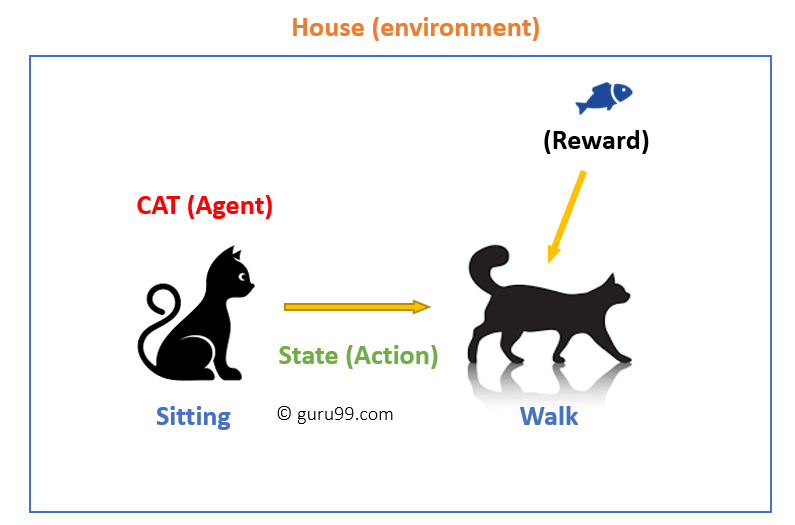
في هذه الحالة،
- قطتك كائن حيّ يتأثر بالبيئة المحيطة، وفي هذه الحالة، بمنزلك. مثال على ذلك: قطتك جالسة، وأنت تستخدم كلمة معينة لتجعلها تمشي.
- يتفاعل وكيلنا من خلال إجراء انتقال من "حالة" إلى "حالة" أخرى.
- على سبيل المثال، تنتقل قطتك من الجلوس إلى المشي.
- رد فعل العامل هو إجراء، والسياسة هي طريقة لاختيار إجراء معين في حالة توقع نتائج أفضل.
- بعد عملية الانتقال، قد يحصل الوكيل على مكافأة أو عقوبة في المقابل.
تعزيز التعلم Algorithms
هناك ثلاثة مناهج لتطبيق خوارزمية التعلم المعزز، وتختلف بشكل أساسي في ما يخزنه العامل ويتعلمه.
على أساس القيمة
في أسلوب التعلم المعزز القائم على القيمة، تسعى إلى تعظيم دالة القيمة V(s). في هذا الأسلوب، يتوقع العامل عائدًا طويل الأجل للحالات الحالية في ظل السياسة π.
على أساس السياسة
في طريقة التعلم المعزز القائمة على السياسات، تحاول التوصل إلى سياسة بحيث يساعدك الإجراء الذي يتم تنفيذه في كل حالة على تحقيق أقصى قدر من المكافأة في المستقبل.
هناك نوعان من الأساليب القائمة على السياسات هما:
- حتمية: بالنسبة لأي حالة، يتم إنتاج نفس الإجراء بواسطة السياسة π.
- العشوائية: لكل فعل احتمال معين، يُعطى بالمعادلة التالية.
السياسة العشوائية:
π(a|s) = P[At = a | St = s]
على أساس النموذج
في طريقة التعلم المعزز هذه، تقوم بإنشاء نموذج افتراضي لكل بيئة. ويتعلم العامل كيفية الأداء في تلك البيئة المحددة.
خصائص التعلم المعزز
فيما يلي بعض الخصائص المهمة للتعلم المعزز:
- لا يوجد مشرف، فقط رقم حقيقي أو إشارة مكافأة
- اتخاذ القرار بشكل تسلسلي
- يلعب الوقت دورًا حاسمًا في مشاكل التعزيز
- غالباً ما تكون ردود الفعل متأخرة وليست فورية.
- تحدد إجراءات الوكيل البيانات اللاحقة التي يتلقاها
أنواع التعلم المعزز
كلمة "التعزيز" مستعارة من علم النفس السلوكي، وتأتي في شكلين:
الإيجابية:
يُعرَّف بأنه حدث يقع نتيجة سلوك معين. وهو يزيد من قوة السلوك وتكراره، ويؤثر إيجاباً على الفعل الذي يقوم به الفاعل.
يساعدك هذا النوع من التعزيز على تحقيق أقصى قدر من الأداء والحفاظ على التغيير لفترة أطول. مع ذلك، قد يؤدي الإفراط في التعزيز إلى تحسين مفرط للحالة، مما قد يؤثر على النتائج.
نفي:
يُعرَّف التعزيز السلبي بأنه تقوية السلوك الناتج عن حالة سلبية كان ينبغي إيقافها أو تجنبها. ويساعدك هذا الأسلوب على تحديد الحد الأدنى من معايير الأداء. إلا أن عيبه يكمن في أنه يوفر فقط ما يكفي لتلبية الحد الأدنى من السلوك المطلوب.
نماذج التعلم من التعزيز
هناك نموذجان تعليميان مهمان في التعلم المعزز:
- عملية اتخاذ القرار ماركوف
- س التعلم
عملية اتخاذ القرار ماركوف
يتم استخدام المعلمات التالية للحصول على الحل:
- مجموعة من الإجراءات – أ
- مجموعة من الحالات – S
- المكافأة – R
- السياسة – π
- القيمة – V
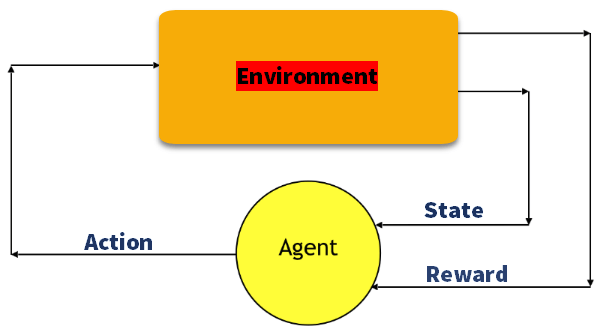
النهج الرياضي للخريطةping يُصاغ الحل في التعلم المعزز على شكل عملية قرار ماركوف، أو MDP. يوضح المخطط أدناه تلك المعلمات الخمس المتصلة في نفس دورة العامل والبيئة.
Q- التعلم
التعلم Q هو أسلوب قائم على القيمة لتوفير المعلومات التي تخبر الوكيل بالإجراء الذي يجب اتخاذه.
دعونا نفهم هذه الطريقة من خلال المثال التالي:
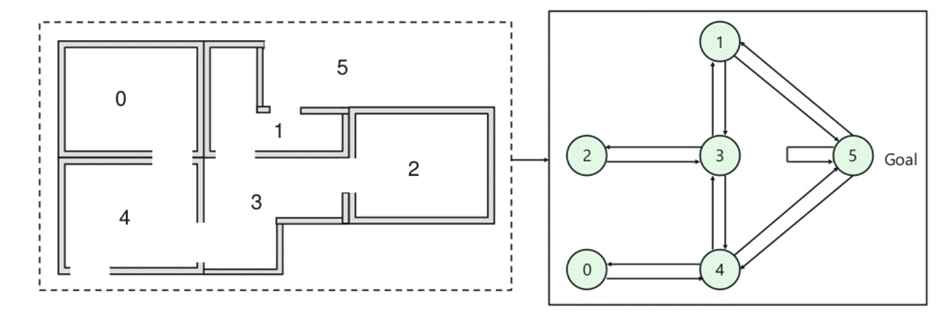
- توجد خمس غرف في المبنى متصلة بأبواب.
- كل غرفة مرقمة من 0 إلى 4
- يمكن اعتبار الجزء الخارجي من المبنى منطقة خارجية كبيرة واحدة (5)
- يؤدي البابان رقم 1 و4 إلى المبنى من الغرفة رقم 5
يوضح مخطط الطابق أدناه أرقام تلك الغرف والأبواب التي تربطها.
بعد ذلك، عليك ربط قيمة مكافأة بكل باب:
- الأبواب التي تؤدي مباشرة إلى الهدف لها مكافأة قدرها 100
- الأبواب التي لا تتصل مباشرة بالغرفة المستهدفة لا تُعطي أي مكافأة
- بما أن الأبواب ثنائية الاتجاه، يتم تخصيص سهمين لكل غرفة
- كل سهم في الصورة أعلاه يحمل قيمة مكافأة فورية
التفسير: في هذه الصورة، تمثل كل غرفة حالة، وتمثل حركة العامل من غرفة إلى أخرى فعلًا.
في الرسم البياني أدناه، يتم رسم الحالة كعقدة بينما تُظهر الأسهم الإجراءات المتاحة والمكافأة المرتبطة بكل منها.

على سبيل المثال، ينتقل أحد العملاء من الغرفة رقم 2 إلى الغرفة رقم 5:
- الحالة الأولية = الحالة 2
- الحالة 2-> الحالة 3
- الحالة 3 -> الحالة (2,1,4،XNUMX،XNUMX)
- الحالة 4-> الحالة (0,5,3)
- الحالة 1-> الحالة (5,3)
- الحالة 0-> الحالة 4
التعلم المعزز مقابل التعلم الخاضع للإشراف
إن أوضح طريقة لوضع التعلم المعزز هي وضعه بجانب النموذج الذي يعرفه معظم القراء بالفعل.
| المعاملات | تعزيز التعلم | التعلم تحت الإشراف |
|---|---|---|
| أسلوب القرار | يساعدك التعلم المعزز على اتخاذ قراراتك بشكل متسلسل. | في هذه الطريقة، يتم اتخاذ قرار بشأن المدخلات المقدمة في البداية. |
| يعمل على | يعمل من خلال التفاعل مع البيئة. | يعمل على أمثلة أو بيانات عينة معينة. |
| التبعية للقرار | في طريقة التعلم المعزز، يعتمد كل قرار تعلم على القرارات التي تسبقه، لذا فإن التسلسل الكامل للقرارات هو ما يتم تقييمه. | In التعلم تحت إشراف القرارات مستقلة عن بعضها البعض، لذلك يتم إعطاء تسمية لكل قرار. |
| افضل مناسب | يدعم ويعمل بشكل أفضل في مجال الذكاء الاصطناعي، حيث يكون التفاعل البشري سائداً. | يتم تشغيله في الغالب باستخدام نظام برمجي أو تطبيقات تفاعلية. |
| مثال | لعبة الشطرنج | التعرف على الأشياء |
تطبيقات التعلم المعزز
فيما يلي تطبيقات التعلم المعزز:
- الروبوتات للأتمتة الصناعية.
- تخطيط استراتيجية الأعمال
- التعلم الآلي ومعالجة البيانات
- يساعدك ذلك في إنشاء أنظمة تدريب توفر تعليمات ومواد مخصصة وفقًا لمتطلبات الطلاب.
- التحكم في الطائرات والتحكم في حركة الروبوت
لماذا نستخدم التعلم المعزز؟
فيما يلي الأسباب الرئيسية لاستخدام التعلم المعزز:
- يساعدك ذلك في تحديد الموقف الذي يتطلب إجراءً ما.
- يساعدك على اكتشاف الإجراء الذي يحقق أعلى مكافأة على المدى الطويل
- كما يوفر التعلم المعزز للوكيل المتعلم وظيفة مكافأة
- كما يسمح ذلك للوكيل بتحديد أفضل طريقة للحصول على مكافآت كبيرة
متى لا تستخدم التعلم المعزز؟
لا يمكنك تطبيق نموذج التعلم المعزز في كل الحالات. إليك بعض الحالات التي لا يُنصح فيها باستخدامه.
- عندما يكون لديك ما يكفي من البيانات المصنفة لحل المشكلة باستخدام أسلوب التعلم الخاضع للإشراف
- يُعدّ التعلّم المعزز عملية حسابية كثيفة وتستغرق وقتًا طويلاً، لا سيما عندما تكون مساحة الإجراءات كبيرة.
تحديات التعلم المعزز
فيما يلي التحديات الرئيسية التي ستواجهها أثناء تطبيق التعلم المعزز:
- تصميم الميزات والمكافآت، والذي قد يكون معقدًا للغاية
- قد تؤثر المعلمات على سرعة التعلم.
- يمكن أن تتمتع البيئات الواقعية بقابلية ملاحظة جزئية.
- قد يؤدي الإفراط في التعزيز إلى زيادة الحمل على الحالات، مما قد يقلل من النتائج.
- البيئات الواقعية يمكن أن تكون غير ثابتة.
