
监督机器学习: Algorithms、类型和示例
 伊芙琳·克拉克
什么是监督机器学习?
监督式机器学习是一种算法,它通过学习已标记的训练数据来预测未知数据的结果。在监督式学习中,您使用已“标记”的数据来训练机器。这意味着部分数据已被标记为正确答案。这可以比作在监督者或老师的指导下进行学习。
成功构建、扩展和部署精准的监督式机器学习模型需要一支技术精湛的数据科学家团队投入时间和精力。此外,数据科学家还必须定期重建模型,以确保模型产生的洞见能够随着底层数据的变化而保持有效性。
监督学习的工作原理
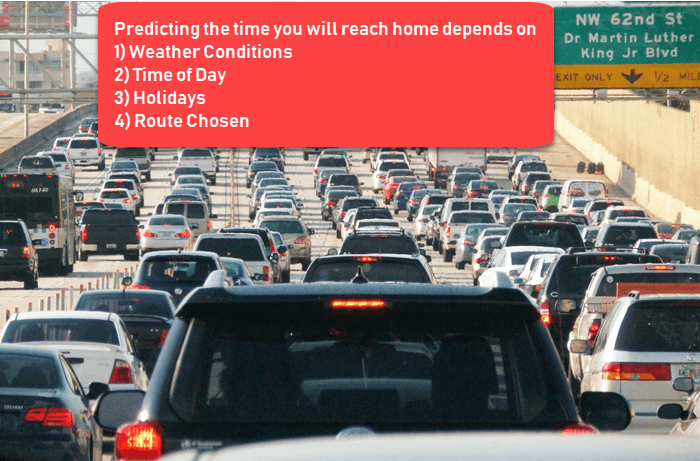
监督式机器学习使用训练数据集来实现预期结果。这些数据集包含输入和正确的输出,有助于模型更快地学习。例如,您想训练一台机器来帮助您预测从工作地点开车回家需要多长时间。
首先,创建一组标记数据。这些数据包括:
- 天气状况
- 一天中的时间
- 假期
- 已选择路线
所有这些细节都是本监督学习示例中的输入。输出结果是当天开车回家所花费的时间,如下图所示。
你本能地知道,如果外面下雨,开车回家就会花更长时间。但机器需要数据和统计信息。
首先,你需要创建一个训练集。它将包含总通勤时间和相关因素,例如天气、时间等。基于这个训练集,你的机器可能会发现降雨量与你回家所需时间之间存在直接关系。
因此,它表明雨下得越大,你开车回家所需的时间就越长。它还可能发现你下班时间和你上路时间之间的联系。你越接近下午6点,到家所需的时间就越长。
您的机器可能会发现一些与您已标注数据相关的关系。学习阶段如下所示。
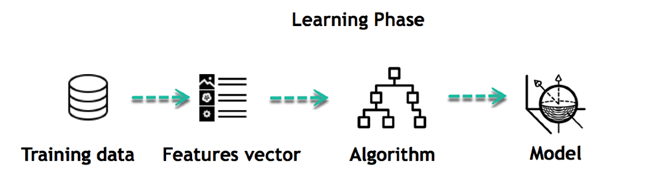
这是你的数据模型的起点。它开始记录降雨如何影响人们的驾驶方式,以及一天中特定时间段的出行人数更多。
监督机器学习的类型 Algorithms
以下是监督机器学习算法的类型:
数据复原测试
回归技术利用训练数据预测单个连续的输出值。
示例:您可以使用回归根据训练数据预测房价。输入变量将是位置、房屋大小等。
优点:输出结果易于解释,并且可以通过正则化算法来避免过拟合。
缺点:线性模型不够灵活,因此如果不添加特征,就无法捕捉复杂的关系。
以下是几种回归类型 Algorithms:
- 线性回归
- 多项式回归
- 岭回归和 Lasso 回归
- 逻辑回归(用于分类)
- 决策树和随机森林回归
- 支持向量回归
逻辑回归:
逻辑回归用于根据一组给定的自变量估计离散值。它通过将数据拟合到逻辑函数来预测事件发生的概率。因此,它也被称为逻辑回归。由于它预测的是概率,其输出值介于 0 和 1 之间,因此当存在多个或非线性决策边界时,其性能可能会下降。
分类
分类是指将输出结果归入某个类别。如果算法尝试将输入标记为两个不同的类别,则称为二元分类。从两个以上的类别中进行选择则称为多类分类。
例如:判断某人是否会拖欠贷款。
优势:分类树在实践中表现非常出色。
缺点:不受约束的单个决策树容易过拟合。
以下是几种分类 Algorithms:
- 朴素贝叶斯分类器
- 决策树
- 支持向量机
- K-最近邻
- 随机森林和梯度提升
朴素贝叶斯分类器
此 朴素贝叶斯 该模型易于构建,并且非常适用于大型数据集。此方法由具有一个父节点和若干子节点的有向无环图组成。它假设子节点与其父节点相互独立。
决策树
决策树通过根据特征值对实例进行分类。在这种方法中,每个节点代表待分类实例的一个特征,每个分支代表该节点可以取的一个特征值。它是一种广泛使用的分类技术。
同样的结构也适用于回归:回归树可以帮助你估计实际值(购车成本、通话次数、每月总销售额等)。
支持向量机
支持向量机(SVM)是20世纪90年代引入的一种学习算法。该方法基于弗拉基米尔·瓦普尼克及其同事开发的统计学习理论的研究成果。
支持向量机(SVM)与核函数密切相关,而核函数是大多数学习任务的核心概念。核框架和SVM被广泛应用于各个领域,包括多媒体信息检索、生物信息学和模式识别。上述每个估计器及其调优参数均已在文档中详细说明。 scikit学习 参考。
监督式机器学习技术与非监督式机器学习技术
将方法放在旁边 无监督学习 明确划定其边界。
| 基于 | 监督机器学习技术 | 无监督机器学习技术 |
|---|---|---|
| 输入数据 | Algorithms 使用标记数据进行训练。 | Algorithms 用于未标记的数据 |
| 计算复杂度 | 监督学习是一种更简单的方法。 | 无监督学习在计算上很复杂 |
| 准确性 | 高度准确且值得信赖的方法。 | Less 准确、值得信赖的方法。 |
| 典型算法 | 逻辑回归、决策树、支持向量机、朴素贝叶斯 | K均值、层次聚类、PCA |
| 如何评判结果 | 与已知答案进行比较评分(准确率、均方根误差) | 根据内部指标和人工审核进行评判 |
监督式机器学习面临的挑战
以下是监督机器学习面临的挑战:
- 训练数据中无关的输入特征会导致不准确的结果。
- 数据准备和预处理始终是一个挑战。
- 当训练数据中包含不可能的、不太可能的或不完整的值时,准确率会受到影响。
- 如果相关专家无法提供帮助,那么另一种方法是“蛮力法”。这意味着你必须猜测要用哪些特征(输入变量)来训练机器,而这种猜测可能并不准确。
监督学习的优势
面对这些挑战,监督式机器学习具有以下优势:
- 监督学习 机器学习 允许您根据以往经验收集数据或生成数据输出。
- 帮助您利用经验优化绩效标准
- 监督机器学习可帮助您解决各种类型的现实世界计算问题。
监督学习的缺点
以下是监督式机器学习的缺点:
- 如果训练集中没有你想要包含在某个类别中的示例,则决策边界可能会过度拟合。
- 在训练分类器时,你需要从每个类别中选择大量好的例子。
- 大数据分类可能是一个真正的挑战。
- 监督学习的训练需要大量的计算时间。
监督学习的最佳实践
以下序列使项目保持运行状态 track:
- 在进行任何其他操作之前,首先要确定要使用哪种类型的数据作为训练集。
- 确定学习函数的结构和学习算法。
- 收集来自专家或测量人员的相应输出结果
- 保留一个模型从未见过的测试数据集,并报告该数据集的得分。
