
如何处理 Web 表 Selenium
 Krishna 伦塔
⚡ 智能摘要
Selenium Web 表格处理允许 QA 工程师使用 XPath、CSS 和 Web 表格从 HTML 行和列中读取表格数据。 Selenium 4. 相对定位符。本文将介绍静态表、嵌套表、属性谓词以及用于动态网格的人工智能技术。
什么是 Web 表 Selenium?
A 网络表 in Selenium 表格是一种用于以表格形式呈现数据或信息的 Web 元素。显示的数据可以是静态的,也可以是动态的。通过 Web 元素方法结合定位器来访问 Web 表格的单元格和行。一个典型的例子是电子商务产品页面上显示的产品规格表格。
读取 HTML 网页表格
测试人员经常需要访问位于 HTML 表格中的元素,通常是文本值。然而,网页设计师很少会为单个单元格提供 id 或 name 属性。因此,诸如 `By.id()`、`By.name()` 或 `By.cssSelector()` 之类的方法很少奏效。在这种情况下,最可靠的选择是 `By.xpath()`,因为它会遍历表格标签内的父子关系。
如何处理 Web 表 Selenium
考虑下面的 HTML 代码来处理 web 表格 Selenium.

我们将使用 XPath的 获取包含文本“第四个单元格”的单元格内部文本。

步骤 1 – 设置父元素(表格)
WebDriver 中的 XPath 定位器始终以双斜杠“//”开头,后跟父元素。。由于我们处理的是 Selenium,父元素应该始终是标签。我们的第一部分 Selenium 因此,XPath 表定位器必须以“//table”开头。

步骤 2 – 添加子元素
正下方的元素是, 所以是……的孩子反之,是以下哪项的父级XPath 中的所有子元素都位于其父元素的右侧,并用一个正斜杠“/”分隔,如下所示。


步骤 3 – 添加谓词
这元素包含两个标签。这两个标签是子元素, 所以是两者的父母。元素之间是兄弟姐妹。 兄弟姐妹是指拥有同一父母的子元素.
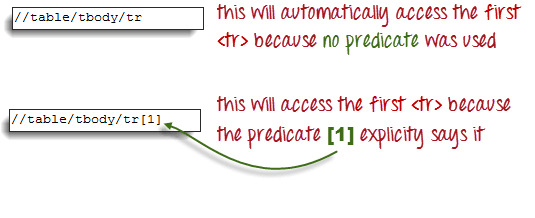
到达要访问包含“第四个单元格”的内容,我们必须首先访问 第二 不是第一个。只写“//table/tbody/tr”会定位到第一个。标签。
那么我们如何获取第二个信息呢?答案是使用 谓词. 谓词是用方括号“[ ]”括起来的数字或HTML属性,用于区分子元素与其同级元素。由于我们需要的是第二行,所以我们使用“[2]”作为谓词。

如果省略谓词,XPath 将返回第一个兄弟节点。因此,以下任一 XPath 代码都将到达第一个兄弟节点。 。
步骤 4 – 使用适当的谓词添加后续子元素
我们需要的下一个要素是第二个应用步骤 2 和 3 中的规则,我们得到如下所示的 XPath。

现在我们有了正确的 XPath 定位器,就可以使用以下代码访问单元格并读取其内部文本。这里假设您已将 HTML 页面保存为 C 盘中的“newhtml.html”文件。

public static void main(String[] args) {
    String baseUrl = "https://demo.guru99.com/test/write-xpath-table.html";
    WebDriver driver = new FirefoxDriver();

    driver.get(baseUrl);
    String innerText = driver.findElement(
        By.xpath("//table/tbody/tr[2]/td[2]")).getText();
    System.out.println(innerText);
    driver.quit();
}
访问嵌套表
同样的原则也适用于嵌套表。 嵌套表是指放置在另一个表内的表。。 一个例子如下所示。


要使用上一节中的父/子关系和谓词概念访问包含文本“4-5-6”的单元格,我们可以编写如下所示的 XPath。

以下 WebDriver 代码检索目标单元格的内部文本。

public static void main(String[] args) {
    String baseUrl = "https://demo.guru99.com/test/accessing-nested-table.html";
    WebDriver driver = new FirefoxDriver();

    driver.get(baseUrl);
    String innerText = driver.findElement(
        By.xpath("//table/tbody/tr[2]/td[2]/table/tbody/tr/td[2]")).getText();
    System.out.println(innerText);
    driver.quit();
}
下面的输出确认内表已被成功访问。

使用属性作为谓词
如果元素位于 HTML 的深处,计算兄弟元素的数量会变得很麻烦,我们可以改用该元素的唯一属性。
在下面的示例中,“纽约到芝加哥”单元格深埋在内部。 Mercury 旅游主页。

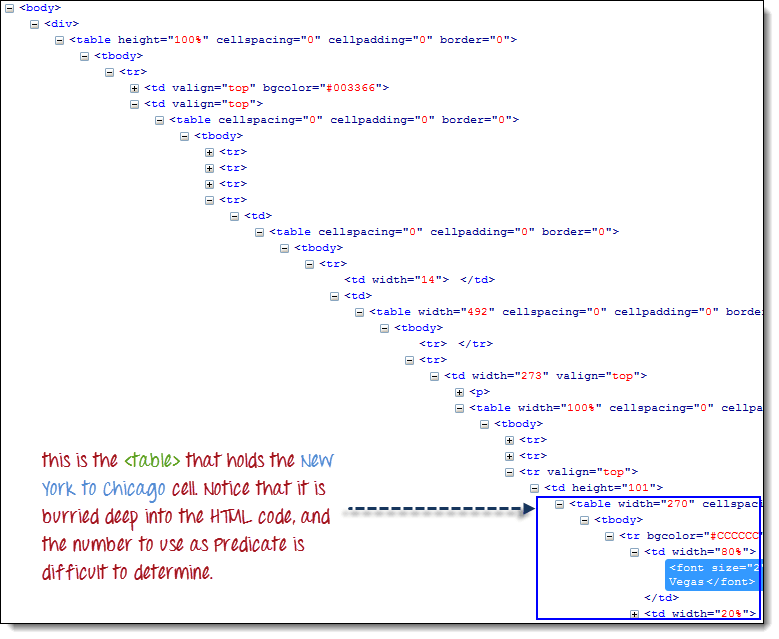
我们可以使用表格的唯一属性(宽度=”270″)作为谓词。 通过在属性前加上 @ 符号,可以将属性用作谓词在上面的例子中,“纽约到芝加哥”单元格位于第一个单元格中。第四因此,我们的 XPath 应该看起来像下面显示的那样。

记住,当你把 XPath 放进去的时候…… Java用反斜杠转义“270”周围的双引号,这样 By.xpath() 字符串就不会提前终止。

我们现在准备使用下面的代码访问该单元格。

public static void main(String[] args) {
    String baseUrl = "https://demo.guru99.com/test/newtours/";
    WebDriver driver = new FirefoxDriver();

    driver.get(baseUrl);
    String innerText = driver.findElement(By
        .xpath("//table[@width=\"270\"]/tbody/tr[4]/td"))
        .getText();
    System.out.println(innerText);
    driver.quit();
}
快捷方式:使用检查元素访问表格 Selenium
如果难以获取元素的索引或属性,生成 XPath 的最快方法是使用现代浏览器开发者工具中的“检查元素”功能。
请看下面的例子 Mercury 旅游主页。

第四步
右键单击目标单元格,选择“检查”以查看 DOM 路径,然后复制完整的 XPath。

第四步
查找第一个“表格”父元素并删除其左侧的所有内容。

第四步
在剩余的 XPath 前面加上双斜杠“//”,然后将其复制到您的 WebDriver 代码中。

以下 WebDriver 代码检索深层嵌套元素的内部文本。

public static void main(String[] args) {
    String baseUrl = "https://demo.guru99.com/test/newtours/";
    WebDriver driver = new FirefoxDriver();

    driver.get(baseUrl);
    String innerText = driver.findElement(By
        .xpath("//table/tbody/tr/td[2]"
        + "//table/tbody/tr[4]/td/"
        + "table/tbody/tr/td[2]/"
        + "table/tbody/tr[2]/td[1]/"
        + "table[2]/tbody/tr[3]/td[2]/font"))
        .getText();
    System.out.println(innerText);
    driver.quit();
}
如何统计动态 Web 表格中的行数和列数
动态 Web 表格(例如仪表板或搜索结果)每次加载时呈现的行数都不同。要处理它们,请使用 findElements 获取所有将数据放入列表中,然后循环遍历并读取每个单元格。以下代码片段统计行数,并读取表中 id 为“customers”的每个单元格。
List<WebElement> rows = driver.findElements(
    By.xpath("//table[@id='customers']//tr"));
System.out.println("Total rows: " + rows.size());

for (int i = 1; i <= rows.size(); i++) {
    List<WebElement> cells = driver.findElements(
        By.xpath("//table[@id='customers']//tr[" + i + "]/td"));
    for (WebElement cell : cells) {
        System.out.println(cell.getText());
    }
}
将定位器包裹起来 WebDriverWait - visibilityOfAllElementsLocatedBy 当表格通过 AJAX 加载时,这可以防止在渲染速度较慢的网格中出现过时的元素引用。
Selenium 4. Web 表格的相对定位符
Selenium 第 4 版引入了相对定位器,它通过视觉位置来定位元素。当行顺序改变导致 XPath 索引失效时,相对定位器非常有用。 above(), below(), toLeftOf(), toRightOf()和 near() 所有方式都接受锚点 WebElement。
import static org.openqa.selenium.support.locators.RelativeLocator.with;

WebElement emailHeader = driver.findElement(By.xpath("//th[text()='Email']"));
WebElement emailCell = driver.findElement(
    with(By.tagName("td")).below(emailHeader));
System.out.println(emailCell.getText());
即使列顺序发生变化,相对定位符仍然清晰可读。在数据驱动型页面上,应将其与显式等待机制结合使用,以获得最佳结果。
用于处理动态网页表格的人工智能工具
人工智能辅助测试平台可减少频繁变化的电网上的定位器维护工作。诸如此类的工具 Testim, 马布尔和 功能化 使用计算机视觉和 DOM 模型来检测列偏移和自愈定位器。它们通过标题文本和单元格相似性来识别行,而不是使用固定的 XPath 索引。
对于纯 Selenium 项目、库等 赫莱尼姆 封装 WebDriver 并在运行时重写损坏的定位器。将这些工具与 WebDriverWait 结合使用,可以保持动态表格脚本的稳定性,而无需在每次 UI 更改后都重写选择器。
结语
- 使用 xpath() 是访问 Web 表格单元格最可靠的方法。 Selenium.
- 如果计算兄弟姐妹数量有困难,可以使用唯一属性作为谓词,并在其前面加上 @ 符号。
- findElements 返回一个列表支持动态表中的行计数。
- Selenium 4 个相对定位器(上方、下方、附近)减少了对位置 XPath 的依赖。
- 在 DevTools 中使用“检查元素”功能可以加快对深层单元格生成 XPath 的速度。
- 人工智能工具,例如 TestimMabl 和 Healenium 是用于改变网格的自愈定位器。
