
什么是强化学习?类型 Algorithms & 例子
 伊芙琳·克拉克
什么是强化学习?
强化学习 是一个意念波· 机器学习 该方法关注软件代理在环境中应如何采取行动。代理不会被直接告知正确答案;它会从获得的奖励中学习,并调整自身行为以最大化累积奖励。
强化学习本身就是机器学习的一个分支,与…… 监督 和 无监督 学习。当智能体的策略或价值函数由神经网络表示时,这种组合被称为 深度强化学习 正是这种配对使得智能体能够在多个步骤中实现复杂的目标或最大化特定维度。
强化学习方法的重要组成部分
在理解算法之前,先给各个组成部分命名很有帮助。下图展示了智能体、环境、动作和奖励信号如何在一个循环中相互配合。
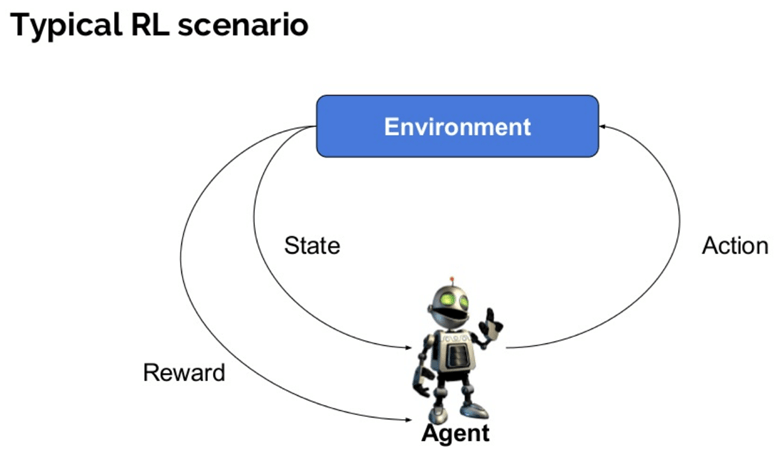
以下是强化学习中使用的一些重要术语:
- 代理人: 在环境中执行动作以获得某种奖励的实体。
- 环境(e): 经纪人必须面对的场景。
- 獎勵 (R): 当代理人执行特定操作或任务时,立即给予的回报。
- 状态): 状态是指环境返回的当前情况。
- 政策(π): 智能体根据当前状态决定下一步行动所采用的策略。
- 值(V): 预期长期折现收益与短期收益的比较。
- 值函数: 它指定一个状态的值,即智能体从该状态开始可以预期积累的总奖励量。
- 环境模型: 这模拟了环境的行为。它使你能够进行推断,并确定环境将如何变化。
- 基于模型的方法: 通过先学习或使用环境模型,然后根据该模型进行规划来解决强化学习问题的方法。
- Q值或动作值(Q): Q 值与 value 非常相似。两者唯一的区别在于 Q 值多了一个参数,即当前动作。
强化学习如何发挥作用?
在任何符号出现之前,一个日常的类比就能使机制变得清晰明了。
设想一下你教猫咪新把戏的情景。
- 由于猫咪不懂英语或其他任何人类语言,我们不能直接告诉它该怎么做。所以,我们采取了另一种策略。
- 我们模拟一种情境,猫会尝试做出各种不同的反应。如果猫的反应符合我们的预期,我们就给它鱼吃。
- 现在,每当这只猫遇到同样的情况时,它都会更加热情地做出类似的动作,期望得到更多的奖励(食物)。
- 这就是猫从积极的经验中获得的关于“该做什么”的学习。
- 与此同时,猫咪也学会了在面对负面经历时不应该做什么。
强化学习的例子
下图将猫的故事映射到正式循环中,其中家庭是环境,鱼是奖励。
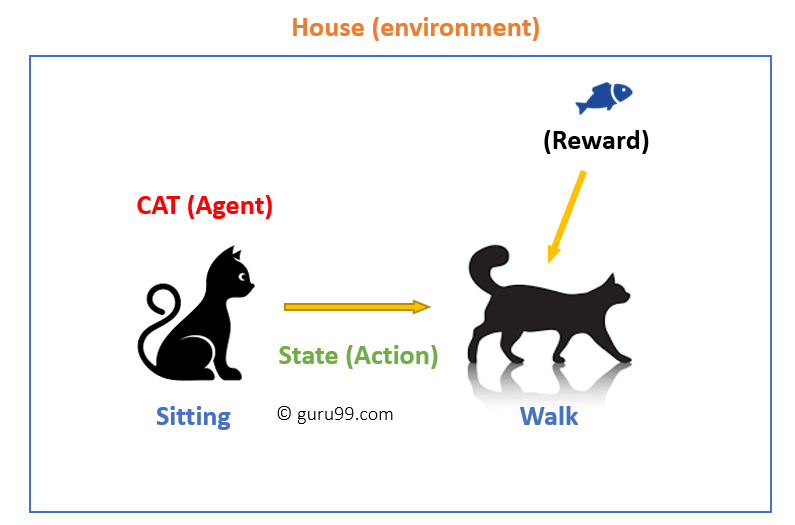
在这种情况下,
- 你的猫是一个暴露于环境中的主体。在这个例子中,环境就是你的房子。例如,你的猫可能处于坐姿,而你用特定的词语让它走动,这就是一种状态。
- 我们的代理通过从一个“状态”到另一个“状态”执行动作转换来做出反应。
- 例如,你的猫从坐姿变成走姿。
- 代理的反应是一种动作,而策略是一种在给定状态下选择动作以期望获得更好结果的方法。
- 过渡完成后,代理人可能会获得奖励或惩罚作为回报。
强化学习 Algorithms
实现强化学习算法有三种方法,它们的主要区别在于智能体存储和学习的内容。
基于价值
在基于价值的强化学习方法中,目标是最大化价值函数 V(s)。在这种方法中,智能体期望在策略 π 下获得当前状态的长期回报。
基于政策
在基于策略的强化学习方法中,你试图制定一个策略,使得在每个状态下执行的动作都能帮助你在未来获得最大的奖励。
两种基于策略的方法是:
- 确定性: 对于任何状态,策略 π 都会产生相同的行动。
- 随机: 每个动作都有一定的概率,由以下公式给出。
随机策略:
π(a|s) = P[At = a | St = s]
基于模型的
在这种强化学习方法中,你需要为每个环境创建一个虚拟模型。智能体学习如何在该特定环境中执行任务。
强化学习的特点
以下是强化学习的重要特征:
- 没有监督者,只有真实的数字或奖励信号
- 顺序决策
- 时间在强化问题中起着至关重要的作用
- 反馈通常是延迟的,而不是即时的。
- Agent 的行为决定了它接收的后续数据
强化学习的类型
“强化”一词借用自行为心理学,它有两种形式:
正面:
它被定义为由特定行为引起的事件。它增强了该行为的强度和频率,并对行为者的行动产生积极影响。
这种强化方式有助于最大限度地提高绩效,并维持更长时间的改变。然而,过度强化可能导致状态过度优化,从而影响结果。
负:
负强化是指由于本应停止或避免的负面条件而导致的行为得到强化。它有助于设定最低绩效标准。然而,这种方法的缺点在于,它提供的强化仅限于满足最低行为标准所需的程度。
强化学习模型
强化学习中有两种重要的学习模型:
- 马尔可夫决策过程
- 问学习
马尔可夫决策过程
使用以下参数来获取解决方案:
- 一系列行动——A
- 状态集 – S
- 奖励 – R
- 政策 – π
- 值 – V
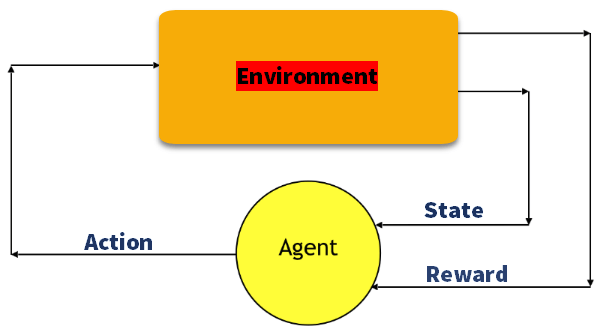
地图的数学方法ping 强化学习中的解决方案被形式化为马尔可夫决策过程(MDP)。下图展示了这五个参数如何连接到同一个智能体-环境循环中。
Q学习
Q学习是一种基于价值的信息提供方法,它告诉智能体应该采取什么行动。
让我们通过以下示例来理解这种方法:
- 一栋楼有五个房间,各房间之间有门相连。
- 每个房间的编号从0到4。
- 建筑物的外部可以视为一个大的室外区域(5)
- 1 号门和 4 号门可从 5 号房间进入大楼
下面这张平面图标出了各个房间的编号,并显示了连接这些房间的门。
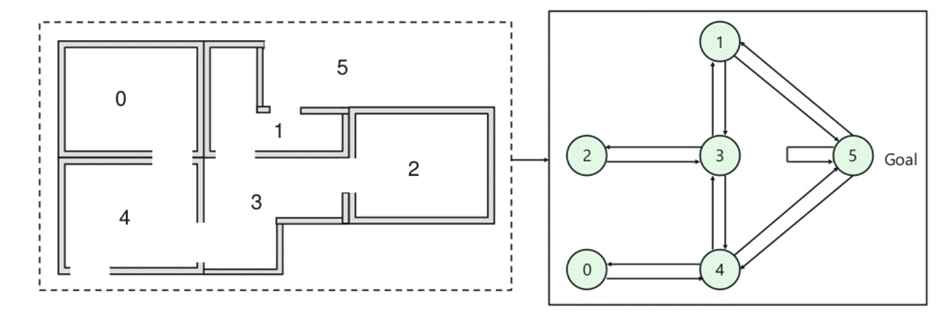
接下来,你需要为每扇门设定一个奖励值:
- 直接通往目标的门的奖励是 100
- 与目标房间没有直接连接的门不会给予任何奖励。
- 由于门是双向的,因此每个房间都分配了两个箭头。
- 上图中每个箭头都带有即时奖励值。
说明: 在这张图中,每个房间代表一种状态,智能体从一个房间移动到另一个房间代表一个动作。
在下图中,状态被绘制成节点,箭头表示可用的动作以及每个动作所附带的奖励。

例如,代理人从 2 号房间走到 5 号房间:
- 初始状态 = 状态 2
- 状态 2-> 状态 3
- 状态 3 -> 状态 (2,1,4)
- 状态 4-> 状态 (0,5,3)
- 状态 1-> 状态 (5,3)
- 状态 0-> 状态 4
强化学习与监督学习
要清晰地理解强化学习,最好的方法是将其与大多数读者已经熟悉的范式放在一起比较。
| 参数 | 强化学习 | 监督学习 |
|---|---|---|
| 决策风格 | 强化学习可以帮助你按顺序做出决策。 | 在这种方法中,是根据一开始给出的输入做出决定的。 |
| 工程 | 通过与环境互动来工作。 | 根据示例或给定的样本数据进行工作。 |
| 取决于决策 | 在强化学习方法中,每个学习决策都取决于之前的决策,因此评估的是整个决策序列。 | In 监督学习 这些决策彼此独立,因此每个决策都有一个标签。 |
| 最适合 | 在人机交互普遍存在的人工智能领域,它能更好地支持和发挥作用。 | 它主要通过交互式软件系统或应用程序进行操作。 |
| 例如: | 棋局 | 物体识别 |
强化学习的应用
以下是强化学习的应用:
- 用于工业自动化的机器人。
- 商业策略规划
- 机器学习和数据处理
- 它可以帮助您创建培训系统,根据学生的需求提供定制化的教学和材料。
- 飞机控制和机器人运动控制
为什么要使用强化学习?
以下是使用强化学习的主要原因:
- 它能帮助你找到需要采取行动的情况。
- 帮助你发现哪些行动能在长期内带来最高回报。
- 强化学习也为学习智能体提供了一个奖励函数。
- 它还允许智能体找出获得高额奖励的最佳方法。
何时不使用强化学习?
并非所有情况下都适用强化学习模型。以下列举了一些不宜使用该模型的情况。
- 当您拥有足够的标记数据,可以使用监督学习方法解决问题时
- 强化学习计算量大且耗时,尤其是在动作空间较大时。
强化学习的挑战
以下是进行强化学习时将面临的主要挑战:
- 功能和奖励设计,这可能非常复杂。
- 参数可能会影响学习的速度。
- 现实环境可以具有部分可观察性。
- 过多的强化可能会导致状态过载,从而降低效果。
- 现实环境可能是非平稳的。
