
CSS 选择器 Selenium
 Krishna 伦塔
⚡ 智能摘要
CSS 选择器 Selenium CSS 选择器是一种强大的定位策略,它使用 HTML 标签、ID、类、属性和内部文本模式来识别元素。本资源通过分步示例解释了每种 CSS 选择器类型。 Selenium IDE。
什么是 CSS 选择器? Selenium?
A CSS 选择器 Selenium CSS 选择器是一种字符串模式,它通过 HTML 标签、ID、类和属性的组合来识别网页元素。CSS 选择器比通过 ID 或名称定位要稍微复杂一些,但它是经验丰富的开发者最常用的策略。 Selenium 用户因为他们可以访问完全没有 ID 或 Name 属性的元素。
CSS 选择器 Selenium 形式多种多样,但本指南重点介绍五种最常用的模式。 Selenium IDE:
- 标签和 ID
- 标签和类别
- 标签和属性
- 标签、类别和属性
- 内文
当使用这种策略时 Selenium IDE,始终在前面加上前缀 Target 带有“css=如下面的每个例子所示。
为什么要使用 CSS 选择器? Selenium?
CSS 选择器是许多应用的首选定位策略。 Selenium 自动化工程师之所以青睐 CSS 选择器,是因为它们兼顾了速度、灵活性和可读性。现代 Web 应用程序通常使用动态生成的 ID 或完全移除 name 属性,因此 CSS 选择器成为定位页面上特定元素的唯一可靠方法。
使用CSS选择器的主要优点包括:
- 性能: CSS 选择器由浏览器的原生引擎处理,因此它们的执行速度比等效的 XPath 表达式更快,尤其是在 Internet Explorer 等较旧的浏览器中。
- 灵活性: 它们结合了标签、类、属性和部分匹配逻辑,使测试人员能够针对缺少稳定 ID 的元素。
- 可读性: 该语法与开发人员编写 CSS 规则的方式类似,这缩短了 QA 工程师和前端团队的学习曲线。
- 跨浏览器稳定性: CSS 选择器在 Chrome 浏览器中的行为保持一致。 FirefoxEdge 和 Safari,减少了不稳定的测试失败。
标签和 ID – CSS 选择器
此示例使用 Facebook 登录页面上的电子邮件文本框。该元素的 ID 为“电子邮件“,并且已经在“按 ID 定位”部分访问过。现在使用以下方式定位同一个元素: Selenium 带有 ID 属性的 CSS 选择器。
句法
css=tag#id
- tag = 正在访问的元素的 HTML 标签
- # = 井号,使用时必须始终存在 Selenium 带 ID 的 CSS 选择器
- id = 正在访问的元素的 ID
请记住,ID 前面始终有一个井号 (#)。
步骤1) 导航 www.facebook.com使用浏览器的开发者工具(或 Firebug 等旧版工具),检查“电子邮件或电话”文本框。
请注意,HTML 标签是“输入”,其 ID 为“电子邮件因此,完整的 CSS 选择器变为“css=输入#电子邮件“。

步骤2) 输入“css=输入#电子邮件“ 进入 Target 一箱 Selenium IDE 并单击“查找”按钮。 Selenium IDE 会高亮显示页面上匹配的元素。

标签和类 – CSS 选择器
CSS 选择器 Selenium 使用 HTML 标签和类名的方法与标签和 ID 的方法相同,只是用点号 (.) 代替了井号 (#)。
句法
css=tag.class
- tag = 正在访问的元素的 HTML 标签
- . = 点号,在使用带有 class 的 CSS 选择器时必须始终存在。
- class = 所访问元素的类
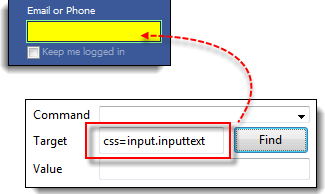
步骤1) 打开演示页面 https://demo.guru99.com/test/facebook.html 并检查“电子邮件或电话”文本框。请注意,HTML 标签是“输入它的类别是“输入文本“。

步骤2) In Selenium IDE,输入“css=input.inputtext“ 在里面 Target 框并单击“查找”。 Selenium IDE能够识别电子邮件或电话号码文本框。
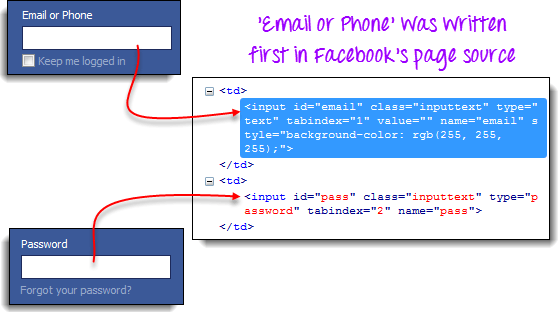
请注意,当多个元素共享同一个 HTML 标签和类时,源代码中只会识别第一个匹配的元素。 检查同一页面上的“密码”文本框,并注意它与“电子邮件”或“电话号码”文本框共享同一个类。

前图中仅突出显示了电子邮件或电话文本框,因为它在页面源代码中排在第一位。
标签和属性 – CSS 选择器
这种策略将 HTML 标签与要访问的元素的特定属性结合起来。
句法
css=tag[attribute=value]
- tag = 正在访问的元素的 HTML 标签
- [ 和 ] 是方括号,用于包裹属性及其对应的值。
- attribute = 要使用的属性。选择一个元素独有的属性,例如 name 或 id。
- value = 所选属性的对应值。
步骤1) 导航到 Mercury 旅游登记页面 https://demo.guru99.com/test/newtours/register.php 检查“姓氏”文本框。注意其 HTML 标签(“input”)及其 name 属性(“lastName”)。

步骤2) In Selenium IDE,输入“css=input[name=姓氏]“ 在里面 Target 框并单击“查找”。 Selenium IDE成功找到“姓氏”字段。

当多个元素共享同一个 HTML 标签和属性时,只有第一个元素会被识别。 该行为与定位具有相同标签和类的元素完全相同。
标签、类和属性 – CSS 选择器
句法
css=tag.class[attribute=value]
- tag = 正在访问的元素的 HTML 标签
- . = 点号,在使用带有 class 的 CSS 选择器时必须始终存在。
- class = 所访问元素的类
- [ 和 ] 是方括号,用于包裹特定属性及其对应的值。
- attribute = 要使用的属性。选择一个元素独有的属性,例如 name 或 id。
- value = 所选属性的对应值。
步骤1) 打开演示页面 https://demo.guru99.com/test/facebook.html 并检查“电子邮件或电话号码”和“密码”输入框。注意它们的 HTML 标签、类和属性。此示例使用“标签索引“ 属性。

步骤2) 首先使用 tabindex 值为 1 访问“电子邮件或电话”文本框。输入“css=input.inputtext[tabindex=1]”成 Selenium IDE的 Target 选中方框,然后单击“查找”。电子邮件或电话号码字段将高亮显示。

步骤3) 要定位到密码输入框,只需替换 tabindex 值。输入“css=input.inputtext[tabindex=2]“ 在里面 Target 框并单击“查找”。 Selenium IDE成功找到密码文本框。

内部文本 – CSS 选择器
HTML 标签很少会设置 id、name 或 class 属性。那么,如何在 HTML 中访问它们呢? Selenium答案就在他们文本的内在含义中。 内部文本是 HTML 标签在页面上显示的实际字符串模式。
句法
css=tag:contains("inner text")
- tag = 正在访问的元素的 HTML 标签
- 内部文本 = 元素的可见文本内容
步骤1) 导航到 Mercury 旅游主页 https://demo.guru99.com/test/newtours/ 检查“密码”标签。注意它的 HTML 标签(本例中为“font”),并观察到该元素没有 class、id 或 name 属性。

步骤2) 类型 css=font:contains(“密码:”) 成 Selenium IDE的 Target 框并单击“查找”。 Selenium IDE 会找到如下所示的密码标签。

步骤3) 这次,将内部文本替换为“Boston”,这样 Target 变成“css=font:contains(“Boston”)点击“查找”。“波士顿到旧金山”标签被高亮显示,表明 Selenium 即使只提供标签内部文本的第一个单词,IDE 也能找到长标签。

CSS 选择器与 XPath 的比较 Selenium
CSS 选择器和 XPath 都用于识别网页元素。 Selenium然而,它们各有优势。下表从关键维度比较了这两种定位策略:
| 标准 | CSS选择器 | XPath的 |
|---|---|---|
| 速度 | 速度更快,运行在浏览器原生引擎上 | 速度较慢,尤其是在旧版浏览器中。 |
| 方向性 | 仅转发(父级到子级) | 向前和向后(子代到父代) |
| 句法 | 更简短,类似于 CSS 规则 | 更长的、分层的路径表达式 |
| 文本匹配 | 仅限于 :contains() 伪类 | 强大的 text() 和 contains() 函数 |
| 最适合 | 静态布局和现代 Web 应用 | 复杂的 DOM 遍历和基于文本的定位器 |
编写 CSS 选择器的最佳实践 Selenium
编写可靠的 CSS 选择器不仅仅是了解语法。以下实践可以帮助测试人员创建稳定、可维护的 CSS 选择器。 Selenium 界面变更后仍然存在的脚本:
- 优先考虑具有独特属性的选项: 始终选择为自动化测试显式添加的 id、data-test-id 或 name 属性。即使视觉布局发生变化,这些属性也保持稳定。
- 避免选择器嵌套过深: 长链,例如
div > div > ul > li > a当开发者重构标记时,要尽量避免出错。选择器应尽可能简短。 - 明智地使用部分匹配: 诸如
[class*="btn-primary"]可以容忍小的类名更改,但也可能匹配到意料之外的元素。 - 避免使用基于索引的定位器: 选择器
nth-child(3)它们很脆弱,因为添加兄弟元素会改变所有元素的位置。 - 在开发者工具中验证选择器: 在运行之前 Selenium 脚本中,将选择器粘贴到 Chrome 开发者工具控制台中。
document.querySelector()确认它只返回一个元素。 - 结合不同属性以实现唯一性: 当多个元素共享一个类时,添加属性过滤器,例如:
input.form-control[name="email"]消除目标歧义。 - 记录和再利用: 将选择器集中在页面对象类中,以便一次更新即可修复引用同一元素的所有测试。
遵循这些准则可以减少不稳定性,提高测试执行速度,并使 Selenium 套房更容易长期维护。
摘要:CSS 选择器语法快速参考
下表汇总了所有信息 Selenium 本指南涵盖的 CSS 选择器模式:
| 付款方式 | Target 句法 | 例如: |
|---|---|---|
| 标签和 ID | css=标签#id | css=输入#电子邮件 |
| 标签和类别 | css=标签.class | css=input.inputtext |
| 标签和属性 | css=标签[属性=值] | css=input[name=姓氏] |
| 标签、类别和属性 | css=tag.class[属性=值] | css=input.inputtext[tabindex=1] |
| 内文 | css=tag:contains(“text”) | css=font:contains(“密码:”) |
