
Hive Join & SubQuery 教程及示例
 大卫卡特
连接查询
可以对存在于以下两个表中的两个表执行连接查询: 蜂房为了更清楚地理解连接的概念,我们在这里创建两个表:
- 示例连接(与客户详细信息相关)
- sample_joins1(与员工提交的订单详情相关)
步骤1) 创建名为“sample_joins”的表,其中包含员工的 Id、Name、Age、address 和 salary 列。下图显示了 CREATE TABLE 语句及其确认信息。

步骤2) 正在加载和显示数据。下一张截图显示了加载命令以及表格内容。
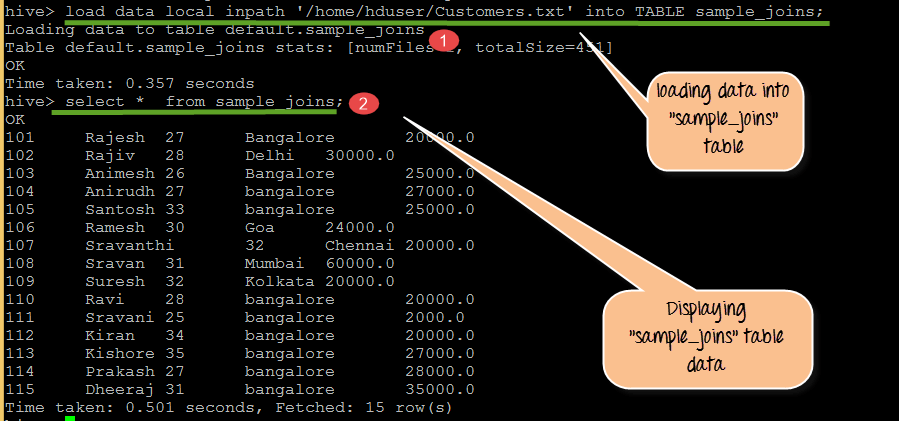
从上面的截图中可以看出:
- 将数据从 Customers.txt 加载到 sample_joins 中
- 显示 sample_joins 表内容
步骤3) 创建 sample_joins1 表,然后加载并显示其数据,如下面的屏幕截图所示。

从上面的截图中,我们可以看到以下内容:
- 创建名为 sample_joins1 的表,其中包含 Orderid、Date1、Id 和 Amount 列。
- 将数据从 orders.txt 加载到 sample_joins1 中
- 显示 sample_joins1 中的记录
接下来,我们将了解可以对已创建的表执行的不同类型的连接。在此之前,您需要考虑以下关于连接的要点。
连接操作中需要注意的一些要点:
- 连接中只允许等值连接。
- 可以在同一个查询中连接两个以上的表
- LEFT JOIN、RIGHT JOIN 和 FULL OUTER JOIN 的存在是为了更好地控制 ON 子句,尤其是在没有匹配项的情况下。
- 连接不满足交换律
- 无论是左连接还是右连接,连接都是左关联的
等式限制反映了 Hive 多年来的固有特性。从 Hive 2.2.0 开始,ON 子句支持复杂表达式(HIVE-15211),因此当前版本接受非等式条件。在较早的版本中,条件必须是等式测试,其他任何条件都必须移至 WHERE 子句中。
不同类型的连接
连接共有 4 种类型,分别是:
- 内部联接
- 左外连接
- 右外连接
- 全外连接
下面针对相同的两个表格演示了每种类型,因此示例之间唯一的变化是保留了哪些不匹配的行。
内部联接
通过此内连接,将检索两个表中共有的记录。以下屏幕截图中的结果仅包含订单匹配的客户。

从上面的截图中,我们可以看到以下内容:
- 这里我们使用 JOIN 关键字在表 sample_joins 和 sample_joins1 之间执行连接查询,匹配条件为 (c.Id = o.Id)。
- 输出结果显示两个表中存在的共同记录,这些记录是通过检查查询中提到的条件而选择的。
查询:
SELECT c.Id, c.Name, c.Age, o.Amount FROM sample_joins c JOIN sample_joins1 o ON(c.Id=o.Id);
左外连接
- 蜂巢QL 即使右表中没有匹配项,LEFT OUTER JOIN 也会返回左表中的所有行。
- 如果 ON 子句在右表中匹配到零条记录,则连接操作仍然会在结果中返回一条记录,该记录在右表的每一列中都为 NULL。
下面的截图显示所有顾客都会出现,包括那些没有下单的顾客。

从上面的截图中,我们可以看到以下内容:
- 这里我们使用“LEFT OUTER JOIN”关键字对表 sample_joins 和 sample_joins1 执行连接查询,匹配条件为 (c.Id = o.Id)。例如,这里我们使用员工 ID 作为引用;它会检查该 ID 是否同时存在于右表和左表中。它充当匹配条件。
- 输出结果显示了符合查询条件的记录。上述输出中的 NULL 值表示来自正确表(即 sample_joins1)的列没有值。
查询:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c LEFT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
右外连接
- 即使左表中没有匹配项,HiveQL RIGHT OUTER JOIN 也会返回右表中的所有行。
- 如果 ON 子句在左表中匹配到零条记录,则连接操作仍然会在结果中返回一条记录,该记录在左表的每一列中都为 NULL。
- 右连接总是返回右表中的记录以及左表中匹配的记录。如果左表中没有与该列对应的值,则该位置将返回 NULL 值。
下面的截图显示了之前结果的镜像:所有订单都会显示出来,无论是否匹配。

从上面的截图中,我们可以看到以下内容:
- 这里我们使用“RIGHT OUTER JOIN”关键字在表 sample_joins 和 sample_joins1 之间执行连接查询,匹配条件为 (c.Id = o.Id)。
- 输出结果显示根据查询中提到的条件选择的记录。
查询:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c RIGHT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
完全外部加入
它根据查询中给出的 JOIN 条件,将表 sample_joins 和 sample_joins1 中的记录合并在一起。
它会返回两个表中所有记录,并将两侧缺少匹配值的列填充为 NULL 值,如下面的屏幕截图所示。

从上面的截图中,我们可以看到以下内容:
- 这里我们使用“FULL OUTER JOIN”关键字在表 sample_joins 和 sample_joins1 之间执行连接查询,匹配条件为 (c.Id = o.Id)。
- 输出结果显示两个表中所有符合查询条件的记录。输出结果中的 NULL 值表示两个表中相应列的缺失值。
查询:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c FULL OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
子查询
连接操作将表并排排列。子查询则不同:它将一个查询嵌套在另一个查询中,以便外部查询可以利用已计算出的结果。
嵌套在主查询中的查询称为子查询。主查询会依赖于子查询返回的值。
子查询可以分为两种类型:
- FROM 子句中的子查询
- WHERE 子句中的子查询
何时使用:
- 获取由不同表中的两个列值组合而成的特定值
- 一个表的值对其他表的依赖关系
- 将一列的值与其他表进行比较检查
语法:
Subquery in FROM clause
SELECT <column names 1, 2…n>From (SubQuery) <TableName_Main >
Subquery in WHERE clause
SELECT <column names 1, 2…n> From<TableName_Main>WHERE col1 IN (SubQuery);
计费示例:
SELECT col1 FROM (SELECT a+b AS col1 FROM t1) t2
这里,t1 和 t2 是表名。内部语句是对表 t1 执行的子查询。a 和 b 是子查询中添加的列,它们被赋值给 col1。col1 是主表中存在的列值。子查询中的列“col1”与主表中 col1 列的查询结果相同。
嵌入自定义脚本
子查询仅使用 HiveQL 重塑数据,而嵌入式脚本则将行传递给 Hive 外部编写的代码。
Hive 允许用户根据客户需求编写自定义脚本。用户可以根据这些需求编写自己的 Map 和 Reduce 脚本,这些脚本被称为嵌入式自定义脚本。自定义脚本中定义了编码逻辑,我们可以在 ETL 阶段使用该脚本。
何时选择嵌入式脚本:
- 当客户特定需求意味着开发人员需要使用 Hive 编写和部署脚本时
- 当 Hive 内置函数无法满足特定领域需求时,可以执行以下操作。
为此,Hive 使用 TRANSFORM 子句来嵌入 map 和 reducer 脚本。
在这些嵌入式自定义脚本中,我们需要注意以下几点:
- 列数据在传递给用户脚本之前,将被转换为字符串并以制表符分隔。
- 用户脚本的标准输出将被视为以制表符分隔的字符串列。
嵌入式脚本示例:
FROM (
	FROM pv_users
	MAP pv_users.userid, pv_users.date
	USING 'map_script'
	AS dt, uid
	CLUSTER BY dt) map_output

INSERT OVERWRITE TABLE pv_users_reduced
	REDUCE map_output.dt, map_output.uid
	USING 'reduce_script'
	AS date, count;
从上面的脚本中,我们可以观察到以下几点。这只是一个用于理解的示例脚本。
- pv_users 是用户表,其中包含 map_script 中提到的 userid 和 date 等字段。
- reducer 脚本是根据 pv_users 表的日期和计数定义的。
